2026年的 AI 圈,最受关注的并非中美技术博弈,也不是大厂与创业公司的相互较劲,而是一场贯穿行业底层的“路线分歧”——闭源阵营忙着搭建壁垒、掌控定价权,开源阵营则选择公开技术底牌、抢占市场空间。这场较量早已不只是技术层面的选择,更演变成一场关乎行业利润分配、话语权归属的核心商战。
闭源的“甜蜜陷阱”:好用,但更贵、更受限
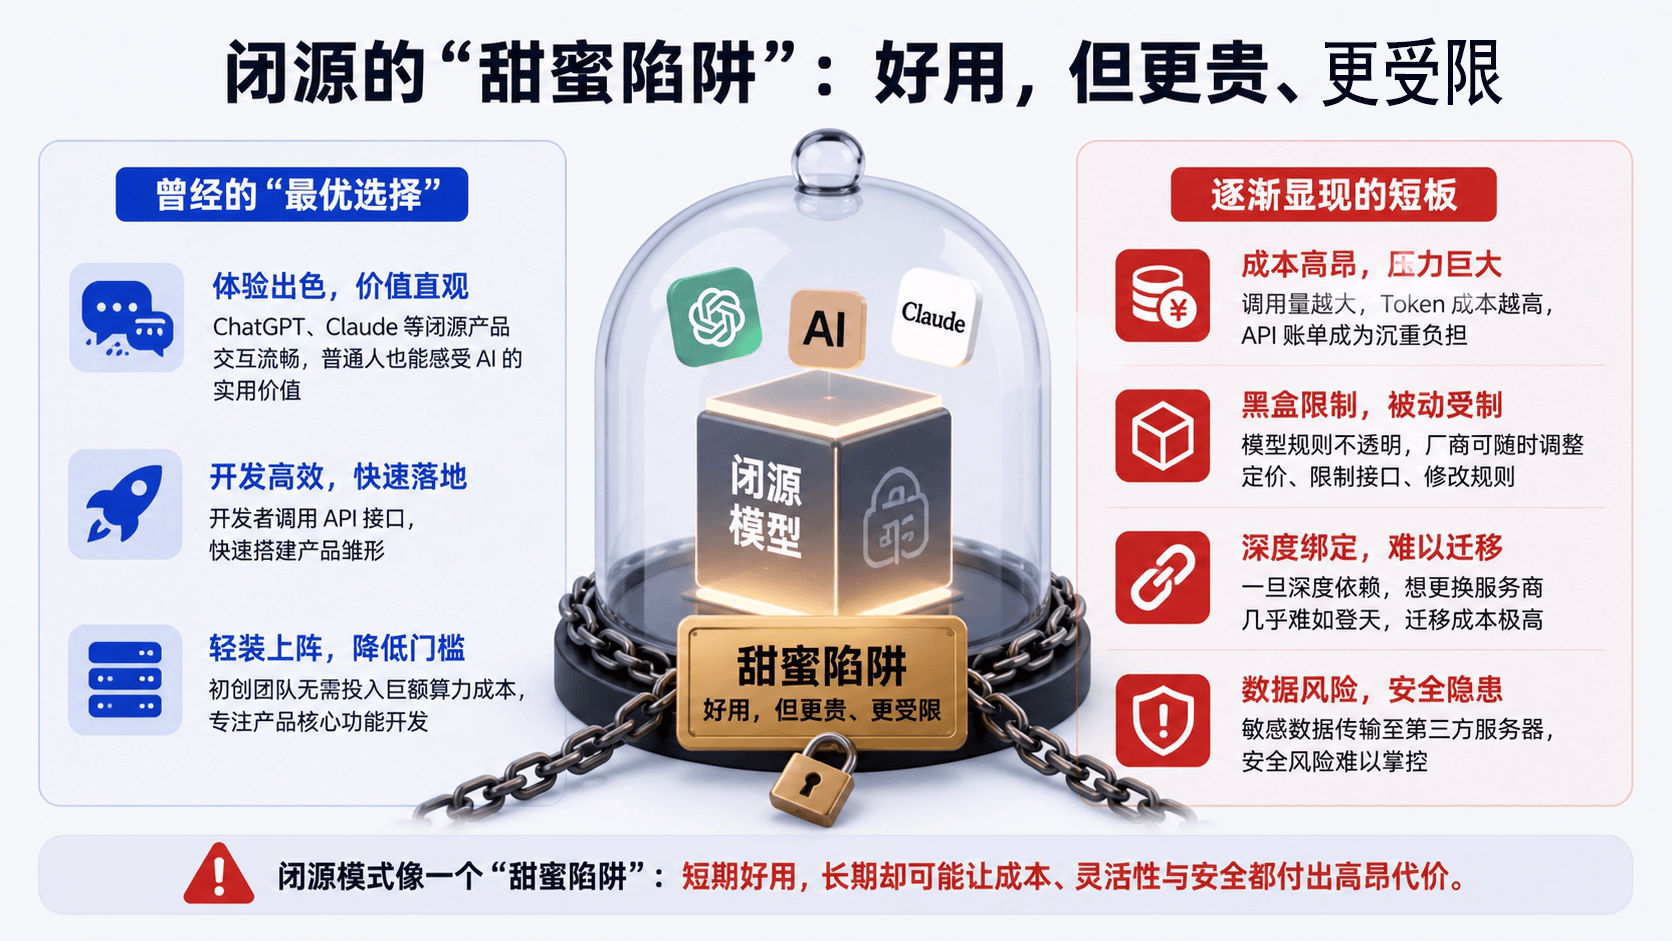
闭源模型曾是 AI 应用开发的“最优选择”。ChatGPT、Claude 等闭源产品凭借流畅的交互体验,让普通人轻松感受到 AI 的实用价值,也帮开发者快速搭建起产品雏形。对于初创团队来说,无需投入巨额算力成本,只需调用 API 接口就能实现核心功能,这种“轻装上阵”的模式,一度推动了 AI 应用的快速普及。
但随着应用落地推进,闭源模式的短板逐渐显现。最直接的就是成本压力——调用量越大,Token 相关成本越高,不少开发者发现,产品刚有起色,API 账单就成了难以承受的负担。更关键的是,闭源模型的“黑盒”特性让开发者陷入被动:厂商随时可能调整定价、限制接口使用、修改模型规则,一旦深度绑定,想更换服务商几乎难如登天。对于涉及敏感数据的企业来说,数据传输至第三方服务器的安全隐患,更是悬在头上的达摩克利斯之剑。
开源的“逆袭之路”:不完美,但更自由、更可控
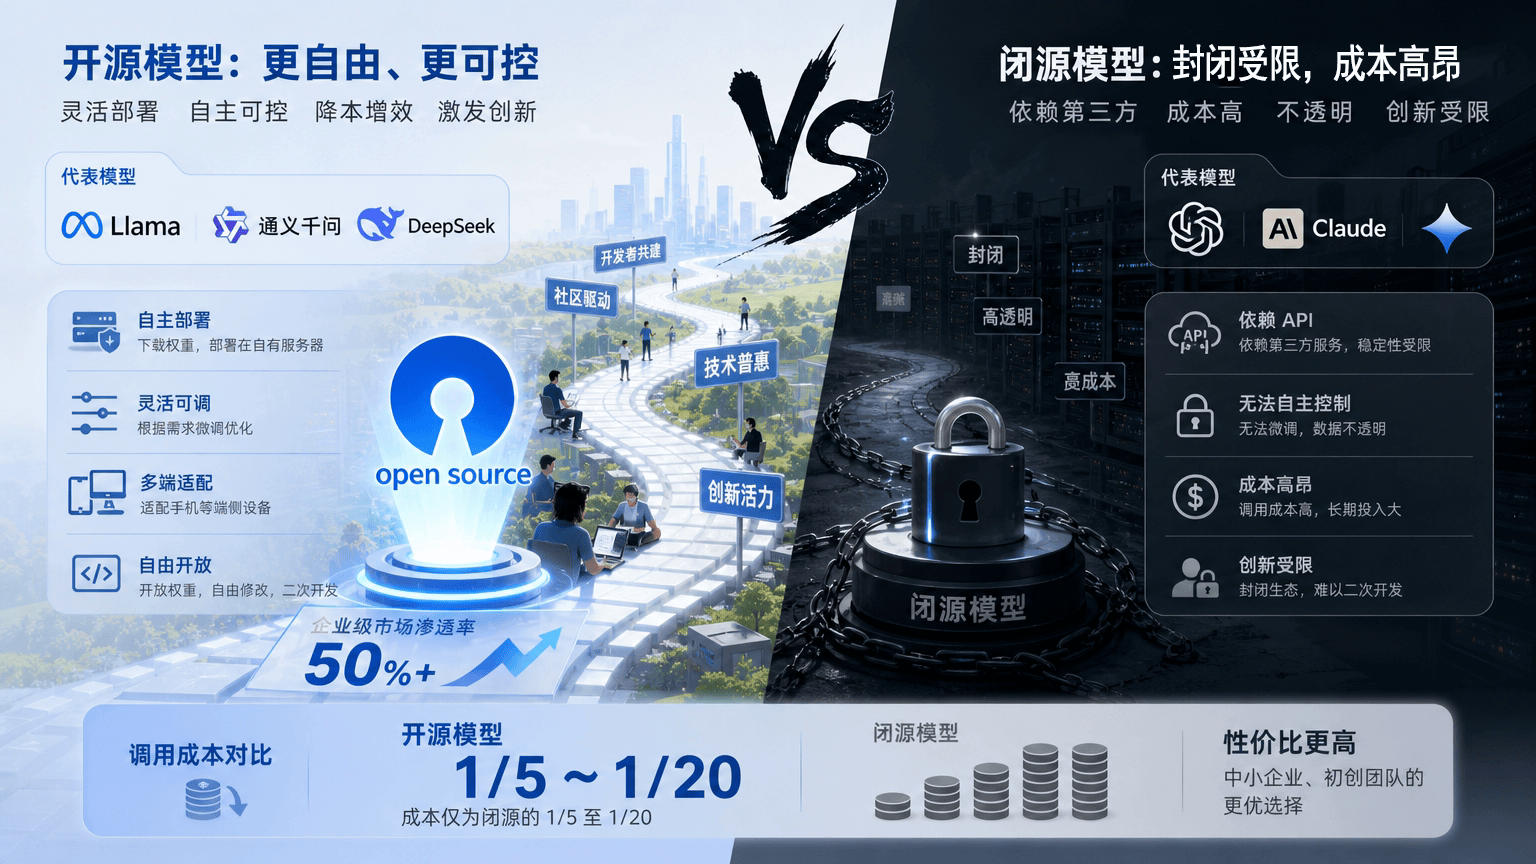
就在闭源阵营忙着收割市场利润时,开源阵营正迎来逆势发展。从 Llama 系列到国内的通义、DeepSeek,越来越多的开源模型开放权重,为企业和开发者提供了第二种选择。这些模型未必在每一项性能指标上都超越闭源产品,但胜在灵活可控——可以下载部署在自有服务器,能根据实际需求微调优化,甚至能适配手机等端侧设备,彻底摆脱对第三方 API 的依赖。
性价比是开源模型最核心的优势。有数据显示,开源模型的调用成本仅为闭源的1/5至1/20,对于预算有限的中小企业和初创团队来说,这无疑是降本增效的关键。更重要的是,开源模式打破了技术垄断,让 AI 技术不再是少数大厂的专属,开发者可以自由修改、二次开发,有效激发了整个行业的创新活力。如今,开源模型在企业级市场的渗透率已突破50%,正逐步挤压闭源产品的市场空间。
算力泡沫下的真相:谁在为高成本买单?
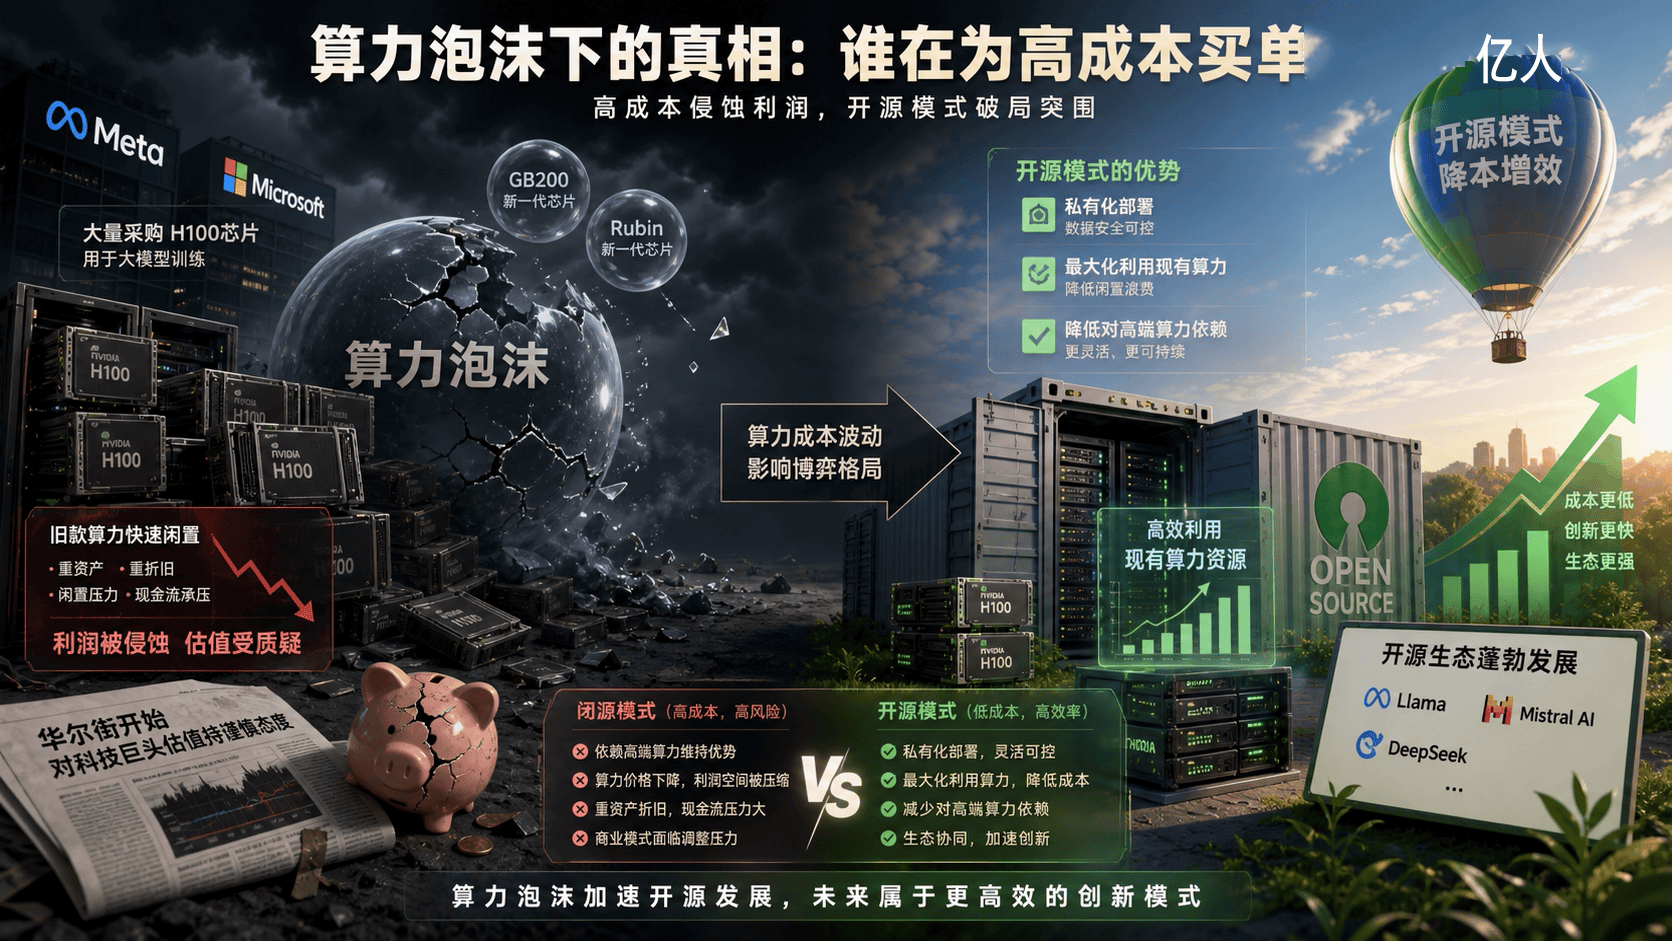
这场路线之争的背后,还藏着算力行业的残酷现实。前两年,Meta、微软等大厂大量采购 H100芯片,用于大模型训练,可随着 GB200、Rubin 等新一代芯片问世,旧款算力很快出现闲置。算力行业属于重资产、重折旧领域,刚性的折旧成本叠加闲置压力,正在侵蚀大厂的利润和现金流,连华尔街都开始对这类企业的估值持谨慎态度。
算力成本的波动,直接影响着闭源与开源的博弈格局。闭源厂商依赖算力成本维持定价优势,一旦算力价格下降,其利润空间将被大幅压缩;而开源模式则能通过私有化部署,最大化利用现有算力资源,降低对高端算力的依赖。可以说,算力行业的泡沫化,正在加速开源模型的发展,也迫使闭源阵营重新调整商业模式。
终局预判:不是谁吃掉谁,而是各司其职的长期共存
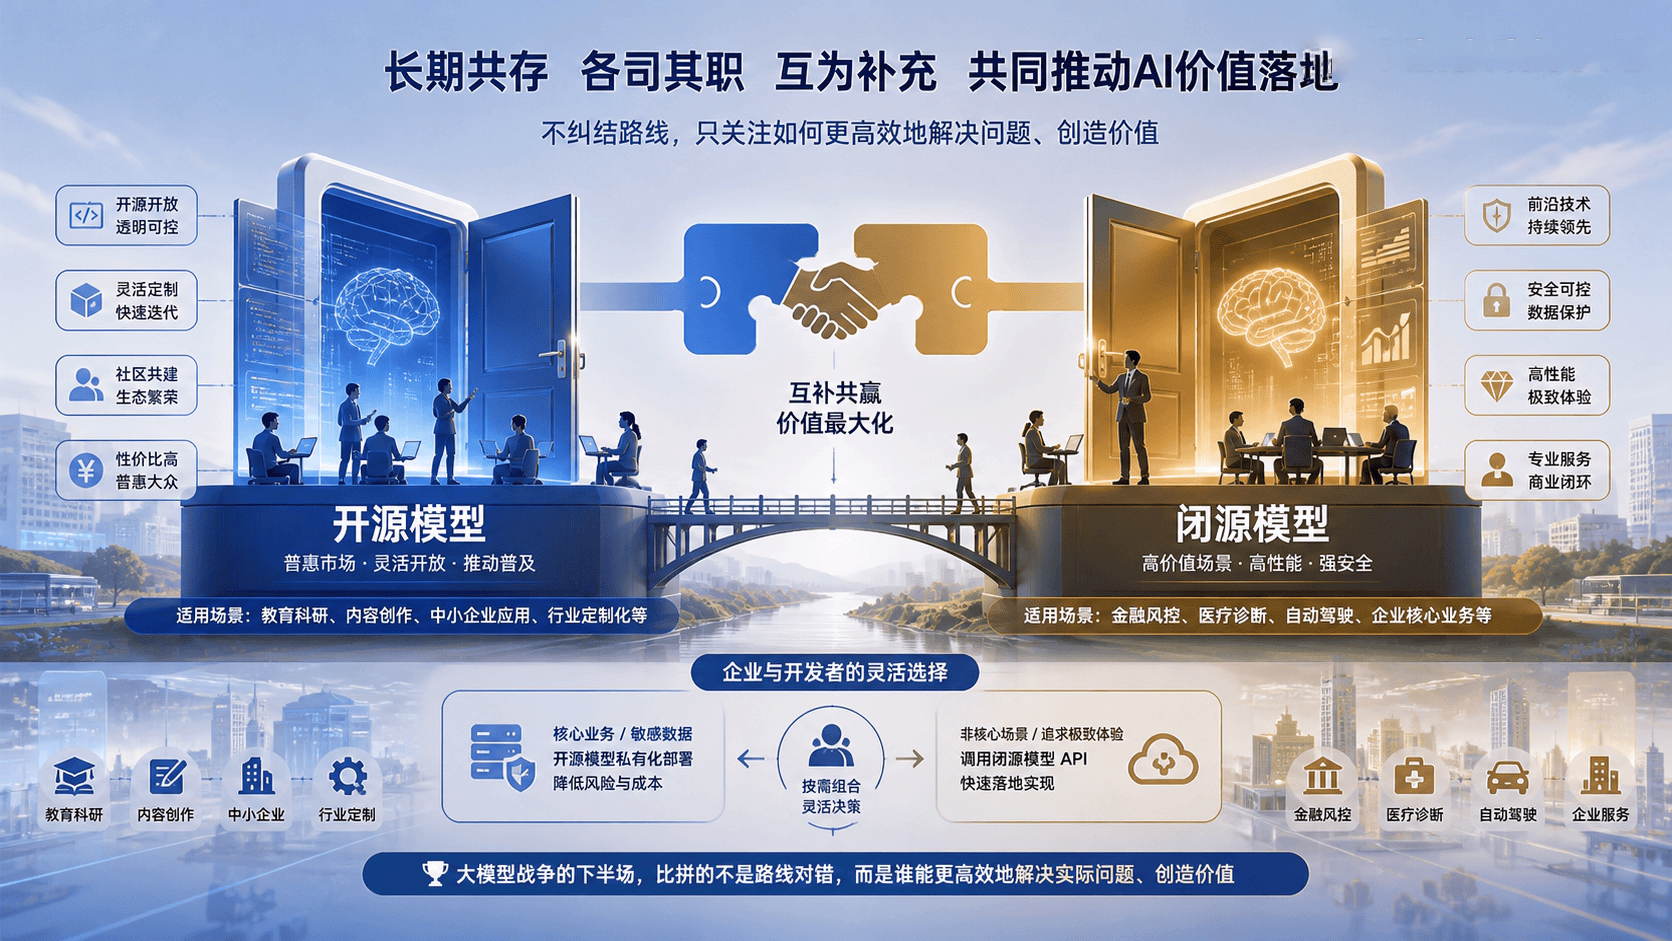
有人认为,开源终将取代闭源;也有人觉得,闭源的技术壁垒难以撼动。但从行业发展趋势来看,两者更可能走向长期共存、各司其职的格局。闭源模型将继续深耕前沿技术,聚焦高价值场景,为对性能、安全性有极致要求的客户提供服务;而开源模型则会凭借性价比和灵活性,占据普惠市场,推动 AI 技术的普及与下沉。
对于开发者和企业而言,与其纠结选择闭源还是开源,不如根据自身需求灵活决策。核心业务、敏感数据可采用开源私有化部署,降低风险和成本;非核心场景、追求极致体验的功能,可借助闭源 API 快速落地。毕竟,大模型战争的下半场,比拼的不是路线对错,而是谁能更高效地解决实际问题、创造价值。
这场关乎 AI 行业未来的较量仍在继续。闭源筑墙,开源破局,最终受益的,将是整个 AI 行业和每一个拥抱技术创新的从业者。返回搜狐,查看更多