DINOv3概述
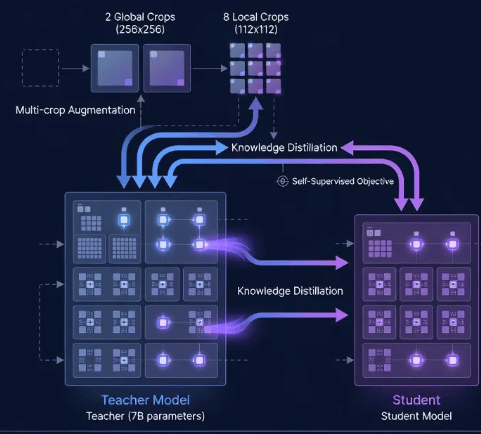
DINOv3是Meta AI于2025年推出的第三代自监督视觉基础模型,采用Vision Transformer(ViT)架构,在16.89亿张未标注图像上通过教师-学生蒸馏训练而成。对于ViT-B/16变体,模型可生成768维embedding向量,能够同时捕获全局图像语义和来自16x16像素图像块的细粒度局部纹理信息。其引入的Gram锚定技术可在长时间训练中保持密集特征质量,而旋转位置embedding(RoPE)则支持高达4096x4096像素的高分辨率图像处理。
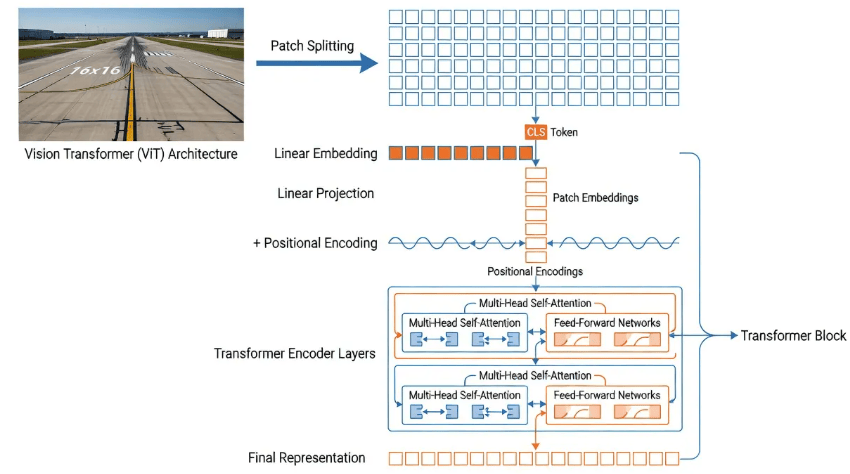
DINOv3在ImageNet-1k线性探针上达到85.1%的Top-1准确率,在ADE20K语义分割上达到54.2% mIoU,相比DINOv2分别提升1.6个百分点和6.1个百分点,展现出作为工业缺陷检测通用视觉主干网络的强大潜力。
监督学习
常用的方法包含全量微调、LoRA微调、冻结主干的线性探针微调。
全量微调的好处
在RGB工业缺陷检测任务中,DINOv3作为初始化权重进行全量微调后,相比监督式ImageNet预训练能够实现更快的收敛速度和更好的最终性能,特别是在语义分割和实例级定位任务上优势明显
LoRA微调的好处
采用低秩适配(LoRA)等方法,仅训练少量参数而保持骨干网络冻结,标注样本有限(500-5,000张)、需要快速适配新缺陷类型。
冻结主干微调
冻结DINOv3全部权重,仅在提取的768维CLS令牌嵌入之上训练一个线性分类器。以5类表面分类任务为例,仅需训练768×5=3,840个参数,在CPU上数分钟即可收敛,样本极少(每类50-200张)、目标域与DINOv3预训练数据分布接近。
无监督方法
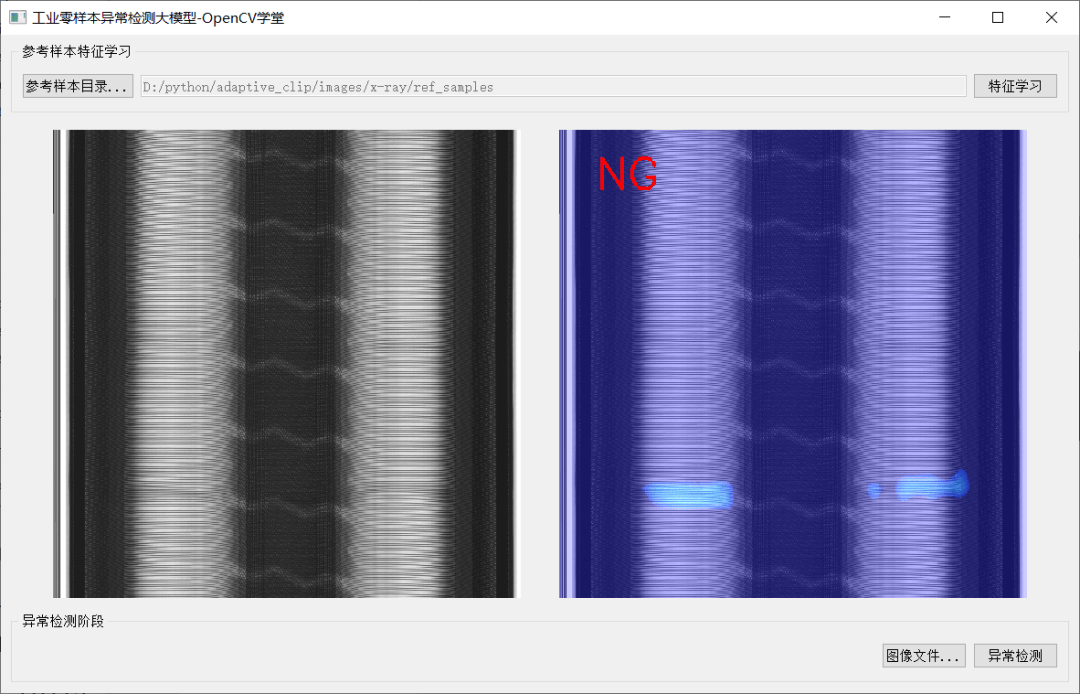
仅使用正常样本的DINOv3 特征embeding向量构建参考特征库,通过计算新样本特征与参考分布的偏离程度检测异常。FAISS向量检索可实现百万级嵌入库的毫秒级相似度搜索。
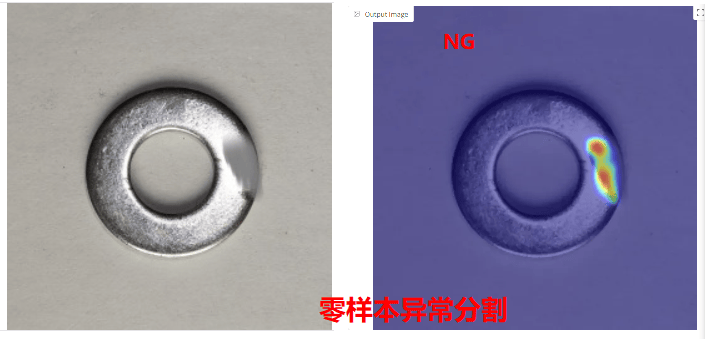
选择支撑图像:当一个待检测的查询图像到来时,首先在全部正常的训练图像中,通过全局(CLS)嵌入的余弦相似度,找到与查询图像整体语义最相似的一张或几张正常图像作为“支撑集”(Support Set)。这一步是为了找到特征空间中最接近的“正常参照物”。
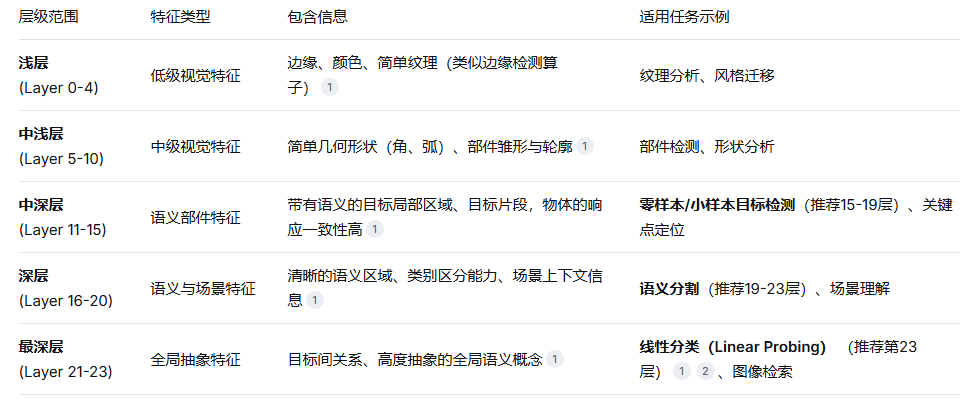
构建正常特征原型:从选定的支撑图像中提取DINOv3的中间层密集补丁特征。为排除背景干扰,通常会利用支撑图的前景掩码,仅对前景区域进行K-means聚类,得到K个聚类中心。这些聚类中心就代表了正常样本的“特征原型”(Normal Prototypes),有效建模了正常特征的多模态分布。
计算异常热力图:提取查询图像的补丁特征,计算每个补丁特征与上一步得到的K个正常原型之间的余弦相似度(Cosine Similarity)。与所有原型相似度都低的补丁区域,即为异常区域,最终生成像素级的异常热力图
关键提示:用那些层的特征有技巧
单纯使用最后一层并非最优。综合使用多个中间层特征,或同时利用CLS令牌(用于匹配)和中间层补丁令牌(用于定位),是当前更优的策略
小样本异常特征比对
利用DINOv3的patch embedding嵌入构建缺陷原型向量,通过余弦相似度进行快速匹配。操作流程如下:
该方法对新型缺陷可实现89-93%的检测准确率,无需任何重训练或微调,特别适合现场检测中遇到的未知缺陷类型。
总结
模态泛化限制:
DINOv3的优势主要集中在RGB图像任务上。在X射线等强模态偏移场景下,监督式ImageNet预训练在冻结和全量微调两种设置中均更为有效。
冻结特征提取的局限:
DINOv3作为冻结特征提取器时,并不总能一致性地优于传统ImageNet预训练。其真正价值在于作为全量微调的初始化权重,而非通用的冻结描述符。
领域特异性需求:
由于工业图像的视觉模式往往由特定材料、采集设置和非标准模态决定,未来需要发展面向工业领域的专用自监督预训练,以构建与真实工业环境更匹配的基础模型
2026年 DINOv3在工业缺陷检测领域的优势在于真正意义上的“零样本”,无需针对特定任务训练,灵活度高,可应对开放词汇描述的新缺陷。工业支持急速五分钟换型、四张参考样本准确率可以达到99%。系统化学习多模态与VLM视觉语言模型,扫码下面的视频教程返回搜狐,查看更多