智猩猩AI整理
编辑:金水
9 月 15 日,新国产团队PhAI Labs开源了科研智能体ScienceBuddy,相关论文登上了Hugging Face日榜。
这是一家专注于下一代人工智能前沿研究的 Neo Lab。创始团队由斯坦福大学、牛津大学、普林斯顿大学等强 AI 背景科学家组成(包括高校教授、大厂研究员等)。
和多数"训完就定稿"的 Agent 不同,ScienceBuddy 把研究者的提问、反馈和真实执行记录,直接转化成可训练的任务和评分标准,让智能体在持续协作里不断变强。
这次团队提出的核心是一套叫“嵌套的递归自我改进"(recursive-in-recursive self-improvement)的范式:内层递归固定模型、只改"工作手册"(harness);外层递归固定工作手册、反过来训练模型本身。两层嵌套耦合,形成自我进化的闭环。
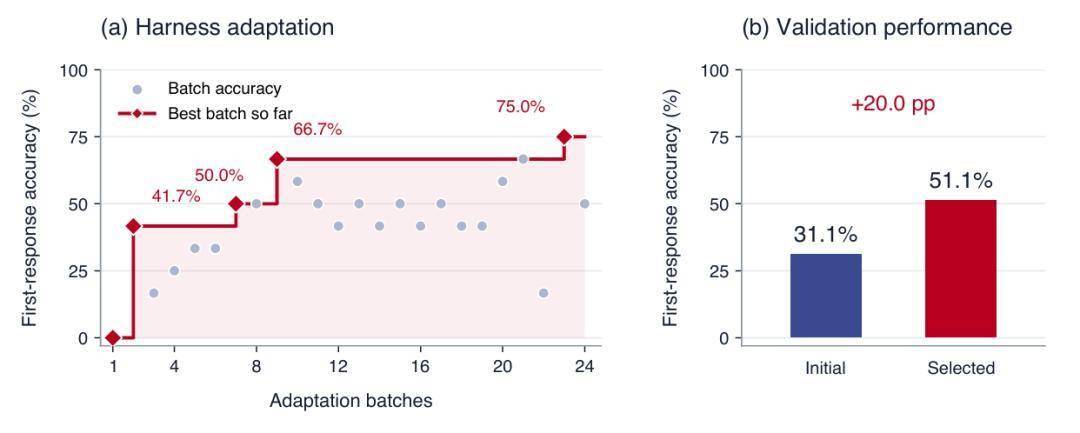
最终,在四类科学任务(文献阅读、数据库判断、实验流程排错、基因与变异评估)共 895 个任务上,ScienceBuddy 验证了这套机制的两个独立环节:固定模型只改手册,首答准确率从 31.1% 提升到 51.1%;固定手册只训模型,问题覆盖率(pass@4)从 48.3% 提升到 67.8%。
其中,固定模型只改手册带来了 20 个百分点的提升;随后固定手册只训模型,又带来 19.5 个百分点的增长。
论文题目:
ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents
01 科研工作台打底,
ScienceBuddy 先搭好"环境"
ScienceBuddy 首先是一个交互式科研工作台。
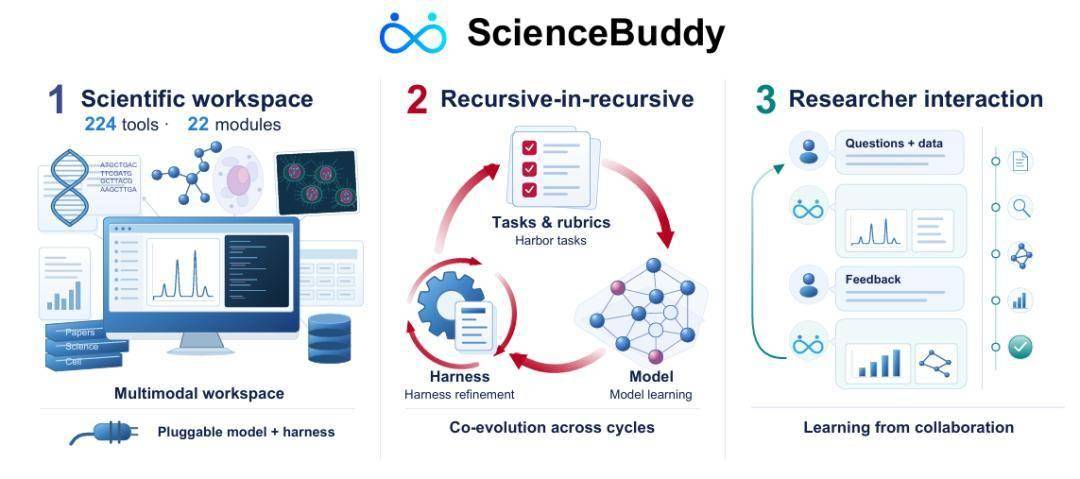
团队把科研场景需要的工具整合到一起,224 个工具、覆盖 22 个功能模块,横跨基因组学、分子与癌症生物学、药理学、生物成像、文献检索和数据库查询。运行时支持 Python、R 和 Bash,配套在线数据库接口和一个本地数据湖。
研究者可以带着问题和数据进来,在工作台里提问、上传文件、查看执行轨迹和产出物,再跟进一轮轮的追问与修正。
在这个底座之上,ScienceBuddy 把"智能体工作手册"(harness)和底层基础设施解耦:指令、可复用技能、上下文管理这些"可编辑组件"单独抽出来,便于被显式地修改和评估。
基座模型则保持可插拔,案例里用 Qwen3.5-4B 作为任务模型,GPT-6 Astra 负责诊断与改手册,Qwen3.8-27B 辅助模拟研究者反馈。
02 递归套递归:
先改手册,再训模型
ScienceBuddy 的进化分两层递归。
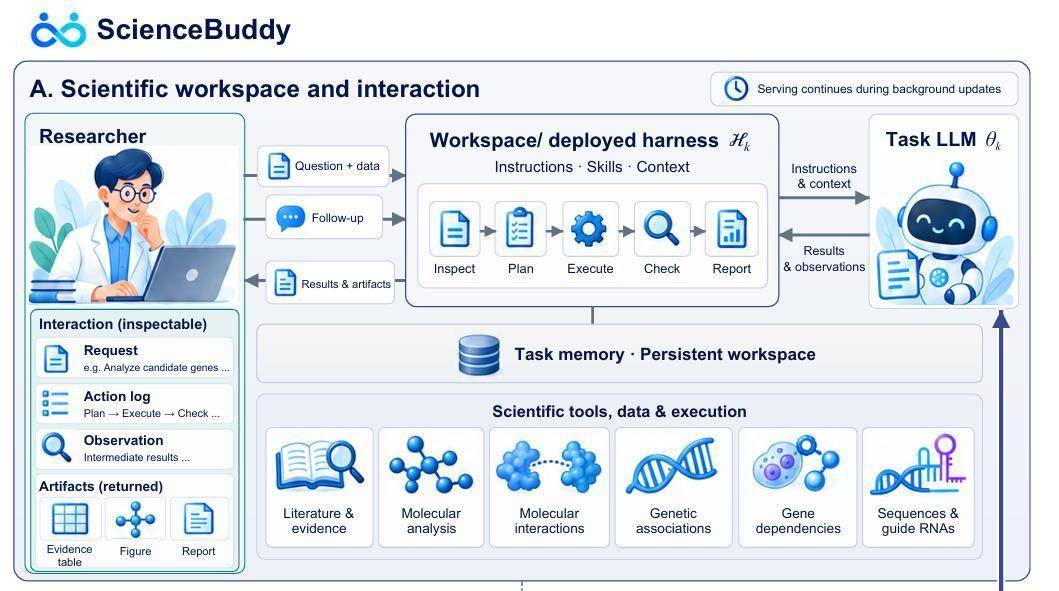
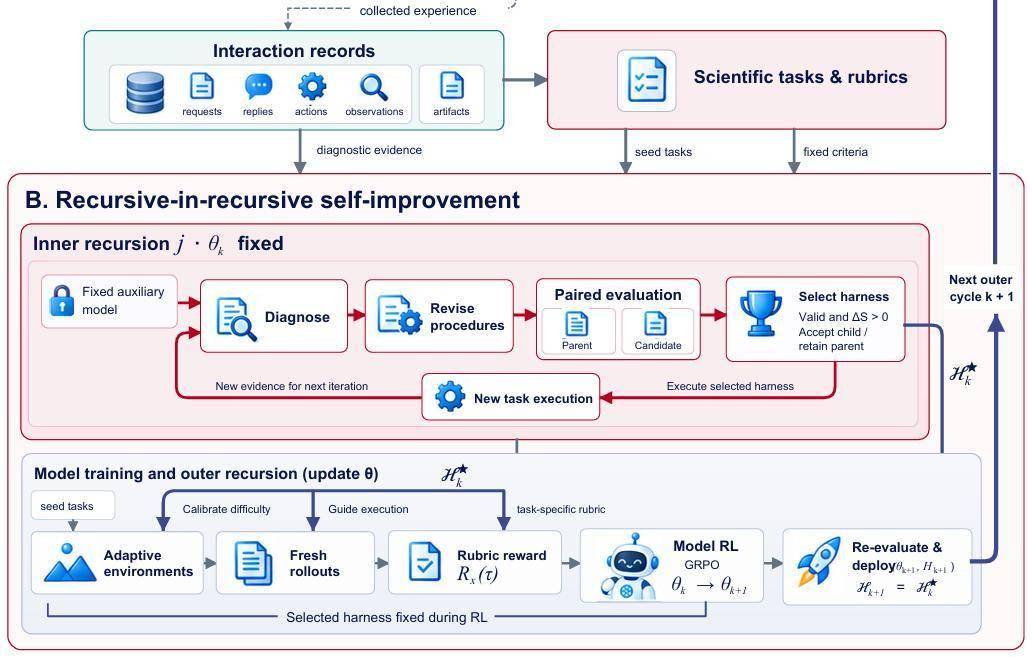
内层递归(固定模型,改手册):在一个训练周期里,任务模型参数保持不变,由 GPT-6 Astra 作为独立的"诊断编辑模型",审阅最近的执行轨迹和评分结果,定位没达标的地方,提出一次有边界的修改,要么改一条指令,要么增删改一个 scoped skill。
每次修改都有约束和"配对评测"把关,只有在不违反编辑约束、且在相同开发任务上平均分高于父版本(ΔS > 0)时才被接受,否则保留原版。案例里经过 288 段适配对话、24 次更新,最终选中的手册包含 4 条指令和 9 个技能;在验证集上,选中手册的首答准确率达到 51.1%,而初始手册只有 31.1%,提升了 20 个百分点。
外层递归(固定手册,训模型):手册定型后,团队先根据当前模型能力校准环境难度、做数据增强,再用"任务自适应评分标准"(rubric)作为细粒度奖励,通过 GRPO 训练任务模型。Rubric 把每个任务拆成多条带权重的检查项,能执行检查就用程序判,需要科学判读就交给固定裁判。
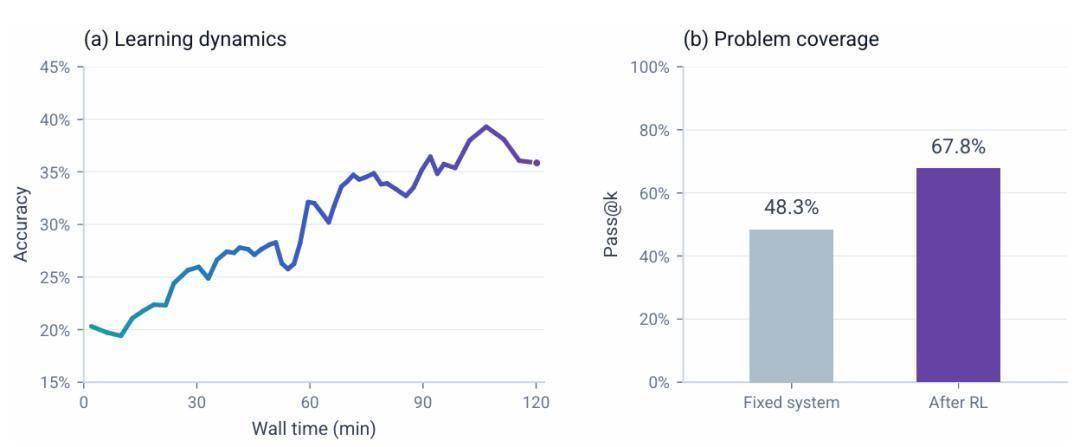
在固定初始手册 H0 的条件下,模型训练约两小时,问题覆盖率(pass@4,每个问题最多 4 次尝试)从 48.3% 提升到 67.8%,提升了 19.5 个百分点,同样的尝试预算下,模型能独立解出的科学问题范围明显变宽。
这套机制的关键在于"双向耦合",手册的改动塑造了训练轨迹和任务难度,而模型升级又会改变旧手册的有效性。后台改进和在线服务并行,重新评测后再把"新模型 + 旧手册"一起部署回去,开启下一轮循环。
03 把聊天变成教材,
科研 Agent 评测被改写
ScienceBuddy 最有意思的设计,是让研究者的协作本身成为训练信号。
团队没有采用"先打包任务、再请专家标注"的老路,而是从完整的协作轨迹里同时提炼出"任务"和"评分标准",任务指令保留最终需求和输入,但不照搬历史答案;评分标准覆盖任务范围、方法要求、证据和预期产物。
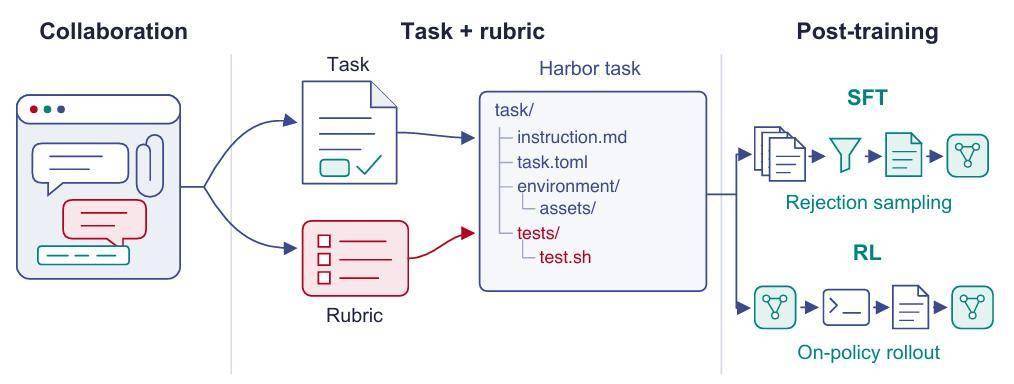
这些任务被打包成可执行的 Harbor 任务,同一批任务同时支撑两条后训练路线:SFT 用拒绝采样保留评分达标的轨迹,RL 则采集 fresh on-policy rollouts、以 rubric 分数为奖励。研究者回复可以完善任务目标和评分标准,但不会自动当成"正确答案"。
这些结果背后,核心变化不在模型参数规模。ScienceBuddy 案例里用的只是 Qwen3.5-4B 级别的基座,真正拉开差距的,是把研究者的真实协作过程变成持续学习素材,以及围绕"递归套递归"做的训练机制改造。
过去评价一个科研 Agent,常常看它能不能答对一道题、跑通一段代码。ScienceBuddy 给出的信号是Agent 能力的提升,已经越来越依赖把真实协作与执行过程变成训练本身,朝着"发现智能"(discovery intelligence)的方向,让科研 AI 在与研究者的持续协作中共同进化。返回搜狐,查看更多