以后在欧盟用ChatGPT写的一段话,可能自带一枚谁也看不见的“水印”。北京时间10月5日晚,OpenAI在官网安全栏目发了一篇文章,英文标题是《Our approach to EU text provenance rules》,翻成中文就是《我们针对欧盟文本溯源规则的做法》。林晓把这篇文章、同日公开的技术报告和OpenAI帮助中心的说明都翻了一遍,帮大家捋一捋这件事到底在说什么。
先说为什么要做。欧盟《人工智能法》第50条有一项透明度义务:生成式AI的提供方,要让模型生成的文本能被机器识别出来。按欧盟委员会网站的介绍,这项义务从2026年8月2日起适用;配套的AI生成内容行为准则属于自愿签署,但第50条本身是法律要求。OpenAI帮助中心说,它和其他几家主要AI公司都签了这份准则。
不过OpenAI自己也承认,给文字加水印、再把水印查出来,这门技术还很早期,局限不小,业界对它到底有多大用、该怎么用也没吵出结论。所以它拿出来的是一个分步走的方案,主要是三件事。
第一件,从现在起,全球的API开发者可以给部分模型手动打开文本水印,默认是关的。第二件,接下来几周,欧盟地区符合条件的ChatGPT和Codex文字输出会加上隐形水印,所有套餐都算。第三件,水印检测器开放申请,但一开始只给审批通过的研究人员和专业机构用。
要注意,这次说的只是文字。图片和音频那边,OpenAI早就有网页验证工具openai.com/verify和“内容溯源API”,机构可以拿来判断一张图或一段音频是不是OpenAI生成的,这些照旧开放。
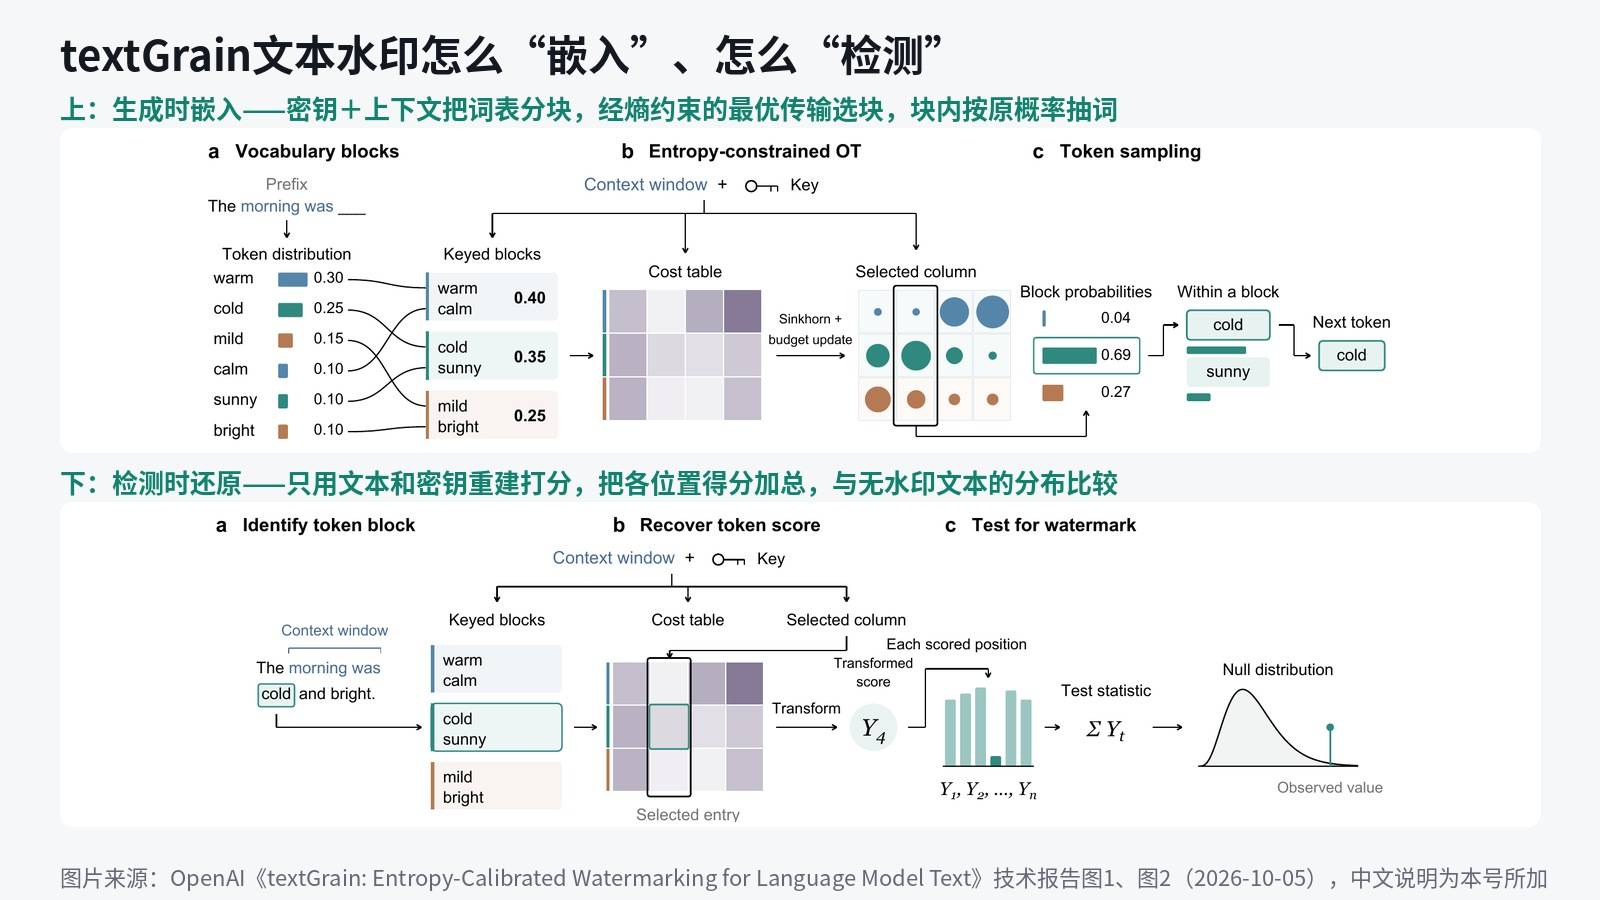
图1:textGrain的原理示意,上半部分是生成时用密钥把词表分块再挑词,下半部分是检测时只凭文本和密钥重新打分(来源:OpenAI《textGrain: Entropy-Calibrated Watermarking for Language Model Text》技术报告图1、图2)
那水印到底藏在哪?这项技术叫textGrain。按OpenAI的说法,模型在挑下一个词的时候,会悄悄带上一点统计上的偏好,人眼看不出来,检测器却能把这种规律找出来。帮助中心特别强调,水印就藏在措辞里,不会塞隐藏字符、不可见空格或者奇怪的标点。
技术报告的题目是《textGrain:面向语言模型文本的熵校准水印》,作者来自OpenAI、宾夕法尼亚大学和耶鲁大学。简单说,它用一把密钥结合上下文,把词表切成几“块”,再用一种带约束的最优传输方法,把“这一步从哪块里选词”和密钥算出的随机数绑在一起,块里面各个词原本的概率不动。生成时还能设一个“熵损失预算”,决定为了加水印愿意牺牲多少随机性。检测时只要有文本和密钥就行,不需要知道当初用了多大预算。OpenAI说技术报告未来几周会补充细节,并打算把这项技术开源。
效果如何?OpenAI称,在它比过的几种方法里,textGrain和谷歌的SynthID文本水印等方法打平或者更好。但它紧跟着提醒:实验室里表现好,不代表日常使用中能稳稳查出来。
检测器会犯两种错:明明没水印却说有,叫误报;明明有水印却没查到,叫漏报。OpenAI公布的数据是在误报率目标定为1%的前提下测的。按官方说法,心理学这类话题,200个token(可以粗略理解为模型处理文字的最小单位)的段落大约80%能查出来,400个token能到约95%;可数学这类用词选择余地很小的内容就难多了,官网图表显示,200个token只有约36.5%,400个token约60.8%。
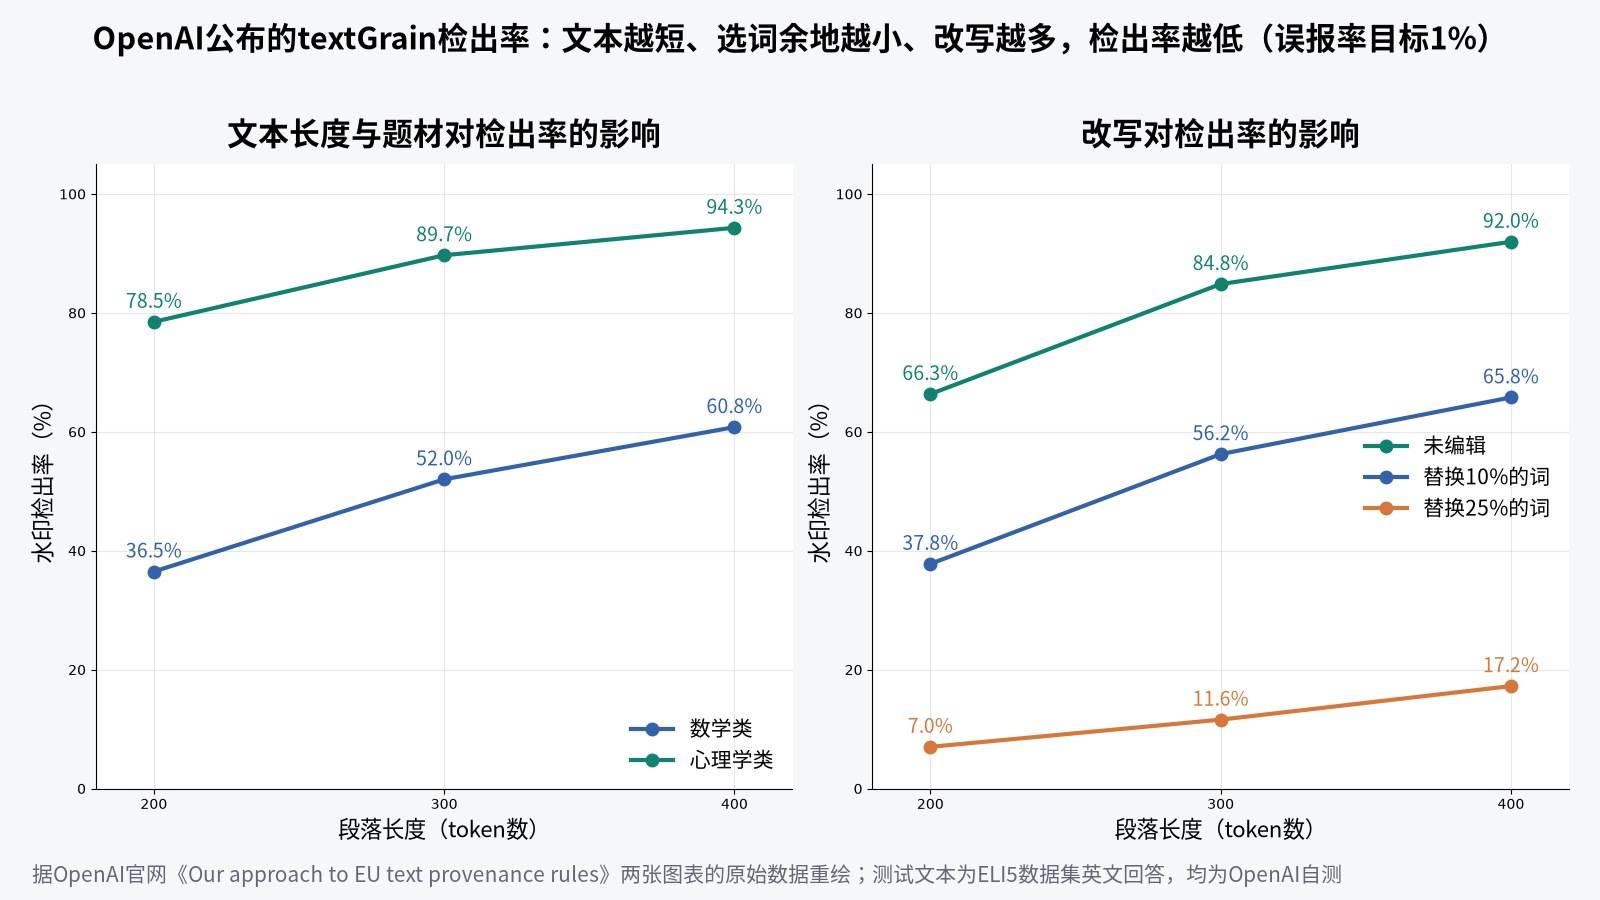
图2:误报率目标1%时textGrain的检出率,文本越短、数学类内容越难查出,同义词替换越多检出率越低(来源:据OpenAI《Our approach to EU text provenance rules》图表数据重绘)
另一组数据看的是改写。在400个token的段落上,把10%的词换成同义词,检出率从约92%掉到66%;换掉25%,只剩17%。图表还显示,200个token的段落换掉25%的词后,检出率只有约7%。这些测试用的都是ELI5问答数据集里的英文回答。
正因为短板明显,OpenAI决定检测器先不对公众开放,只让获批的研究人员和专业机构用,按行为准则一单一单审批。检测结果也只说“有没有查到OpenAI的水印”,不会认出是谁写的,也不会透露提示词和对话内容。
很多人会关心:加了水印,回答质量会不会变差?OpenAI拿评估自家最新前沿模型Astra用的一组基准做了对比,结论是有没有水印差别不明显。按OpenAI公布的数字,Artificial Analysis智能指数无水印49.57分、有水印49.76分;GPQA Diamond是94.44%对93.94%;DeepSWE v1.1是72.80%对71.68%;Terminal-Bench 4.0是53.90%对56.06%。这些都是OpenAI自己测的。
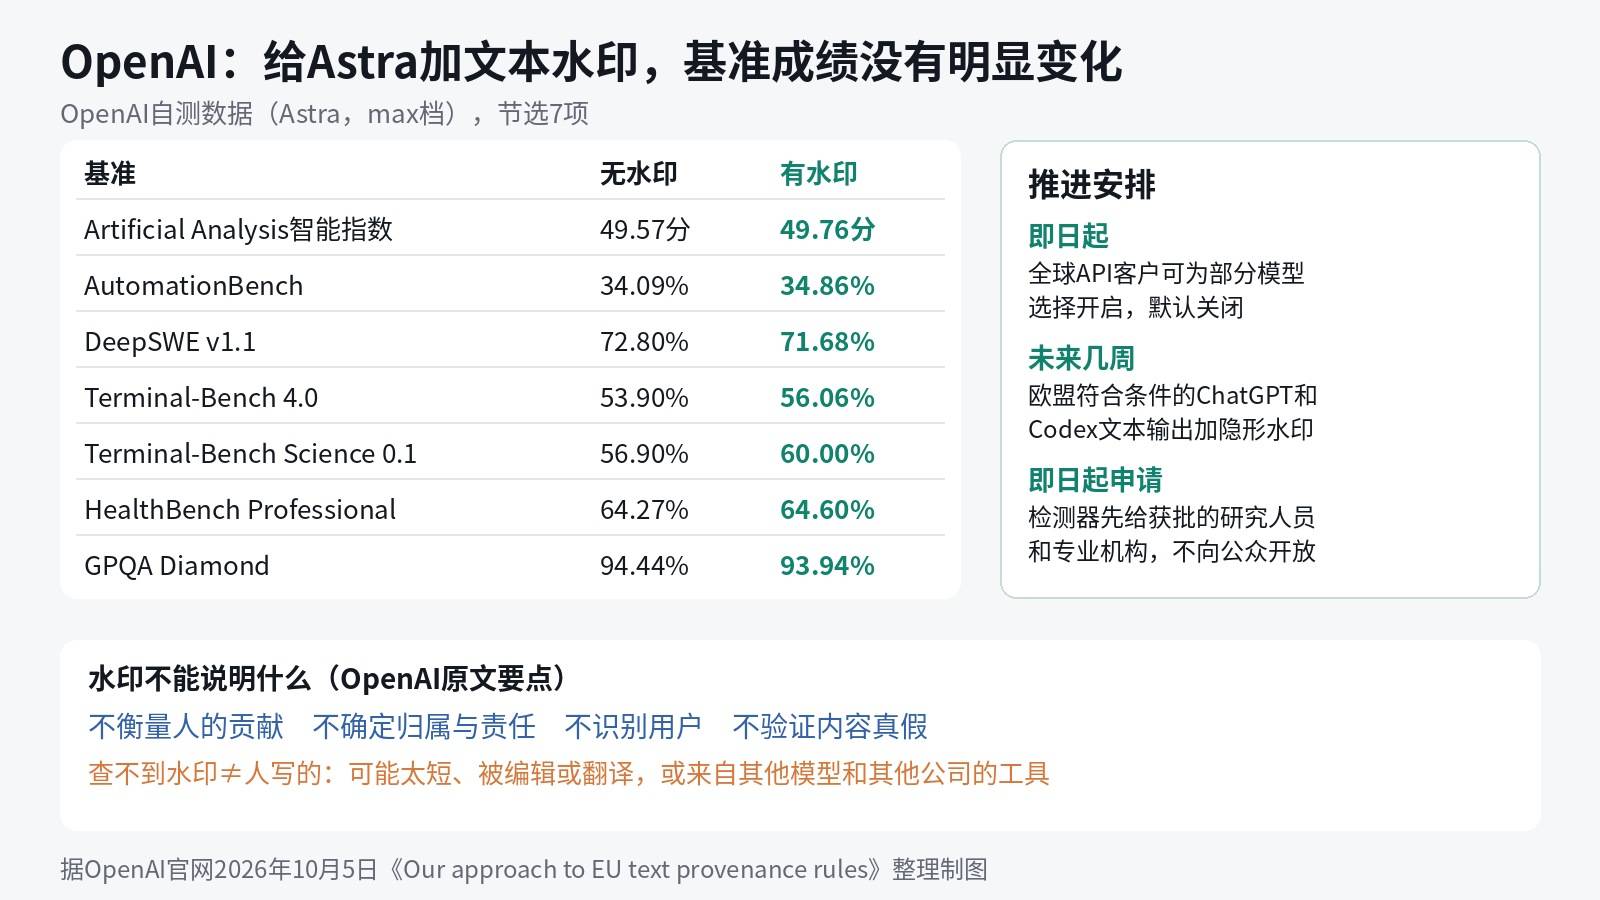
图3:OpenAI称Astra加上文本水印后各项基准成绩差别不大,以及API可选、欧盟ChatGPT与Codex加水印、检测器先给研究人员的推进安排(来源:据OpenAI官网2026年10月5日文章整理制图)
文章里还花了不少笔墨讲“水印证明不了什么”。它只能说明某段文字有一部分经过OpenAI的系统生成或处理,说明不了人在里面花了多少心思修改和创作,也判断不了这段文字归谁、用得合不合法、需不需要标注。
水印也不认人,不会把文字对应到某个人、某家机构、某个账号或某次对话,更不负责核实内容真假。反过来,查不到水印也不能说明就是人写的:文字可能太短、被改过或翻译过,也可能来自不支持的模型、写于水印上线之前,或者干脆是别家工具生成的。
节奏上,欧盟的文本水印会覆盖所有套餐里符合条件的ChatGPT和Codex用户,但只限欧盟,OpenAI明确说不会一上来就在全球默认开启,想先从真实使用和反馈里学经验。它也在和云服务伙伴合作,未来几周让通过云平台调用的OpenAI模型输出也能加水印。
放到更大的范围看,OpenAI的意思是没有哪种溯源手段单打独斗就够用,所以它在图片上同时用了符合C2PA标准的“内容凭证”,在支持的图片和音频里嵌入SynthID隐形水印。内容凭证记录文件从哪来、改过什么,隐形水印则能在元数据被删掉后继续留下信号。文字比图片难得多,因为太容易被改写、翻译和编辑,OpenAI说会继续研究水印在这些操作之后还能留下多少,也想更清楚地区分“AI帮着写”和“AI直接写”。
林晓的看法是,这篇文章最值得看的,反而是OpenAI主动把短板亮了出来:数学类短文本只能查出三成多,400个token的段落改掉四分之一的词,检出率就掉到两成以下。所以文本水印更像一个参考信号,拿它当“是不是AI写的”铁证并不靠谱,学校或平台要是只凭这个下结论,很容易冤枉人。另外,欧盟默认开、其他地区只让开发者自选,也能看出各家还在“透明”和“好用”之间找平衡。其他大模型公司会不会跟进,值得接着看。你觉得AI写的文字该不该都打上水印?欢迎在评论区聊聊。(以上为本号观点)
来源:OpenAI官网《Our approach to EU text provenance rules》(openai.com/index/eu-text-provenance,2026年10月5日);OpenAI技术报告《textGrain: Entropy-Calibrated Watermarking for Language Model Text》(2026年10月5日);OpenAI帮助中心关于溯源信号的说明;欧盟委员会AI生成内容行为准则页面。文中数字均按OpenAI公布,引语为编译,部分引用注明出处;图1为OpenAI技术报告原图,图2、图3据OpenAI官网公开数据整理重绘,图注按本篇重写。返回搜狐,查看更多