作者丨Charlotte77
来源丨我爱PaddlePaddle
Hub 是什么?Hub 本意是中心,docker 有 docker Hub,大家可以把自己创建的镜像打包提交到 docker hub 上,需要的时候再 pull 下来,非常方便,那么模型是不是也可以这样玩呢?
完全可以!很多时候我们不需要从头开始训练模型,如果有预训练好的模型,直接做迁移学习就可以,但是传统的方式基本上都需要从各个官网上去下载,模型比较大,用起来并不轻量。现在各家都发布了 Hub ,可以直接从 Hub 上下载 pretrain 模型做 finetune 或预测,极大的减轻了工作量。下面直接从四个维度对比 PyTorch Hub 和 PaddleHub。
PyTorch Hub v.s. PaddleHub
支持模型数量
Pytorch Hub 目前支持 18 个模型,PaddleHub 支持 29 个,包含 16 个 model 和 13 个 module,model 可以直接使用,module 提供了预训练模型的参数,支持命令行调用,下面来看看分别支持哪些模型:
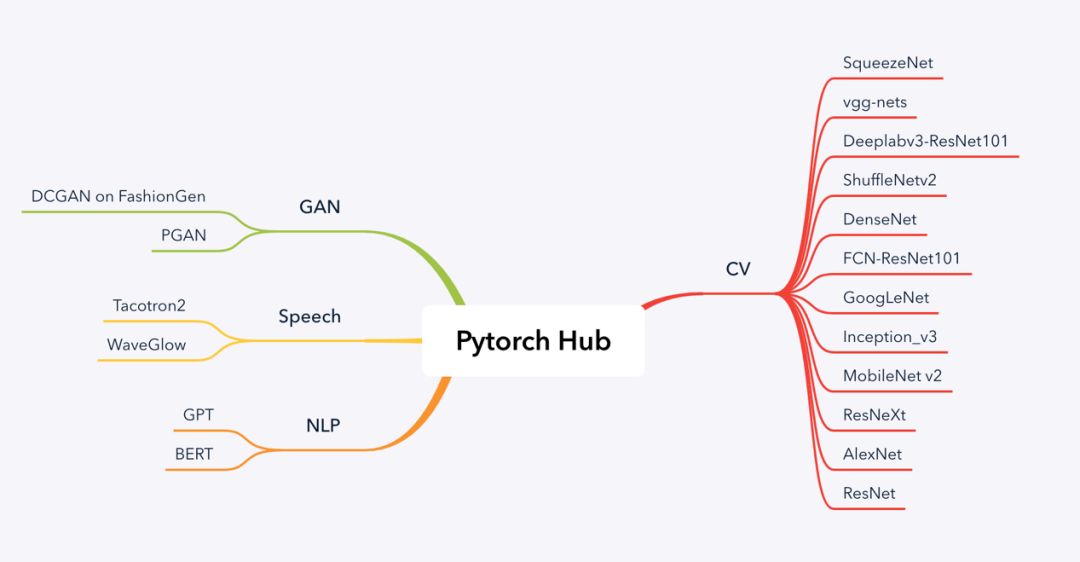
▲PyTorch Hub目前支持18种模型
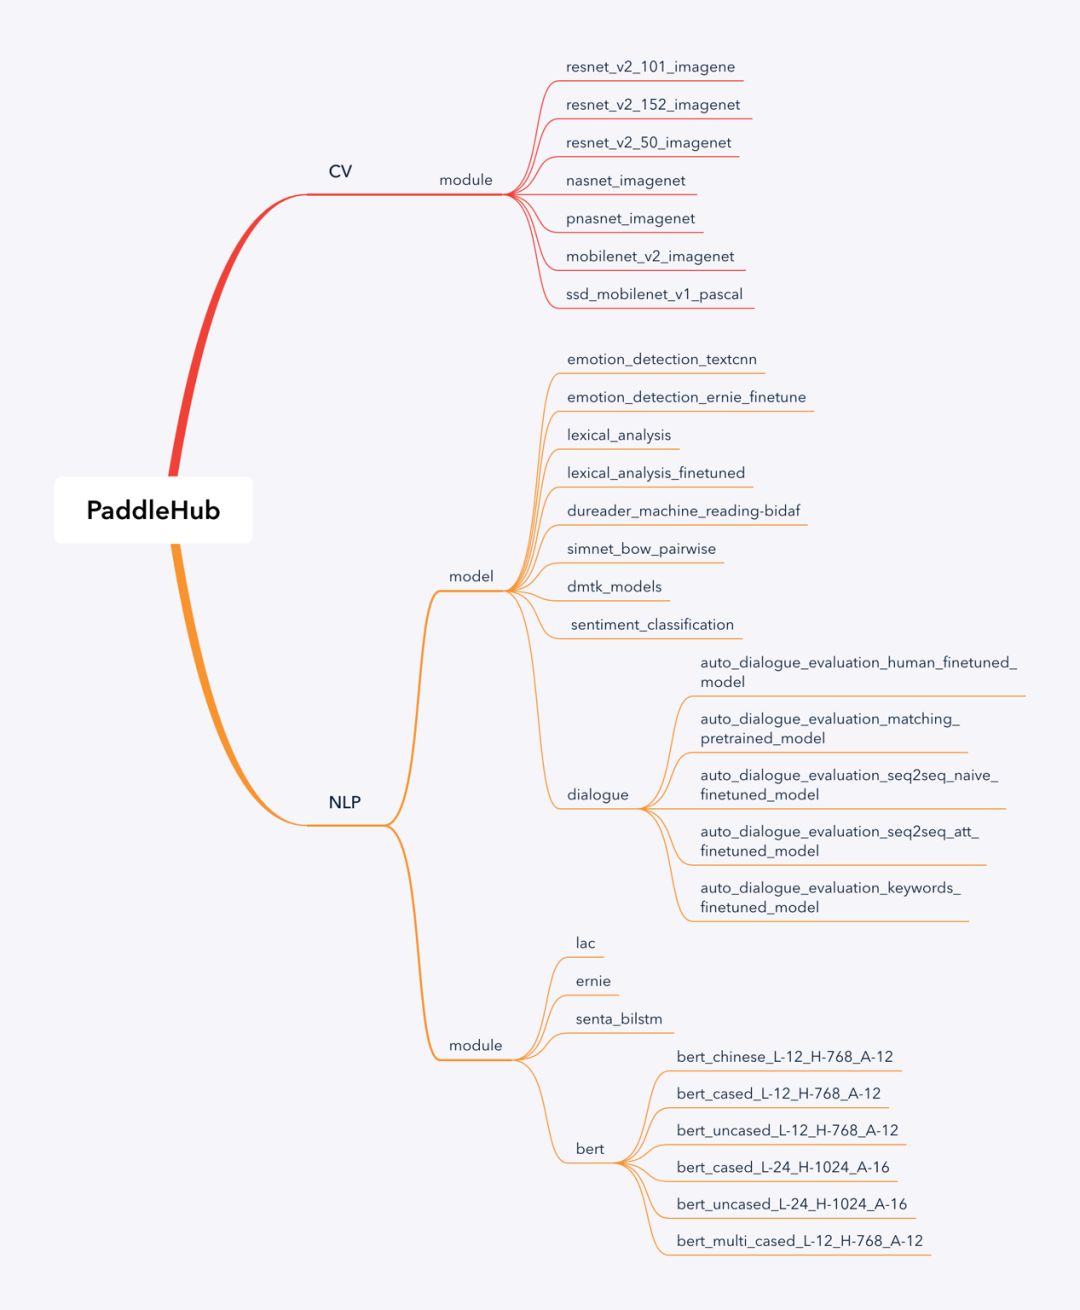
▲PaddleHub目前支持29种模型(包含model和module)
从图中可以看到,PaddleHub 支持的模型数量有绝对的优势;而 PyTorch Hub 涉及的方向更多,但是每个方向的模型并不多,对 CV 的支持更多;PaddleHub 涉及的方向只有两个,CV 和 NLP,但是对 NLP 的支持尤其多,高达 22 个,不仅包括目前最潮的 BERT,还有百度自己研发的知识增强语义表示模型 ERNIE,在多个中文 NLP 任务中表现超过 BERT。
目前 PyTorch Hub 不支持命令行运行,但 PaddleHub 支持,命令行运行就是指我们安装 PaddleHub 后,可以无需进入 Python 环境,即可快速体验 PaddleHub 无需代码、一键预测的命令行功能。需要注意的是,在 PaddleHub 中,既可以支持命令行使用,即在终端输入,如下所示:
$ hub run XXX(nlp模型) --input_text XXX(需要预测的内容)
$ hub run XXX(cv模型) --input_path XXX(需要预测的内容)
也可以支持调用 api,如下所示:
importpaddlehub ashub
hub.finetune_and_eval(
task,
data_reader,
feed_list,
config= None)
实际上,PaddleHub 为 Model 和 Module 的管理和使用都提供了命令行工具,但是 model 和 module 是有区别的,一个是模型,一个是模块。
model 表示预训练好的参数和模型,当需要使用Model进行预测时,需要模型配套的代码,进行模型的加载,数据的预处理等操作后,才能进行预测。我们在使用PaddleHub来调用模型时,可以使用hub download 命令获取到最新的model再进行实验。
module是model的一个可执行模块,简单来说,一个 Module 可以支持直接命令行预测,也可以配合 PaddleHub Finetune API,通过少量代码实现迁移学习。
需要注意的是,不是所有的 Module 都支持命令行预测(例如 BERT/ERNIE Transformer 类模型,一般需要搭配任务进行 finetune)。也不是所有的 Module 都可用于 finetune(例如 LAC 词法分析模型,我们不建议用户用于 finetune),具体区别请见 PaddleHub 的 github wiki(参考文献 2)。
是否支持Fine-tune
PyTorch Hub 没有 Fine-tune 接口,PaddleHub 可以支持直接从 hub 调用 Fine-tune 的 api。在 https://pytorch.org/官网下的文档中可以看到,目前 PyTorch Hub 不支持 hub 一键式 fine-tuning,现有模型的 finetuning 还是基于传统的脚本式调参。
PaddleHub 在 Fine-tune 这一块做的很完善,在前一个板块也给大家详细举了示例讲解,在 PaddleHub 的官方 GitHub 中,有非常详细的 Fine-tune 教程,大家可以参考:
PaddleHub 图像分类迁移:
https://github.com/PaddlePaddle/PaddleHub/wiki/PaddleHub图像分类迁移教程
PaddleHub 文本分类迁移:
https://github.com/PaddlePaddle/PaddleHub/wiki/PaddleHub文本分类迁移教程
是否支持用户自定义上传模型
PyTorch Hub 支持,PaddleHub 不支持。我看了 https://pytorch.org/官网下的文档,只需要在开源的模型代码里增加了一个 hubconf.py,然后在 pytorch/hub 里提一个 pr,cr 后 merge 到 branch/tag 这个分支就 ok 了。方法非常简单,代码也不复杂。
torch.hub.load(github, model, force_reload= False, *args, **kwargs)
PaddleHub 目前暂时还不支持用户自己提交新模型,但后期应该会支持这个功能,到时候希望大家能踊跃使用,push 自己的新模型。
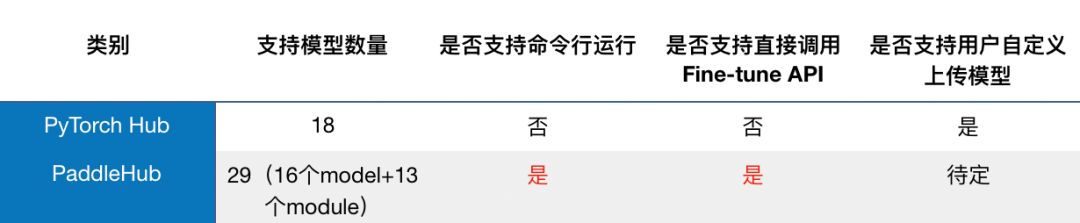
总之,从这四个维度上,我个人感觉 PyTorch Hub 更像一个小工具,帮助大家迅速试用一下开源的新模型,但是真正到实际应用,还是要基于老的一套的 fine-tuning,不能直接从 hub 里调用 fine-tune 的 api,所以并不实用。从工业级实用的角度来说,PaddleHub 做的要更成熟一些,用户可以更方便的使用 PaddleHub 来进行 Fine-tune。
下面,我们具体来看看 PaddleHub 如何直接使用命令行,调用一行代码 show 出结果 & 使用 Finetune Api 来对模型进行微调,并举一个实例教大家一步一步实现。
PaddleHub安装
- 环境依赖
- Python==2.7 or Python>=3.5
- PaddlePaddle>=1.4.0
- 安装
- pip install paddlehub
安装好后,不需要进入 Python 环境 import 就可以直接先体验 hub 的便捷,因为在 PaddleHub 中 hub 可以作为一个独立的模块直接运行。PaddleHub 目前包含图像分类、目标检测、词法分析、Transformer、情感分析五大类。
- 分词
# 使用百度LAC进行分词 •
$ hub run lac --input_text "今天的你真好看"
[{ 'tag': [ 'TIME', 'u', 'r', 'd', 'a'], 'word': [ '今天', '的', '你', '真', '好看']}]
- 情感分析
# 使用百度Senta情感分析模型对句子进行预测
$ hub run senta_bilstm --input_text "老铁666,带你开黑"
[{ 'text': '老铁666,带你开黑',
'sentiment_key': 'positive', 'sentiment_label': 2, 'positive_probs': 0.72
06, 'negative_probs': 0.2794}]
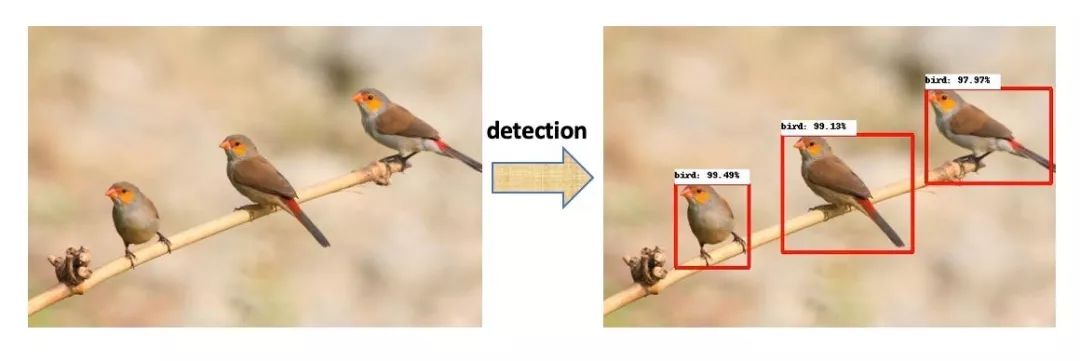
- 目标检测
#使用SSD检测模型对图片进行目标检测
hub run ssd_mobilenet_v1_pascal --input_path test_img_bird.jpg
- 图像识别
# 使用resnet-50做图像识别
hub run resnet_v2_50_imagenet --input_path test_img_bird.jpg
Install Module resnet_v2_50_imagenet
Downloading resnet_v2_50_imagenet
[==================================================] 100.00%
Uncompress /root/.paddlehub/cache/resnet_v2_50_imagenet
[==================================================] 100.00%
Successfully installed resnet_v2_50_imagenet -1.0.0
[[{ 'brambling': 0.4907981}]]
注:模型未下载时会先下载再预测,也可以先试用 hub install model_name 下载好模型再使用 hub run 预测,也可直接运行 hub run。hub 一共有十个命令,其他命令可参考 PaddleHub 命令行工具(参考文献 2)。
支持29种模型
PaddleHub 目前支持 29 种模型,主要以 CV 和 NLP 模型为主,包括 NLP 目前最火的 BERT 和百度自己自己研发开源的 ERNIE,以及 CV 中的 ssd-mobilenet、resnet-50、resnet-152 等。
- NLP预测
数据通过 —input_text 或—input_file 导入来实现单次预测和批量预测
# 单文本预测
hub run lac --input_text "今天是个好日子"
# 多文本分析
hub run lac --input_file test.txt
- CV预测
数据通过—input_path 或—input_file 导入来实现单次预测和批量预测
# 单张照片预测
hub run ssd_mobilenet_v1_pascal --input_path test.jpg
# 多张照片预测
hub run ssd_mobilenet_v1_pascal --input_file test.txt
支持迁移学习,Fine-tune更Easy
Fine-tune全景图
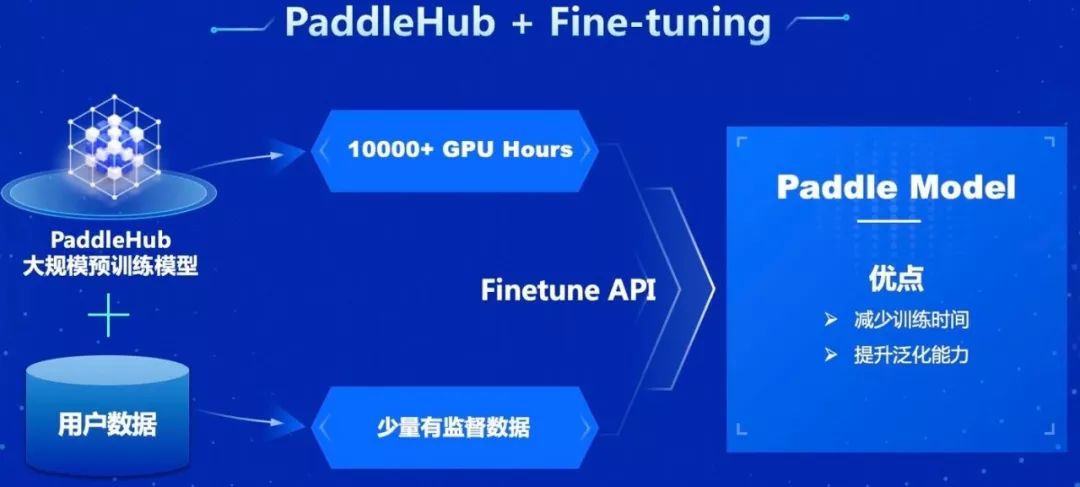
▲PaddleHub+Finetune流程图
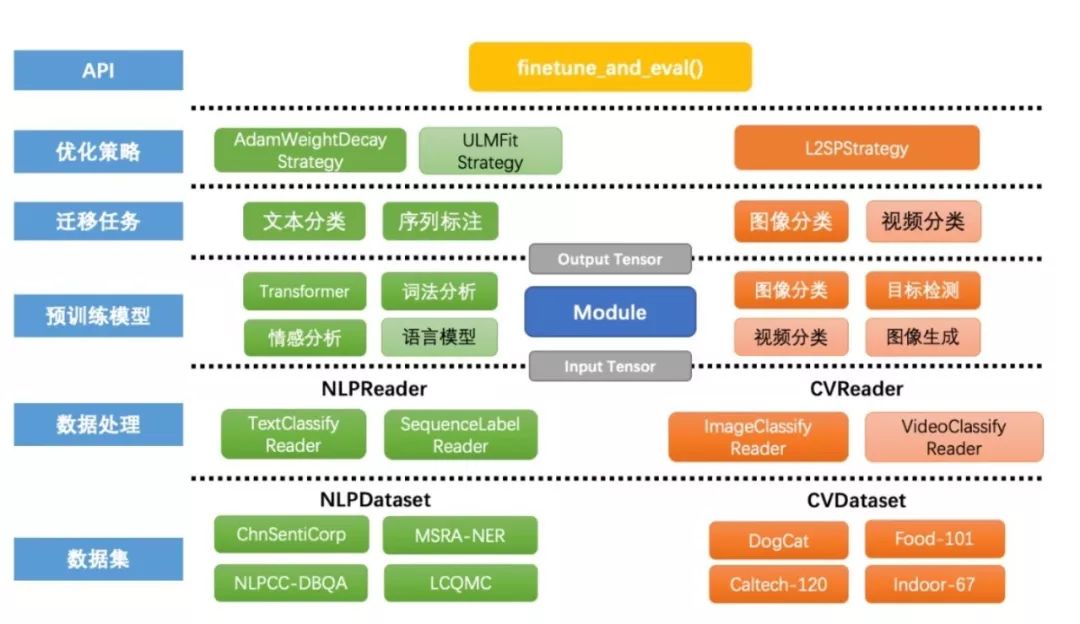
▲PaddleHub Finetune api
Fine-tune 是迁移学习中使用最多的方式之一,通常我们可以在预训练好的模型上进行微调来实现模型迁移,从而达到模型适应新领域(Domain)数据的目的。上图是做一个完整的迁移学习需要的步骤,下面举个实例教大家如何用 PaddleHub 做图像分类迁移学习。
1. 准备工作
安装 PaddlePaddle 和 PaddleHub
pip install paddlepaddle( 推荐安装 1.4.0版本以上)
pip install paddlehub
2. 选择模型
此处使用经典的 ResNet-50 作为预训练模型。
module_map = {
"resnet50": "resnet_v2_50_imagenet",
"resnet101": "resnet_v2_101_imagenet",
"resnet152": "resnet_v2_152_imagenet",
"mobilenet": "mobilenet_v2_imagenet",
"nasnet": "nasnet_imagenet",
"pnasnet": "pnasnet_imagenet"
}
module_name = module_map[ "resnet50"]
module = hub.Module(name = module_name)
3. 准备数据
# 直接用PaddleHub提供的数据集
dataset = hub.dataset.DogCat # 生成readerdata_reader = hub.reader.ImageClassificationReader(
image_width=module.get_expected_image_width,
image_height=module.get_expected_image_height,
images_mean=module.get_pretrained_images_mean,
images_std=module.get_pretrained_images_std,
dataset=dataset)
4. 组建Finetune Task
由于猫狗分类是一个二分类的任务,而我们下载的分类 module 是在 ImageNet 数据集上训练的千分类模型,所以我们需要对模型进行简单的微调,把模型改造为一个二分类模型:
- 获取 module 的上下文环境,包括输入和输出的变量,以及 Paddle Program;
- 量中找到特征图提取层 feature_map;
- 在 feature_map 后面接入一个全连接层,生成 Task。
input_dict, output_dict, program = module.context(trainable= True)
img = input_dict[ "image"]
feature_map = output_dict[ "feature_map"]
task = hub.create_img_cls_task(
feature=feature_map, num_classes=dataset.num_labels)
feed_list = [img.name, task.variable( "label").name] # 设置
configconfig = hub.RunConfig(use_cuda= False,
num_epoch= 1,
checkpoint_dir= "cv_finetune_turtorial_demo",
batch_size= 32,
log_interval= 10,
eval_interval= 50,
strategy=hub.finetune.strategy.DefaultFinetuneStrategy)
5. 启动Fine-tune并查看效果
可以选择 finetune_and_eval 接口来进行模型训练,这个接口在 finetune 的过程中,会周期性的进行模型效果的评估,以便我们了解整个训练过程的性能变化。
hub.finetune_and_eval(
task, feed_list=feed_list, data_reader=data_reader, config=config)
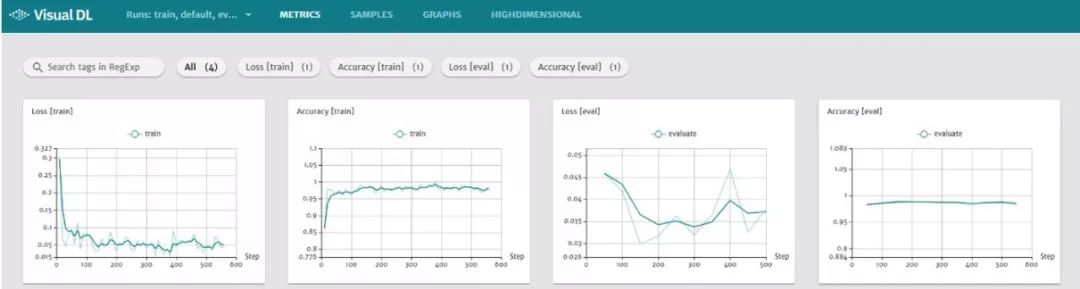
训练过程中的性能数据会被记录到本地,我们可以通过 VisualDL 来可视化这些数据。我们在 shell 中输入以下命令来启动 VisualDL,其中 ${HOST_IP} 为本机 IP,需要用户自行指定。
$ visualdl --logdir ./cv_finetune_turtorial_demo/vdllog --host ${HOST_IP} --port 8989
启动服务后,我们使用浏览器访问 ${HOST_IP}:8989,可以看到训练以及预测的 loss 曲线和 accuracy 曲线。
参考资料
[1] PaddleHub官方github:
https://github.com/PaddlePaddle/PaddleHub
[2] PaddleHub命令行工具:
https://github.com/PaddlePaddle/PaddleHub/wiki/PaddleHub命令行工具
[3] Paddle-code:
https://github.com/huxiaoman7/PaddlePaddle_code
[4] Paddle-models:
https://github.com/PaddlePaddle/models
[5] Pytorch Hub:
https://pytorch.org/blog/towards-reproducible-research-with-pytorch-hub/

免费申请Tesla V100算力卡
配合PaddleHub让模型原地起飞返回搜狐,查看更多