我院王星老师于2019年夏访问CMU,期间与该系博士后邱怡轩共同对该校部分教授进行了深度访谈,邱怡轩也曾于我院本科和硕士就读,此文是CMU统计与数据科学系与中国人民大学统计学院学术友好交往的见证。
卡耐基-梅隆大学(Carnegie Mellon University,简称CMU)是一所位于美国宾夕法尼亚州匹兹堡市的私立大学,这里是中国现代桥梁之父茅以升院士的母校,100年前的1919年,他荣幸地成为卡内基-梅隆大学历史上授予的第一位博士。CMU的计算机学院和商学院在中国最为人所知。而事实上,CMU的统计与数据科学系也非常优秀。CMU的统计与数据科学系隶属于Dietrich人文与社会科学学院(Dietrich College of Humanities and Social Sciences)。CMU的统计与数据科学系有许多跨学科的合作项目,除了科学领域的生物学、神经科学、信息安全、天文宇宙等科学领域,还涉及教育、公共政策和法律等共计八大交叉学科领域。每年招收本科生约100人,研究生约20人,博士生约10人。这些学生里,有很多来自中国大陆。
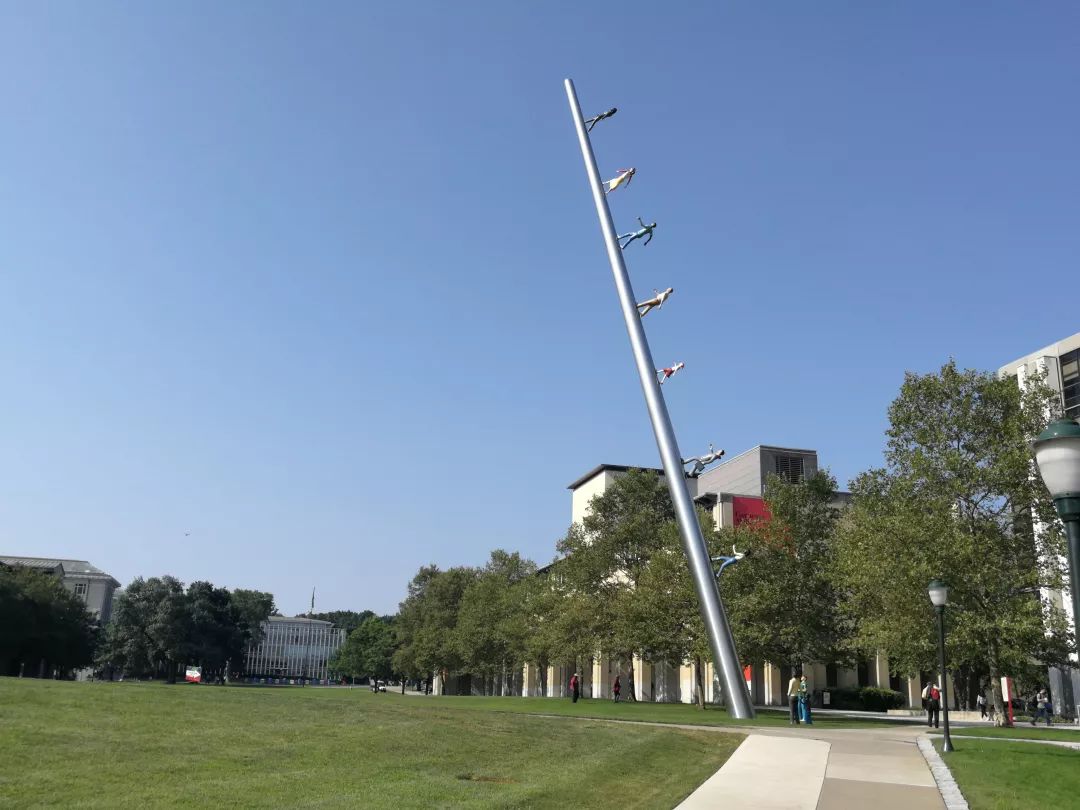
福布斯大街(Forbes Ave)上的
CMU地标雕塑Walking to the Sky
统计与数据科学系所在地Baker Hall
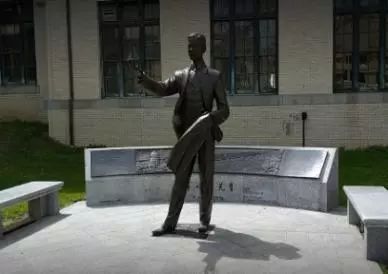
Baker Hall南侧茅以升纪念雕像
CMU统计与数据科学系拥有强大的教学与科研团队,有大约20位全职教授,包括两位美国科学院院士凯瑟琳‧罗德(Kathryn Roeder)和拉里·沃瑟曼(Larry Wasserman)。CMU统计与数据科学系的一种普遍的研究模式是:教授们在统计学的研究之外有其他的合作研究领域。例如,罗博‧凯斯(Rob Kass)教授一直置身于脑科学的研究,拉里·沃瑟曼兼任CMU机器学习系的教授,并对宇宙起源和天文学拥有浓厚的兴趣。而凯瑟琳‧罗德与匹兹堡大学的医学院有长期的合作关系。著名华裔统计学家哈佛大学的孟晓犁教授在2013年主编的《Strength in Numbers: The Rising of Academic Statistics Departments in the U.S.》一书中也提到CMU统计学系的数据科学研究特色:在大数据时代,CMU的统计与数据科学系与机器学习系不仅并驾齐驱双核共领数据科学的未来,而且在统计之外其他领域CMU统计作出的实质性贡献与他们在统计专业杂志上所发出的科学声音一样振聋发聩。这些独具特色的研究传统也感召一代代年轻学子对跨学科项目的参与热情,而新生力量的加盟则进一步充实着该系跨学科的研究实力。
CMU统计与数据科学系另一项传统是:学生和教授们会自发组成许多兴趣小组和讨论班,内容涉及机器学习、因果推断、网络型数据分析、天文数据分析等等。兴趣小组通常以作报告的形式展开,内容包括组员的最新研究成果,或是该领域最新的学术论文等。每学期开始时各小组会招募成员,所有学生和研究人员都可以自由参加,不设限制。
访问期间作者有机会拜访了凯瑟琳‧罗德教授。凯瑟琳‧罗德教授曾任卡内基-梅隆大学的副教务长,现任统计与数据科学系的教授,兼任计算生物学系的教授。她的研究兴趣是遗传变异模式和复杂疾病之间的联系。凯瑟琳‧罗德的研究小组运用高维统计、机器学习、非参数方法和网络等多种现代统计工具来解决生物遗传学的问题。她是复杂疾病的基因基础和统计基因组学方面的世界顶尖级的专家,她的研究领域还包括自闭症和其他遗传疾病的理解。2014年她带领的团队发表在《自然遗传学》杂志上的文章发现,自闭症的大多数基因风险来自于人群常见的基因版本,而非罕见的变体或者某些自发产生的小毛病,简单来说就是自闭症影响因素中的遗传因素大于环境因素。凯瑟琳教授曾经这样介绍她们的研究发现:遗传在自闭症的发展中所起的作用超过了环境风险因素,自闭症更类似于一座“高楼”,是由很多小的风险因素“砖块”垒起来的。如果没有统计学工具几乎不可能有这项发现,现在我们必须以我们已经发现的事实为基础开始搭建新的风险模型,并利用统计方法确定未来医疗系统应该把治疗的精力放在哪里,以及对病人来说什么是最有助益的。
作者与凯瑟琳‧罗德教授亲切交流
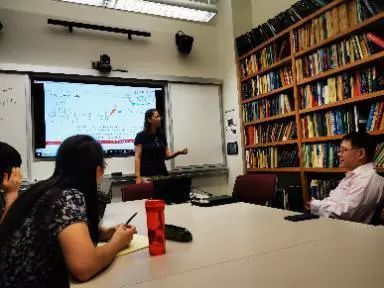
作者在金教授的
Journal club 上作学术报告
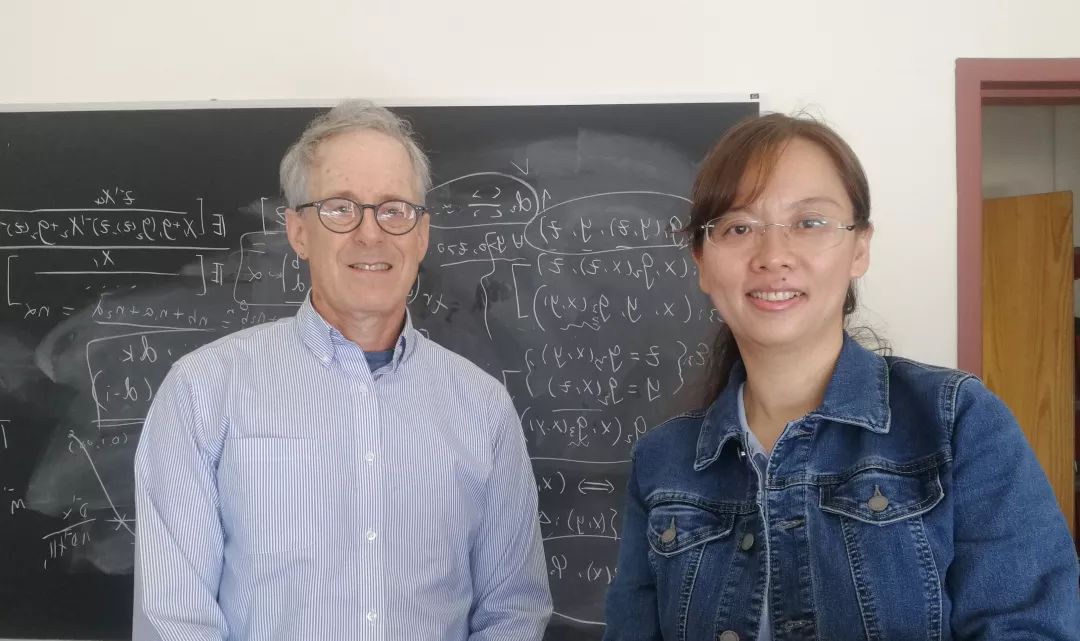
作者与罗博‧凯斯教授亲切交流
CMU统计与数据科学系目前有三位教授来自中国大陆,分别是金加顺、雷径和魏玉婷。金加顺是目前该系唯一一位来自中国大陆的正教授,其早年毕业于北京大学数学系。2003年取得斯坦福统计系博士学位,现任美国卡内基梅隆大学统计与数据科学系教授。 金教授早期的主要研究领域是大规模稀疏数据的数据分析推断。在这一领域,他提出了一系列统计理论和方法,其中高阶鉴定法(Higher Criticism)和相关的相图理论(Phase Transition)最为人所知。高阶鉴定法作为一个概念最早由统计大师约翰‧图基(John Tukey)于1976年提出。金教授在博士论文里和他的博士导师大卫·多诺霍(David Donoho)一起大力发展了高阶鉴定法的思想。 金教授指出在很多重要领域里一些我们非常熟悉的高维数据里,我们所感兴趣的信号不仅稀疏而且可能比较弱,而高阶鉴定法对处理这些稀疏较弱的信号有很大优势。为刻画信号的强度和稀疏程度如何影响统计推断的结果,金教授提出用相图作为衡量统计方法的理论框架。在一系列工作里, 金教授把高阶鉴定法的思想、方法和相图的理论框架推广到很多统计领域,包括多重假设检验,数据分类,数据聚类,变量选择等,并将这些方法用于许多重要的科学领域, 包括基因组学(gene microarray), 宇宙天文学(cosmology and astronomy)和计算机信息安全(computer privacy and confidentiality)等领域。
金教授近期的研究兴趣主要集中在社会网络,值得一提的是,他的团队(包括乔治亚大学的姬鹏声教授和哈佛大学的柯峥教授)花费巨大精力,收集清理出了一个关于统计学家合作和引用的科学文献社会网络大数据。该数据涵盖了36个统计、概率和机器学习代表性期刊40多年间的8万多篇文章,内容包括每篇文章的题目、作者、摘要和参考文献以及文章间引用记录。该工作为社会网络领域提供了一系列的研究课题,在美国统计界引起很大反响。
金教授因他的这些工作获得了一系列殊荣,包括美国数理统计学会现任会士(IMS Fellow),特威迪奖(IMS Tweedie Award), 勋章讲座(IMS Medallion Lecture), 应用统计年鉴特邀讲座(IMS AOAS Lecture), 美国统计学会会士(ASA Fellow), 顶级统计期刊主编特邀评述专辑论文(Editor’s Invited Review Paper)和主编特邀评论论文(Editor’s Discussion paper)。除了学界,他在业界的从业经验也异常丰富,包括在近年华尔街全球最成功的量化对冲基金巨头(Two-Sigma Investment)数据科学团队全职工作两年的研发经验。
透过金教授组织的Journal club博士生研讨课,可以更深入了解其独特的数据科学人才培养理念。他近期的Journal club研讨会重点研讨深度学习最新进展。他告诉我,他希望他的团队成员能提出更多的数据科学理论,他不会直截了当否定任何一个有价值的数据分析实践,但是他表示了作为一名负责任的数据科学家所应抱持的学术信念:一种对问题的可估计还原性(Estimate &Recovery)、可探查性(Detectable)和伪察觉性(Undetectable)三者之间界限高度灵敏的判断力。在他的Journal club中,他鼓励学生自选论文,鼓励学生报告能够驱动自身研究兴趣的领域,在研讨中通过不断提问启发学生思考字里行间背后的深层理论。他重点关注核心理论的搭建,引导学生思考传统方法假设与应用场景不适用性的理论接口,发现信噪关系假设中所呈现出的含糊概念中理解的歧义,在具体数据发生的场景和意义中重建数学逻辑下的共识。他希望学生们消除顾忌、勇于提出想法,并将一个个构想完整地搭建出来。作为团队的引领者,金教授始终以维持数据科学理论与实践的合作“平衡” 为己任,他在专业领域里的角色之一是维护广义的专业合作网络的“度”平衡,当一项数据提案过度倾向于某一类学科文化的考量时,他会通过提出建议来修正这种失衡。
文字 / 王 星 邱怡轩
编辑 / 新媒体运营部 郭成城返回搜狐,查看更多