声明:本文转载自 哈工大讯飞联合实验室公众号
在今年3月, 哈工大讯飞联合实验室推出了中文ELECTRA预训练模型 ,并将相关资源进行开源,目前在GitHub上已获得580个star。本次更新中,我们将预训练语料从原有的约20G提升至180G,利用接近9倍大小的数据集。在阅读理解、自然语言推断、句对分类等中文自然语言处理任务中, ELECTRA-180G相比原版ELECTRA获得了显著性能提升。欢迎各位读者下载试用相关模型。
项目地址:http://github.com/ymcui/Chinese-ELECTRA
ELECTRA简介
ELECTRA提出了一套新的预训练框架,其中包含两个部分:Generator和Discriminator。
- Generator : 一个小的MLM,在[MASK]的位置预测原来的词。Generator将用来把输入文本做部分词的替换。
- Discriminator : 判断输入句子中的每个词是否被替换,即使用Replaced Token Detection (RTD)预训练任务,取代了BERT原始的Masked Language Model (MLM)。 需要注意的是这里并没有使用Next Sentence Prediction (NSP)任务。
在预训练阶段结束之后,我们只使用Discriminator作为下游任务精调的基模型。
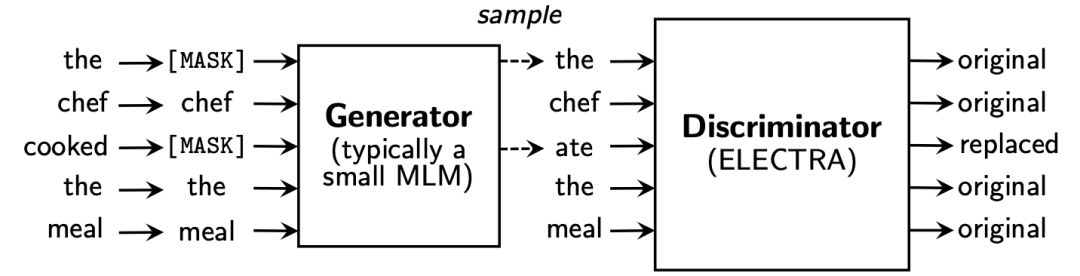
更详细的技术内容请查阅ELECTRA论文:ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators(https://openreview.net/pdf?id=r1xMH1BtvB)
同时,也可通过阅读我们的讲义《Revisiting Pre-trained Models for Chinese Natural Language Processing》了解更多预训练语言模型相关前沿进展(公众号后台回复 NLPCC2020即可下载)。
中文ELECTRA
除了使用与RoBERTa-wwm-ext系列模型 一致的扩展训练数据(约20G)之外,我们从CommonCrawl中获取了更大规模中文文本数据,并经过数据清洗等操作,进一步将预训练语料规模扩充到180G。本次发布以下四个模型:
- ELECTRA-180g-large, Chinese: 24-layer, 1024-hidden, 16-heads, 324M parameters
- ELECTRA-180g-base, Chinese: 12-layer, 768-hidden, 12-heads, 102M parameters
- ELECTRA -180g -small-ex, Chinese : 24-layer, 256-hidden, 4-heads, 25M parameters
- ELECTRA -180g -small, Chinese : 12-layer, 256-hidden, 4-heads, 12M parameters
哈工大讯飞联合实验室发布的所有中文预训练语言模型均可通过huggingface transformers库进行快速加载访问,请登录我们的共享页面获取更多信息。
https://huggingface.co/HFL
效果评测
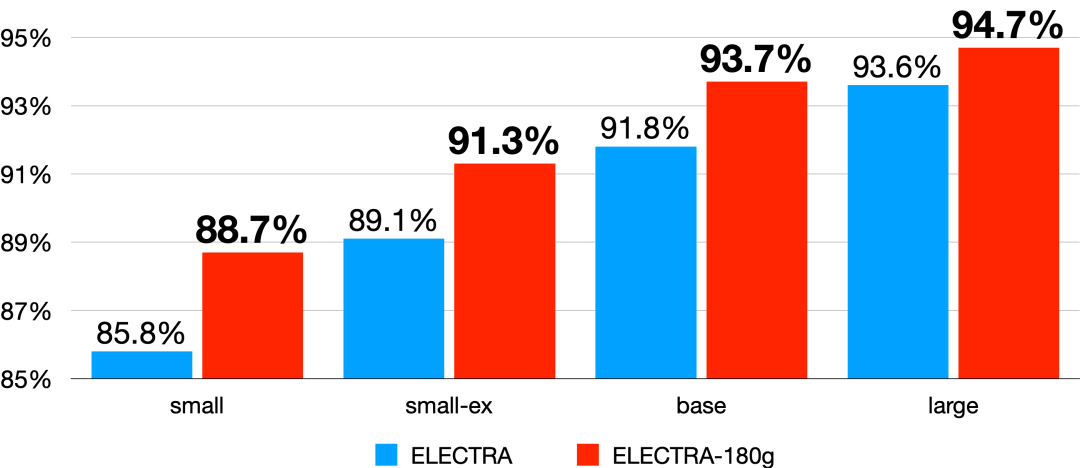
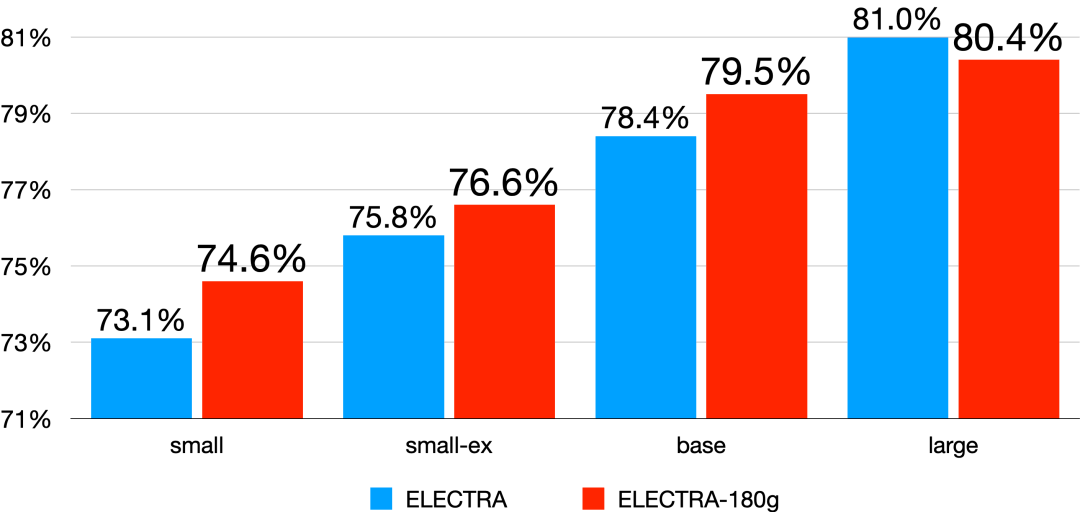
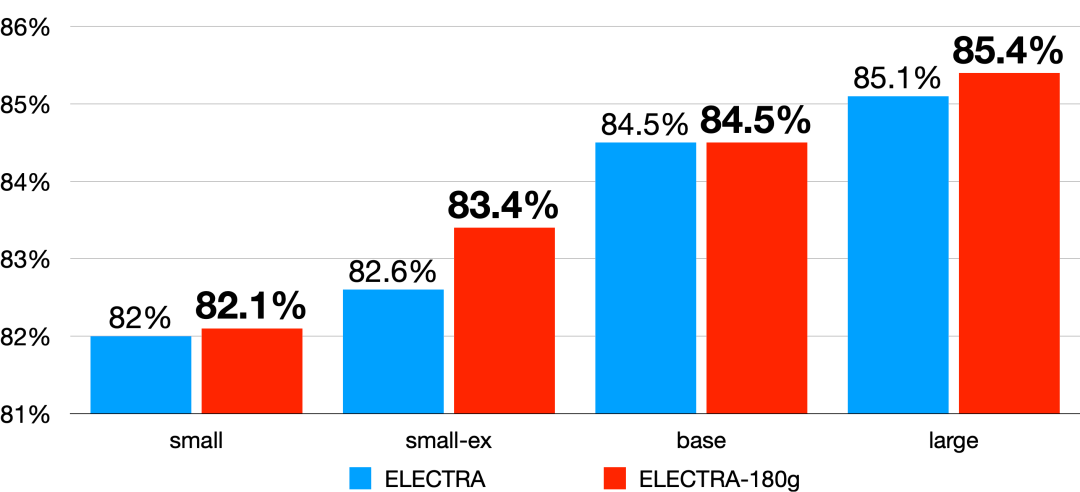
在CMRC 2018(简体中文阅读理解),DRCD(繁体中文阅读理解),XNLI(自然语言推断),BQ Corpus(句对分类)任务上,ELECTRA-180G显著超过原版ELECTRA的效果。更详细的效果评测请查看项目的GitHub。
CMRC 2018

DRCD
XNLI
BQ Corpus
相关资源地址
- TextBrewer知识蒸馏工具
- ht t p://github.com/airaria/TextBrewer
- 中文BERT、RoBERTa、RBT系列模型
- https://github.com/ymcui/Chinese-BERT-wwm
- 中文XLNet系列模型
- https://github.com/ymcui/Chinese-XLNet
- 中文MacBERT模型
- https://github.com/ymcui/MacBERT
本期编辑:冯 晨
主编:车万翔
编辑:王若珂,钟蔚弘,彭湃,朱文轩,冯晨,杜佳琪,牟虹霖,张馨返回搜狐,查看更多