🌈 2021年寒假Stata研讨班:高级计量经济学及Stata应用研讨班
👉2021空间计量研讨班:空间计量及Geoda、Stata、ArcGis、Matlab应用
1
内生性介绍
在面板数据分析,尤其是Arellano-Bond 估计方面作出了贡献。该方法利用面板数据中的时间模式来估计对政策或其他变量变化的经济响应,同时对永久性的未观察到的混淆变量进行控制。
一个典型的线性回归模型:y = β0 + β1x1 + βX + ε (1),这里y为被解释变量,x1为自变量,或者解释变量,也即“因”。大写的 X 为外生控制项向量( 也即一组假定为外生的其他控制变量,例如年龄、性别等等) ,ε则为误差项。如果ε与x1不相关,那么我们可以利用OLS 模型对方程进行无偏估计。
然而,如果一个重要变量x2被模型(1) 遗漏了,且x1和x2也相关,那么对β1的OLS 估计值就必然是有偏的。此时,x1被称作“内生”的解释变量,这就是 “内生性”问题。遇到“内生性”问题肿木办?有一个方法就是找工具变量Z。
如果存在内生性,则称解释变量为 “内生变量”(endogenous variable);反之,则称为 “外生变量”(exogenous variable)。内生性的严重后果是使得 OLS估计量不一致(inconsistent),即无论样本容量多大,OLS 估计量也不会收敛至真实的参数值 。
在计量经济学中,把所有与扰动项相关的解释变量都称为“内生变量”。这与一般经济学理论中的定义有所不同。1。与误差项相关的变量称为内生变量(endogenous variable)。2。与误差项不相关的变量称为外生变量(exogenous variable)
2
内生性来源
(1)遗漏变量偏差 (2)经典的测量误差问题 (3)联立性(逆向因果)
首先我们来看下反向因果关系的解释,例如根据凯恩斯的消费函数,首先模型的设定为C=a+bY+Ui,其中C为消费,Y为国民收入,Ui为随机误差扰动项。然而国民账户的恒等式又有Y=C+I+G+NX,即Y等于消费投资政府购买和净出口的和,很显然,消费是国民收入的重要组成部门,消费又是误差的函数,这样消费与国民收入的函数之间存在反向因果关系,主要因为消费函数里面的Y与Ui相关,本来应该是X与Ui不相关,扰动项的信息应该全部包括或者表现概括在已经有的X里面了。
遗漏变量主要值得是某些不可观测的解释变量没有纳入到回归模型中,如果北一楼的变量能够同时对因变量和自变量产生影响,那么会出现内生性的问题。一个比较经典的案例例如研究一个人受教育程度与他的收入之间的关系,其中收入作为被解释变量Y,然后样本中的隔热的教育程度作为解释变量,这个模型中例如能力、性别以及其他变量都有可能同时影响该模型变量受教育程度以及收入,例如个人能力比较高的人可能这个收入比较高,而个人能力有可能作为遗漏变量包含在随机误差扰动项中,因此会出现这个内生性的问题。
另外还有一种就是存在的度量误差现象,到时候也是主要表现在内生性的这个与X和Ui不相关,但是却相关了。
3
工具变量简介
解决内生性问题的常见方法,主要包括工具变量( instrumental variable,简称IV) 、固定效应模型( fixed effects model,简称FE) 、倾向值匹配( propensity score matching,简称PSM) 、实验以及准实验( experimentsand quasi-experiments) 等等。本文主要介绍工具变量法。
内生性的选择标准
要解决这一内生性问题,我们需要引入更多信息来进行无偏估计。工具变量的方法就是引入一个外生变量Z,且Z 必须满足以下两个条件: 与随机误差扰动项不相关,但与x1(与内生变量)相关。或者说,Z 仅仅通过影响x1来影响y。(总结为:与扰动项无关,与内生变量相关,能够替代或者表达原内生变量的信息)工具变量IV应该尽量是外生的(如历史/自然/气候/地理之类),它应该在理论上对被解释变量(以下称Y)没有直接影响,但应该通过影响被工具的变量(以下称X)而间接影响被解释变量Y。
一个合理的工具变量应该同时主要满足两个条件:
(1)、强度条件,即工具变量应该与内生自变量具有较强的相关性,即该工具变量的应该能够代替或者表达原内生变量的信息,数学表达式为:
COV(Z,X)=/0
(2)、排除限制条件,即工具变量应该与误差项不相关,也就是与因变量Y中不能被已有的自变量x所表达的部分无关(也是与误差项无关)
COV(Z,u)=/0
如果第一个条件不满足,我们认为这个工具变量是若工具变量,如果第二个条件得到不满足,我们认为该工具变量不具备足够的外生性,所谓外生性就是Z与误差项不相关。这样将导致工具变量的估计值出现类似于OLS估计的回归偏误。
4
二阶段最小二乘法
二阶段最小二乘法的第一阶段就是利用原模型的内生解释变量对工具变量进行OLS,得到解释变量的拟合值;第二步,利用得到解释变量的拟合值对原模型进行最小二乘法,从而得到方程模型的估计值,这样就可以消除内生性的影响。
首先了解一下二阶段最小二乘法Stata中的命令为ivregress,语法格式为
选项介绍
depvardepvar 为被解释变量;
varlist1为外生解释变量;
varlist2 为所有的内生解释变量;
varlist_iv为所有的工具变量;
在选项 options 中,
vce(robust)表示稳健型标准误
可使用 first 选项报告 2SLS 中第一阶段的回归结果
5
操作应用
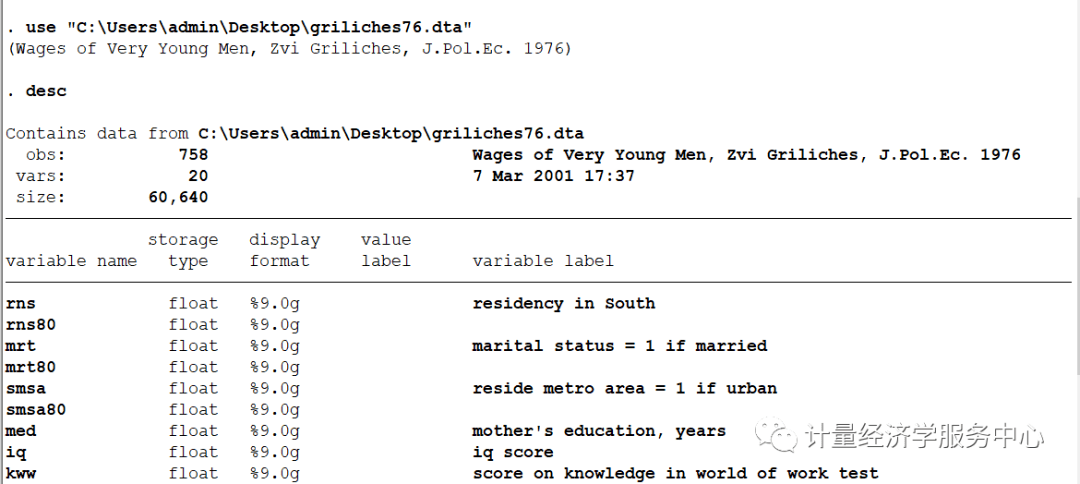
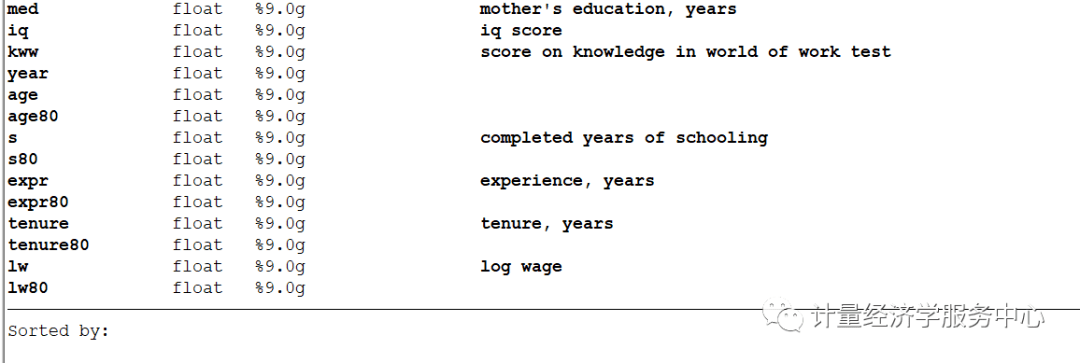
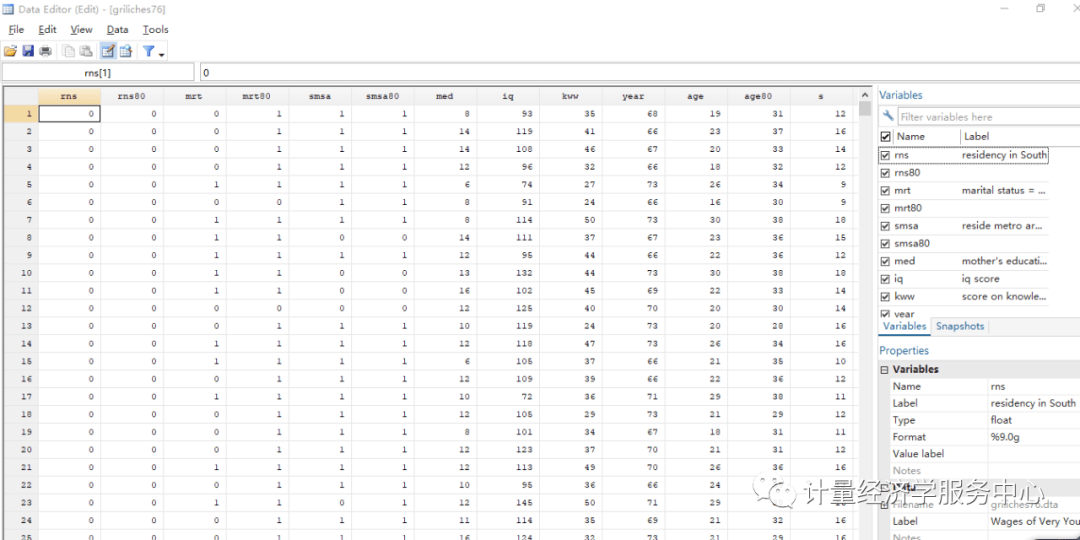
本文以griliches76.dta为例,研究工资影响因素。
背景介绍:
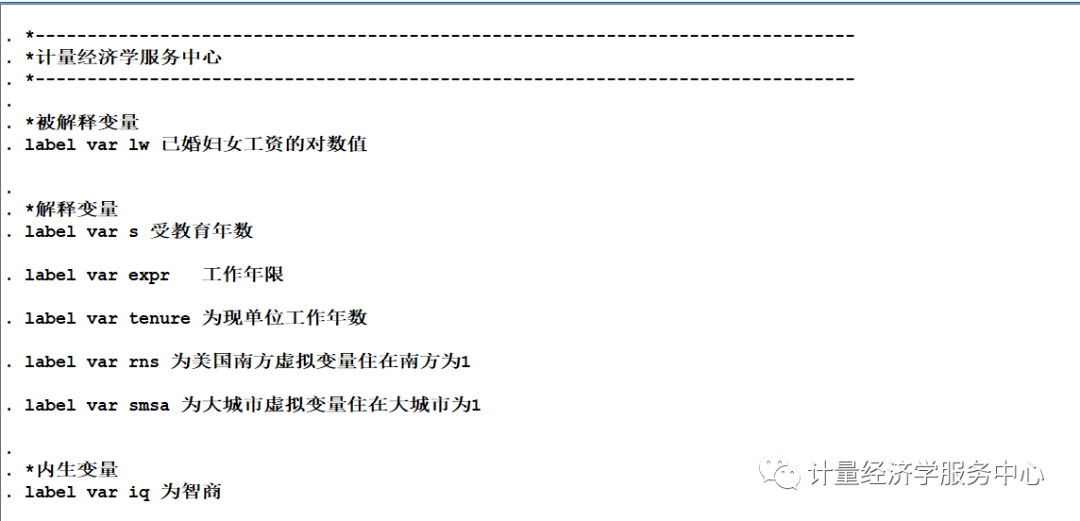
其中研究问题为:建立lw与 受教育年数、 工作年限、 现单位工作年数、 美国南方虚拟变量、 大城市虚拟变量的方程,但是 包括了影响已婚妇女工资的遗漏变量,可能存在内生性问题,其中 能力 会对工资产生影响,但是却与解释变量X中的educ相关,内生性存在。
因此需要寻找与 能力 相关,但是与误差项不相关的工具变量,认为已婚妇女的母亲的受教育年数跟已婚妇女的教育年限相关的,而这两个变量与已婚妇女的 能力 相关,可以替代原来内生变量的信息。因此,可以作为 educ的工具变量。另外还有职业测试成绩kww 、年龄、婚姻状况也作为工具变量。
相关数据介绍如下:
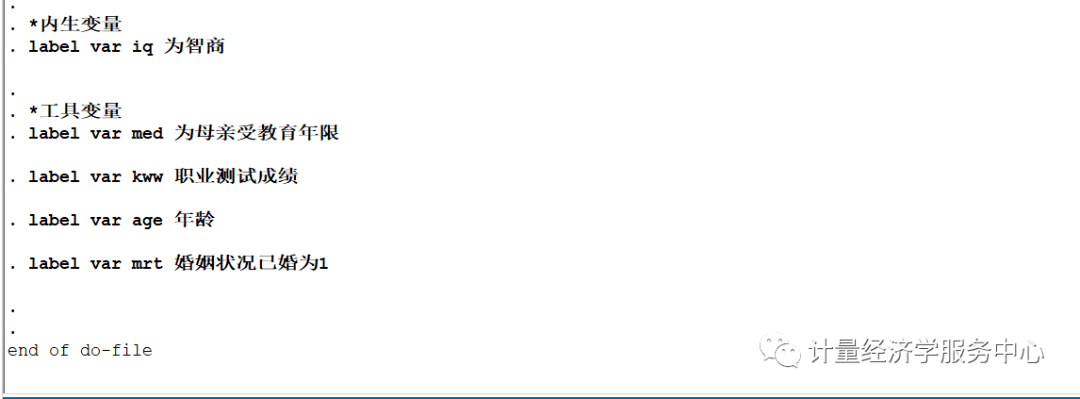
相关操作代码为:
*工具变量法ivreg2 lw s expr tenure rns smsa i.year (iq=med kww age mrt), robustest store iv
结果为:

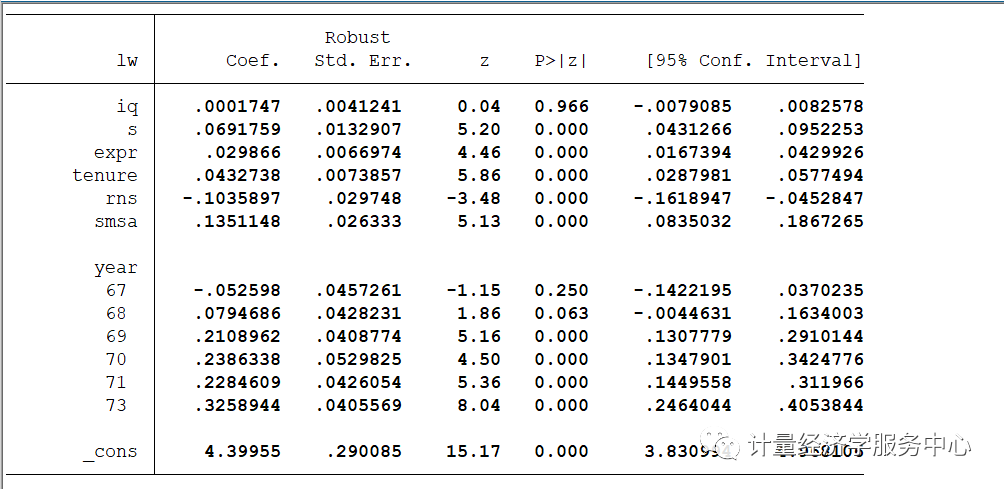
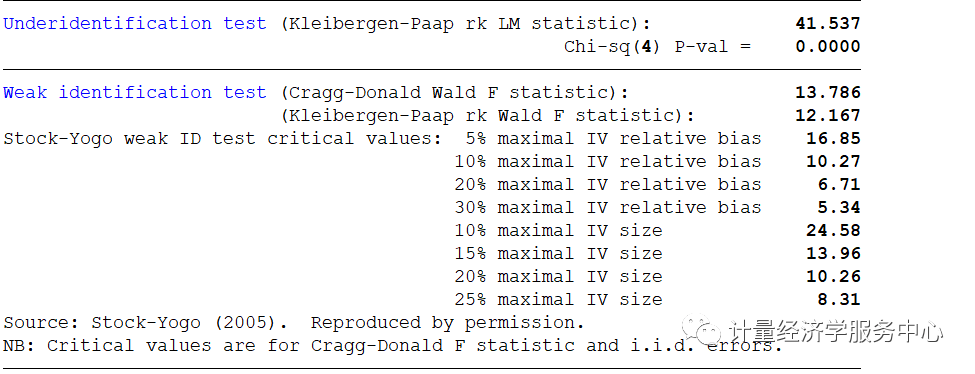
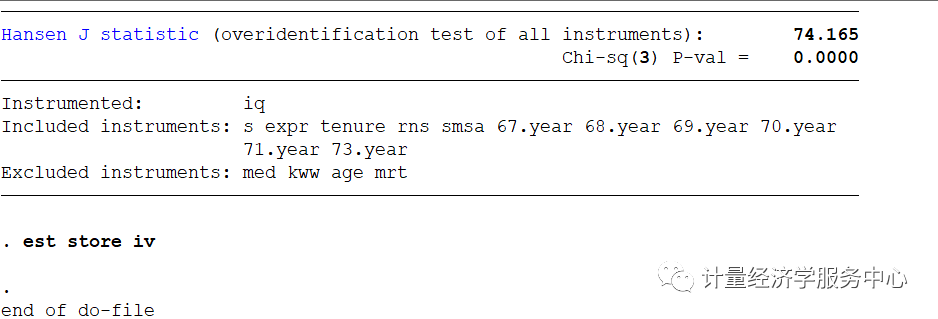
同时展现并对其进行对比,代码为:
结果为:
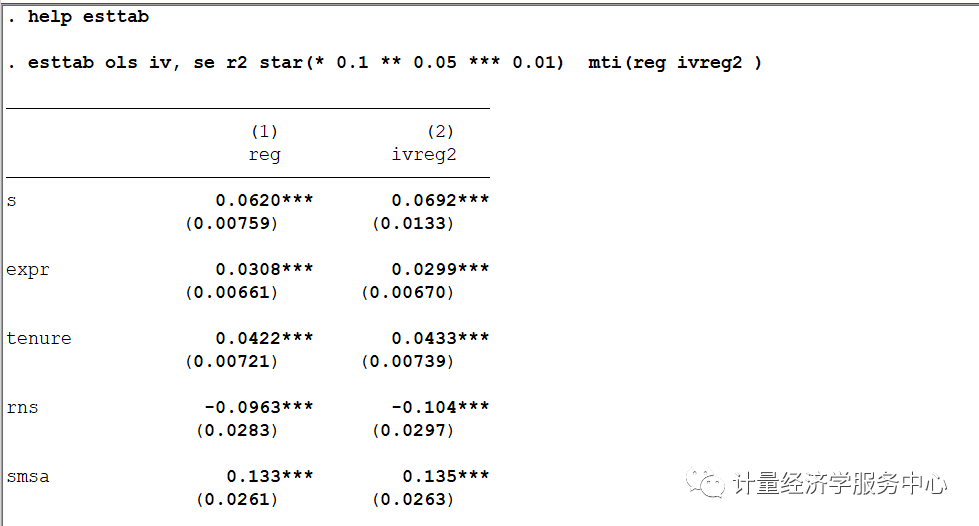
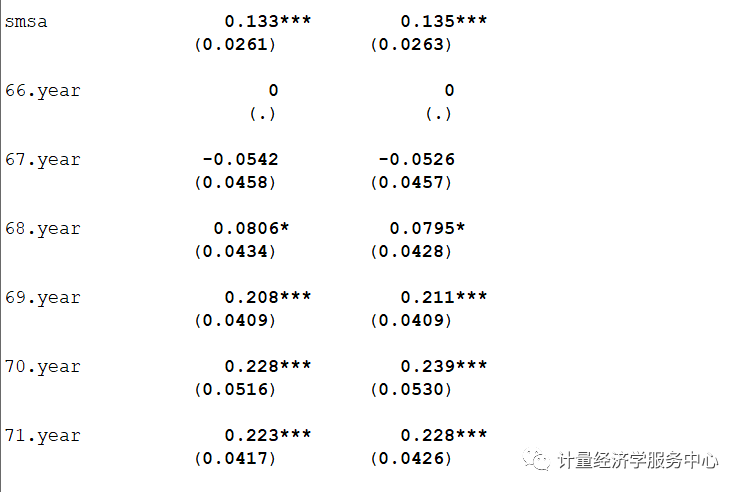
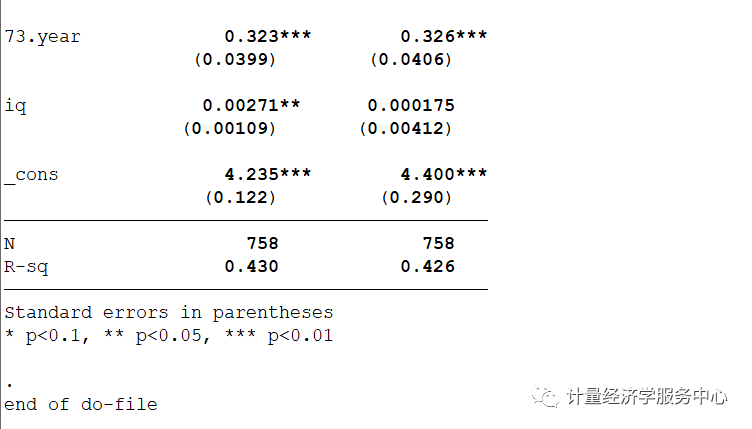
汇报第一阶段回归结果
First-stage regressions-----------------------
First-stage regression of iq:
Statistics consistent for homoskedasticity onlyNumber of obs = 758------------------------------------------------------------------------------iq | Coef. Std. Err. t P>|t| [95% Conf. Interval]-------------+----------------------------------------------------------------med | .2877745 .1622338 1.77 0.077 -.0307176 .6062665kww | .4581116 .0699323 6.55 0.000 .3208229 .5954003age | -.8809144 .2232535 -3.95 0.000 -1.319198 -.4426307mrt | -.584791 .946056 -0.62 0.537 -2.442056 1.272474s | 2.497742 .2858159 8.74 0.000 1.936638 3.058846expr | -.033548 .2534458 -0.13 0.895 -.5311042 .4640082tenure | .6158215 .2731146 2.25 0.024 .0796522 1.151991rns | -2.610221 .9499731 -2.75 0.006 -4.475177 -.7452663smsa | .0260481 .9222585 0.03 0.977 -1.784499 1.836595|year |67 | .9254935 1.655969 0.56 0.576 -2.325449 4.17643668 | .4706951 1.574561 0.30 0.765 -2.620429 3.5618269 | 2.164635 1.521387 1.42 0.155 -.8221007 5.1513770 | 5.734786 1.696033 3.38 0.001 2.405191 9.06438171 | 5.180639 1.562156 3.32 0.001 2.113866 8.24741173 | 4.526686 1.48294 3.05 0.002 1.615429 7.437943|_cons | 67.20449 4.107281 16.36 0.000 59.14121 75.26776------------------------------------------------------------------------------F test of excluded instruments:F( 4, 742) = 13.79Prob > F = 0.0000Sanderson-Windmeijer multivariate F test of excluded instruments:F( 4, 742) = 13.79Prob > F = 0.0000
Summary results for first-stage regressions-------------------------------------------
(Underid) (Weak id)Variable | F( 4, 742) P-val | SW Chi-sq( 4) P-val | SW F( 4, 742)iq | 13.79 0.0000 | 56.33 0.0000 | 13.79
Stock-Yogo weak ID F test critical values for single endogenous regressor:5% maximal IV relative bias 16.8510% maximal IV relative bias 10.2720% maximal IV relative bias 6.7130% maximal IV relative bias 5.3410% maximal IV size 24.5815% maximal IV size 13.9620% maximal IV size 10.2625% maximal IV size 8.31Source: Stock-Yogo (2005). Reproduced by permission.NB: Critical values are for Sanderson-Windmeijer F statistic.
Underidentification testHo: matrix of reduced form coefficients has rank=K1-1 (underidentified)Ha: matrix has rank=K1 (identified)Anderson canon. corr. LM statistic Chi-sq(4)=52.44 P-val=0.0000
Weak identification testHo: equation is weakly identifiedCragg-Donald Wald F statistic 13.79
Stock-Yogo weak ID test critical values for K1=1 and L1=4:5% maximal IV relative bias 16.8510% maximal IV relative bias 10.2720% maximal IV relative bias 6.7130% maximal IV relative bias 5.3410% maximal IV size 24.5815% maximal IV size 13.9620% maximal IV size 10.2625% maximal IV size 8.31Source: Stock-Yogo (2005). Reproduced by permission.
Weak-instrument-robust inferenceTests of joint significance of endogenous regressors B1 in main equationHo: B1=0 and orthogonality conditions are validAnderson-Rubin Wald test F(4,742)= 24.23 P-val=0.0000Anderson-Rubin Wald test Chi-sq(4)= 98.99 P-val=0.0000Stock-Wright LM S statistic Chi-sq(4)= 87.56 P-val=0.0000
Number of observations N = 758Number of regressors K = 13Number of endogenous regressors K1 = 1Number of instruments L = 16Number of excluded instruments L1 = 4
IV (2SLS) estimation--------------------
Estimates efficient for homoskedasticity onlyStatistics consistent for homoskedasticity only
Number of obs = 758F( 12, 745) = 45.91Prob > F = 0.0000Total (centered) SS = 139.2861498 Centered R2 = 0.4255Total (uncentered) SS = 24652.24662 Uncentered R2 = 0.9968Residual SS = 80.0182337 Root MSE = .3249
------------------------------------------------------------------------------lw | Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------iq | .0001747 .0039035 0.04 0.964 -.007476 .0078253s | .0691759 .0129366 5.35 0.000 .0438206 .0945312expr | .029866 .0066393 4.50 0.000 .0168533 .0428788tenure | .0432738 .0076271 5.67 0.000 .0283249 .0582226rns | -.1035897 .029481 -3.51 0.000 -.1613715 -.0458079smsa | .1351148 .0266573 5.07 0.000 .0828674 .1873623|year |67 | -.052598 .0476924 -1.10 0.270 -.1460734 .040877468 | .0794686 .0447194 1.78 0.076 -.0081797 .167116969 | .2108962 .0439336 4.80 0.000 .1247878 .297004570 | .2386338 .0509733 4.68 0.000 .1387281 .338539671 | .2284609 .0437436 5.22 0.000 .1427251 .314196773 | .3258944 .0407181 8.00 0.000 .2460884 .4057004|_cons | 4.39955 .2685443 16.38 0.000 3.873213 4.925887------------------------------------------------------------------------------Underidentification test (Anderson canon. corr. LM statistic): 52.436Chi-sq(4) P-val = 0.0000------------------------------------------------------------------------------Weak identification test (Cragg-Donald Wald F statistic): 13.786Stock-Yogo weak ID test critical values: 5% maximal IV relative bias 16.8510% maximal IV relative bias 10.2720% maximal IV relative bias 6.7130% maximal IV relative bias 5.3410% maximal IV size 24.5815% maximal IV size 13.9620% maximal IV size 10.2625% maximal IV size 8.31Source: Stock-Yogo (2005). Reproduced by permission.------------------------------------------------------------------------------Sargan statistic (overidentification test of all instruments): 87.655Chi-sq(3) P-val = 0.0000------------------------------------------------------------------------------Instrumented: iqIncluded instruments: s expr tenure rns smsa 67.year 68.year 69.year 70.year71.year 73.yearExcluded instruments: med kww age mrt------------------------------------------------------------------------------
. end of do-file
.
6
Hausman检验
刚才我们讲到的是方程中的解释变量为内生变量,也就是发生了内生性,但是如何检验方程中的解释变量包含内生变量呢?因为如果方程中不包含内生变量,那么我们可以认为OLS估计是最好的,也就不需要在使用工具变量IV估计了。
Hausman检验的一个假设就是若解释变量具有内生性,则两种方法的估计量并不相同。通俗来说,就是Hausman检验是通过对内生解释变量与随机误差项相关的检验,来帮助我们判断一个变量是否为内生变量,原假设为Cov(X,ui)=0,意思是若X为外生变量。若是拒绝原假设,则说明内生性问题的存在,Hausman检验一般根据统计值的概率与0.05比较。
Hausman检验的基本语法格式为:
hausmanname-consistent [name-efficient] [, options]
其中hausman表示hausman检验,而name-consistent表示一直估计量的变量名,而name-efficient表示有效估计量的变量名,主意这两个变量名的顺序不能颠倒。Option选项的constant 表述包含常数项,默认不包含常数项,然后sigmamore表示统一使用更有效的估计量
然后基本的语法汇总为:
reg y x1 x2
eststore ols
ivregress2sls y x1 (x2=z1 z2)
eststore iv
hausman iv ols ,constant sigmamore
注意:此部分命令主要结合 工具变量法:Stata操作及应用
7
过度识别检验
该假设的条件为所有有效的工具变量的个数与内生解释变量一样多,或者说是这个所有的工具变量都是外生的。
若是Sargan-Basman检验的统计量对应的p值大于0.05,则认为所有的工具变量都是外生的,也就是有效的,反之则是无效的。(原假设是所有工具变量是外生的,若是p值小于0.05,则拒绝原假设)
注意:此部分命令主要结合 工具变量法:Stata操作及应用
下面我们来看 Sargan 统计量的结果。
不加选项robust
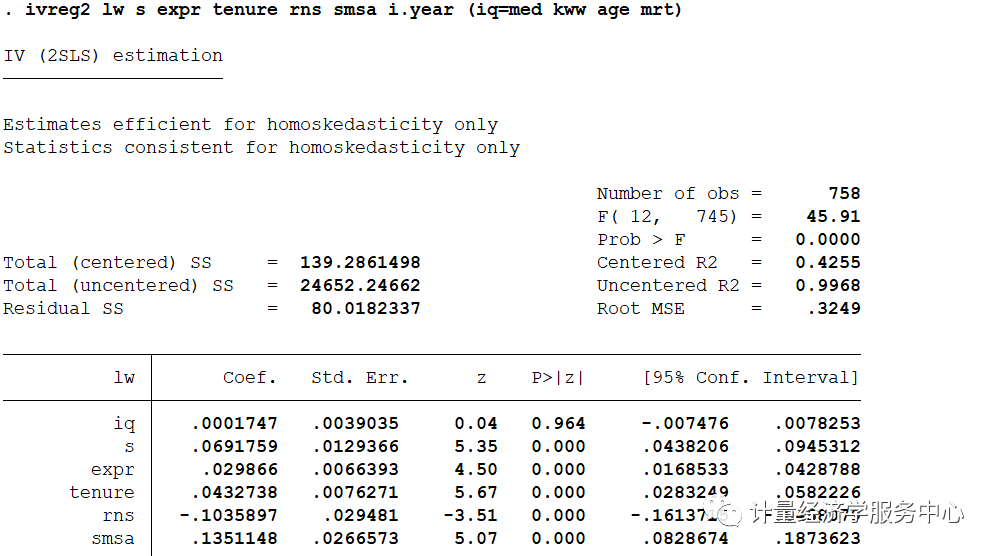
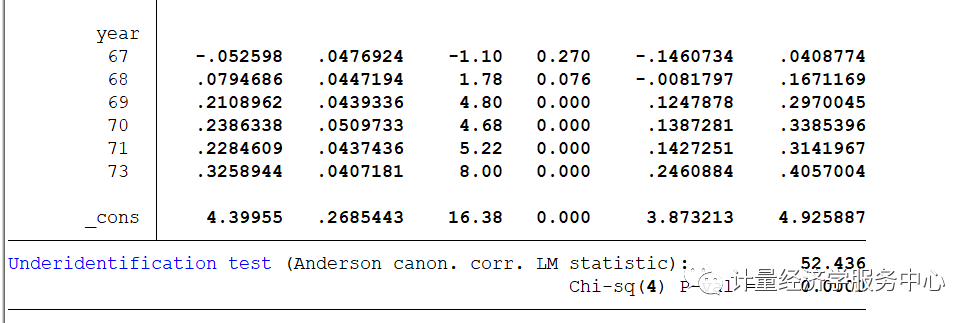

也可以使用如下命令
使用ivreg2 lw s expr tenure rns smsa i.year (iq=med kww age mrt), gmm2s orthog(age mrt)
可以来检验工具变量的外生性
结果为:
2-StepGMM estimation---------------------
Estimatesefficient for homoskedasticity onlyStatisticsconsistent for homoskedasticity only
Numberof obs = 758F(12, 745) = 45.91Prob> F = 0.0000Total(centered) SS = 139.2861498 Centered R2 = 0.4255Total(uncentered) SS = 24652.24662 Uncentered R2 = 0.9968ResidualSS = 80.0182337 Root MSE = .3249
------------------------------------------------------------------------------lw| Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------iq| .0001747 .0039035 0.04 0.964 -.007476 .0078253s| .0691759 .0129366 5.35 0.000 .0438206 .0945312expr| .029866 .0066393 4.50 0.000 .0168533 .0428788tenure| .0432738 .0076271 5.67 0.000 .0283249 .0582226rns| -.1035897 .029481 -3.51 0.000 -.1613715 -.0458079smsa| .1351148 .0266573 5.07 0.000 .0828674 .1873623|year|67| -.052598 .0476924 -1.10 0.270 -.1460734 .040877468| .0794686 .0447194 1.78 0.076 -.0081797 .167116969| .2108962 .0439336 4.80 0.000 .1247878 .297004570| .2386338 .0509733 4.68 0.000 .1387281 .338539671| .2284609 .0437436 5.22 0.000 .1427251 .314196773| .3258944 .0407181 8.00 0.000 .2460884 .4057004|_cons| 4.39955 .2685443 16.38 0.000 3.873213 4.925887------------------------------------------------------------------------------Underidentificationtest (Anderson canon. corr. LM statistic): 52.436Chi-sq(4)P-val = 0.0000------------------------------------------------------------------------------Weakidentification test (Cragg-Donald Wald F statistic): 13.786Stock-Yogoweak ID test critical values: 5% maximal IV relative bias 16.8510%maximal IV relative bias 10.2720%maximal IV relative bias 6.7130%maximal IV relative bias 5.3410%maximal IV size 24.5815%maximal IV size 13.9620%maximal IV size 10.2625%maximal IV size 8.31Source: Stock-Yogo (2005). Reproduced by permission.------------------------------------------------------------------------------Sarganstatistic (overidentification test of all instruments): 87.655Chi-sq(3)P-val = 0.0000-orthog-option:Sarganstatistic (eqn. excluding suspect orthogonality conditions): 1.036Chi-sq(1)P-val = 0.3087Cstatistic (exogeneity/orthogonality of suspect instruments): 86.619Chi-sq(2)P-val = 0.0000Instrumentstested: age mrt------------------------------------------------------------------------------Instrumented: iqIncludedinstruments: s expr tenure rns smsa 67.year 68.year 69.year 70.year71.year73.yearExcludedinstruments: med kww age mrt------------------------------------------------------------------------------
.
8
弱工具变量的检验
我们回顾一下,找到的工具变量需要能够很好的代表内生解释变量的信息,也就是工具变量与内生解释变量的相关性,若是内生解释变量与工具变量只存在微弱的相关性,这就存在弱工具变量问题了。如何检验呢,在2SLS后用estat firststage命令来检验若工具变量的问题,若是对应的统计量的概率值小于0.05,则认为工具变量是合适的,是一个较好的工具变量,反之则认为存在弱工具变量的问题 。
我们回顾一下,找到的工具变量需要能够很好的代表内生解释变量的信息,也就是工具变量与内生解释变量的相关性,若是内生解释变量与工具变量只存在微弱的相关性,这就存在弱工具变量问题了。如何检验呢,在2SLS后用estat firststage命令来检验弱工具变量的问题,若是对应的统计量的概率值小于0.05,则认为工具变量是合适的,是一个较好的工具变量,反之则认为存在弱工具变量的问题 。
上述弱工具变量的检验其实也是这个检验有效工具变量的另外一个条件,主要考察工具变量与内生变量的相关性。
命令为:
estatfirststage,all forcenonrobust
如果存在弱工具变量该怎么办?
1. 如果有很多工具变量,有部分强工具变量和部分弱工具变量,可以舍弃较弱的工具变量而选用相关性较强的工具变量子集。在stata中,可以使用ivreg2命令进行“冗余检验”,以决定选择舍弃哪个工具变量。(直观上,冗余工具变量是那些第一阶段回归中不显著的变量。)
第二个选择是利用弱工具变量继续进行实证分析,但采用的方法不再是2SLS。而是对弱工具变量不太敏感的有限信息极大似然法(LIML)。在大样本下,LIML 与2SLS是渐近等价的,但在存在弱工具变量的情况下,LIML 的小样本性质可能优于2SLS。LIML的 Stata 命令为 ivregress liml depvar[varlist1] (varlist2 =instlist)
9
工具变量与内生性do文档
*下载安装外部命令sscinst ivreg2, replacesscinst estout, replace
*查看导入数据usehttp://fmwww.bc.edu/ec-p/data/hayashi/griliches76.dta, cleareditdesc
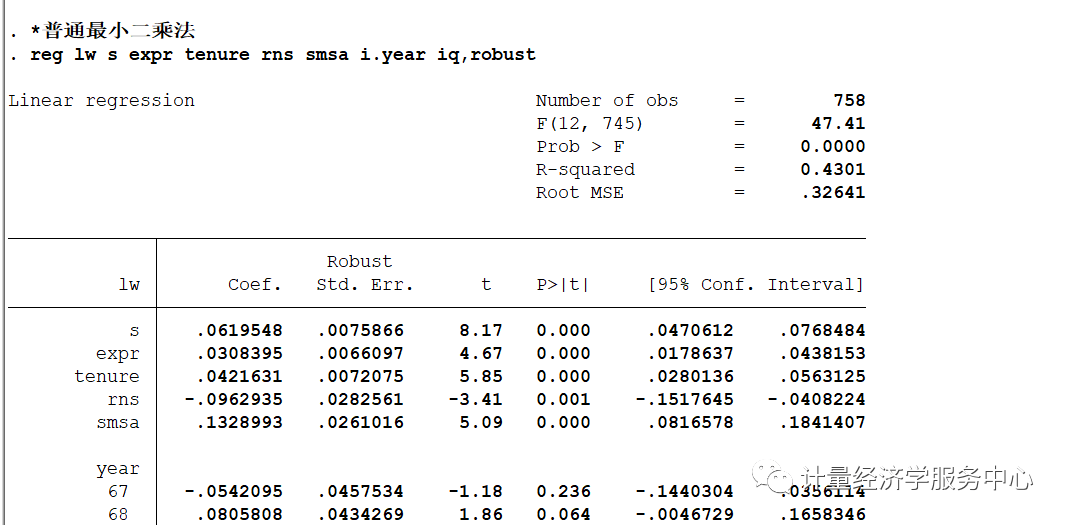
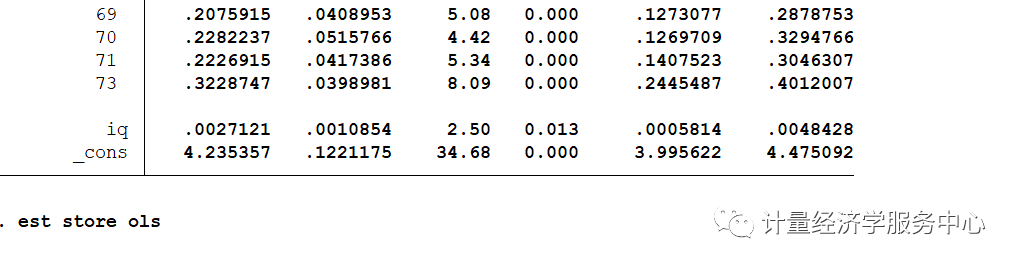
*普通最小二乘法reglw s expr tenure rns smsa i.year iq,robusteststore ols
*工具变量法ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt), robusteststore iv
*输出回归结果helpesttabesttabols iv, se r2 star(* 0.1 ** 0.05 *** 0.01) mti(reg ivreg2 )
*汇报一阶段回归结果ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt), first
*豪斯曼检验*普通最小二乘法reglw s expr tenure rns smsa i.year iqeststore ols
*工具变量法ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt)eststore ivhausmaniv ols
*-Sargan检验ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt)
*-HansenJ 检验ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt), robust*-C统计量ivreg2lw s expr tenure rns smsa i.year (iq=med kww age mrt), gmm2s orthog(age mrt)返回搜狐,查看更多