Yiqing Xu(http://yiqingxu.org/index.html)写了一篇关于“广义合成控制法”的论文,内容详见Main Reference: Xu, Yiqing, 2017. “Generalized Synthetic Control Method: Causal Inference with Interactive Fixed Effects Models.” Political Analysis, Volume 25, Issue 1, January 2017, pp. 57-76. Available at: http://dx.doi.org/10.1017/pan.2016.2.
本文主要进行广义合成控制法gsynth及R操作和应用。
1、您可以直接从CRAN安装gsynth
也可以在R控制台输入以下命令:install.packages('gsynth', type = 'source')
gsynth依赖于以下软件包(还安装相依关系‘reshape’, ‘iterators’, ‘GGally’, ‘doParallel’, ‘foreach’, ‘RcppArmadillo’),这些包将在安装gsynth时自动安装;你也可以手动安装。
2、数据
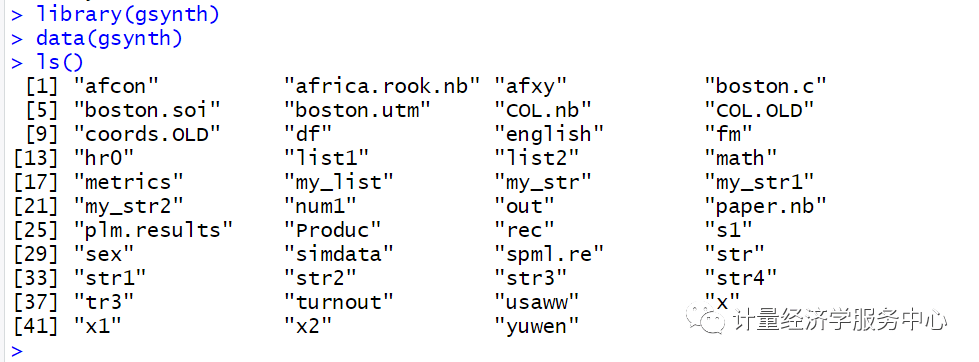
两个数据集simdata和turnout与gsynth包一起安装货。加载这两个数据集:
3、查看数据
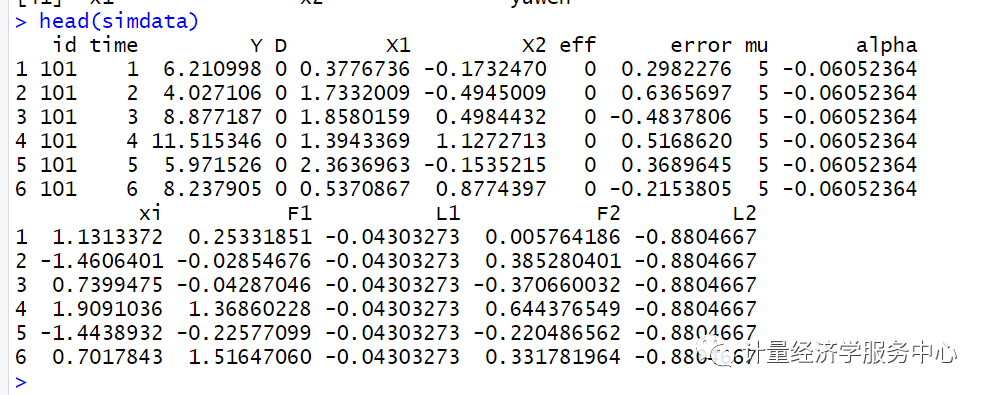
我们从第一个例子开始,一个在论文中描述的模拟数据集。共有5个处理组、45个对照单元和30个时间段。所有处理组从第21期开始。
4、估计
我们仅使用结果变量Y、处理变量D、观察到的两个协变量X1和X2(以及组别指标id和时间)来估计模型。
现在我们正式运行gsynth算法。公式右边的第一个变量是一个01处理变量。其余的右手边变量用作控制变量。索引选项指定单位和时间。
force选项(“none”, “unit”, “time”, and “two-way”)指定了模型中包含的固定效果的附加成分。默认选项是“unit”(包括附加单位固定效果)。
当需要不确定度估计时,设se = TRUE。当处理单元的数目很小时,参数自举程序是首选的。或者,可以通过设置inference = "nonparametric"来使用非参数引导过程;只有处理组比较大时,如Ntr>40)才有效。运行引导程序的次数是由nboot设置的。
在处理集群数据时,例如,具有区域集群单元的面板数据,可以通过在cl选项中指定集群变量的名称来使用集群引导过程。例如,cl = "state"表示城市级别的数据。

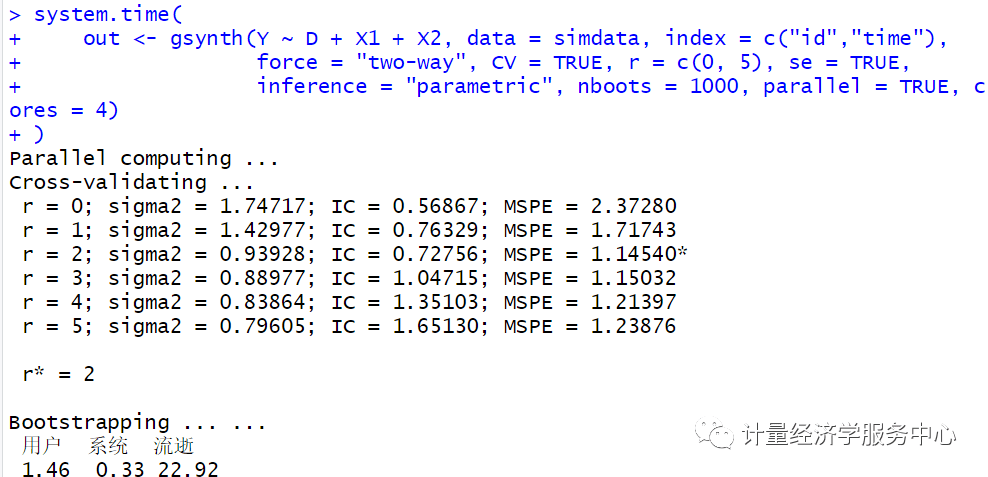
由于gsynth的核心函数是用c++编写的,所以算法运行速度相对较快。在iMac(2016款)上,整个过程(包括交叉验证和1000次引导运行)大约需要6秒。
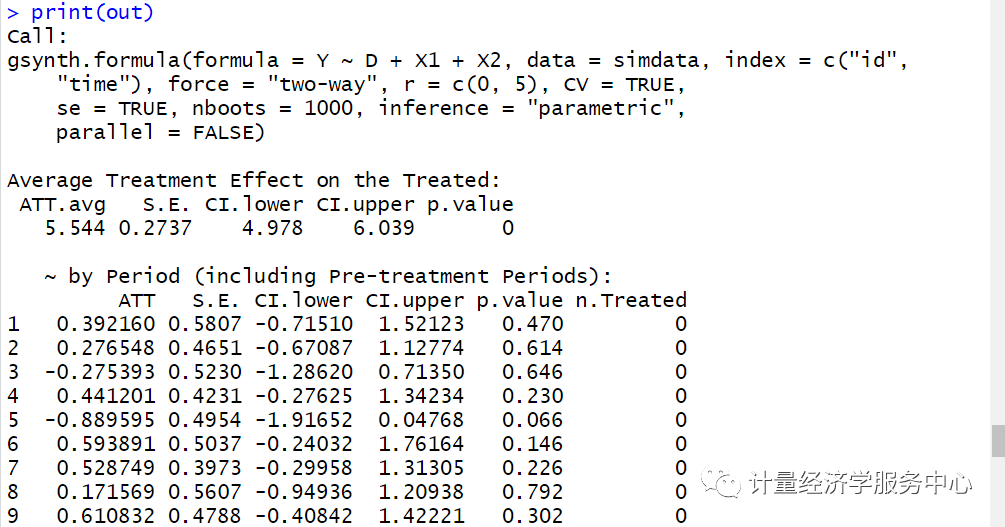
算法会自动打印出结果。sigma2表示误差项的估计方差;IC表示贝叶斯信息准则;MPSE是均方预测误差。交叉验证过程选择一个最小化MSPE的r。
用户可以使用print函数来可视化结果,或者通过直接访问gsynth对象来检索数字。ATT报告了按时期处理(ATT)的平均处理效果;avg表示所有时期的平均ATT;est.beta报告了时变协变量的系数。每次自举运行的处理效果估计都存储在eff中。
输出结果
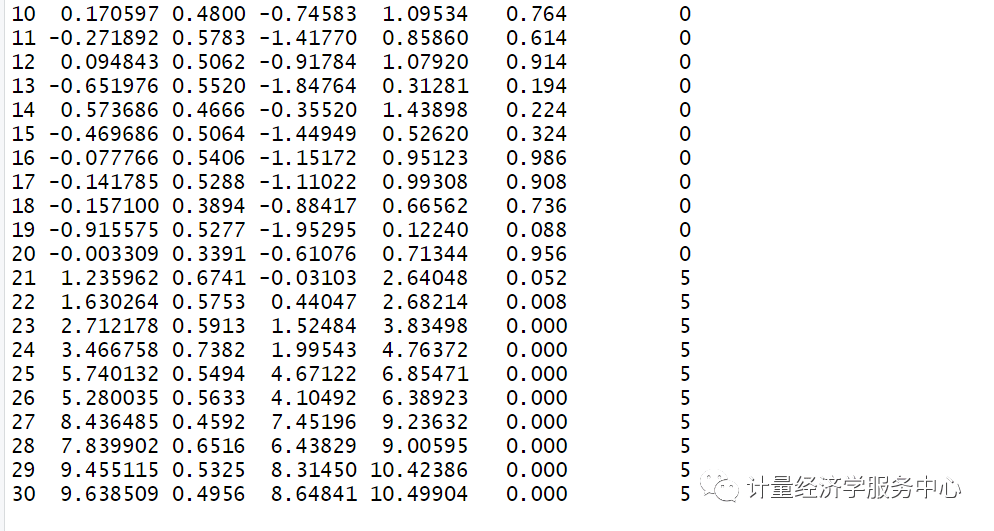
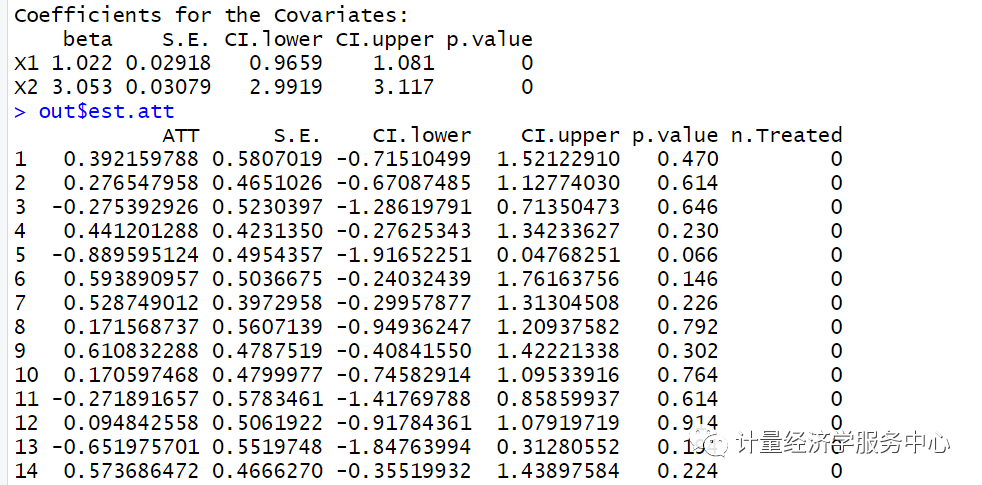
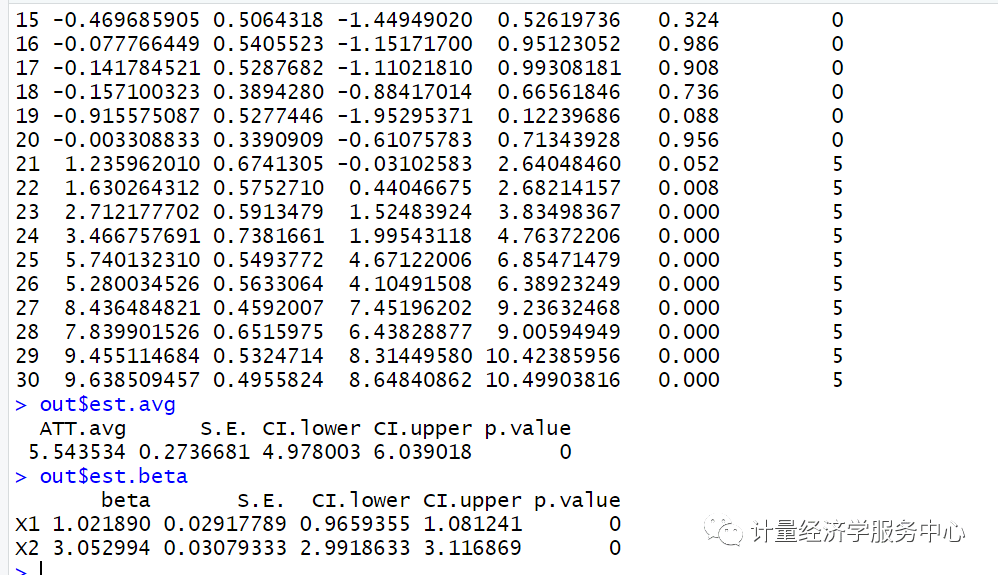
gsynth还包含了再抽样方法——Jackknife (刀切法)
cumu1 <- cumuEff(out, cumu = TRUE, id = NULL, period = c(0,5))cumu1$est.catt
cumu2 <- cumuEff(out, cumu = FALSE, id = c(101, 102, 103), period = c(0,5))cumu2$est.catt
5、Plot结果
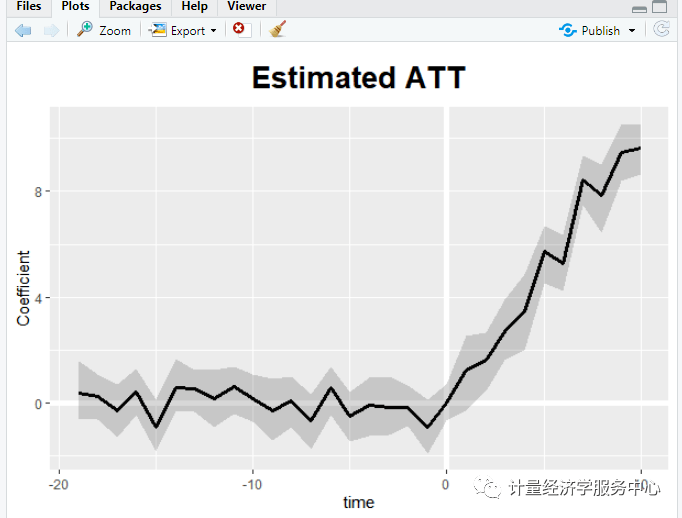
默认情况下,plot函数生成一个“间隙”图——就像我们键入plot(out, type =“gap”)一样——它可视化了按周期估计的ATT。simdata的真实效果在21到30期间从1到10(加上一些白噪声)。您可以通过将打印定向到对象名称来保存图形(ggplot2对象)。
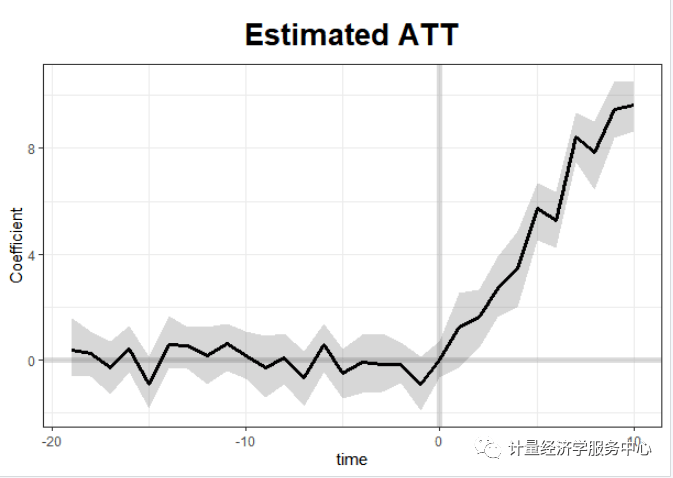
黑白主题也有:
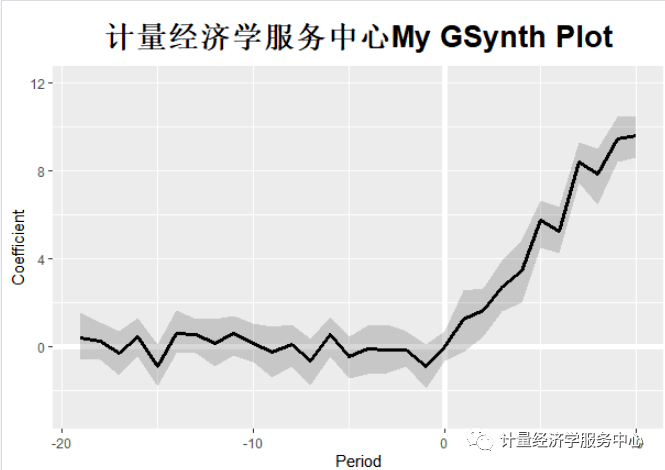
用户可以调整xlim和ylim,并提供标题和两个轴的标题。
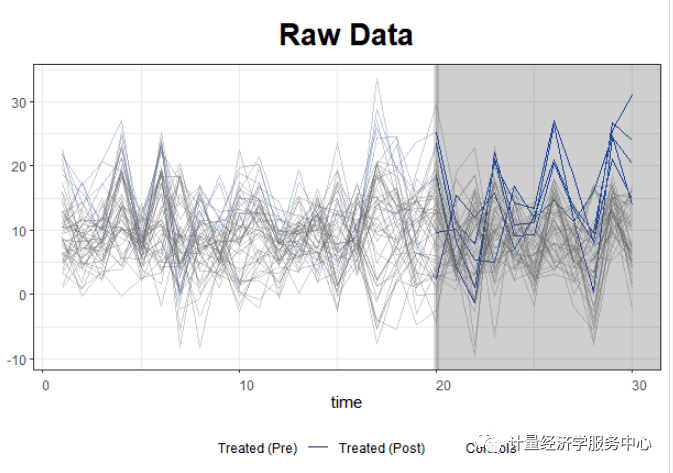
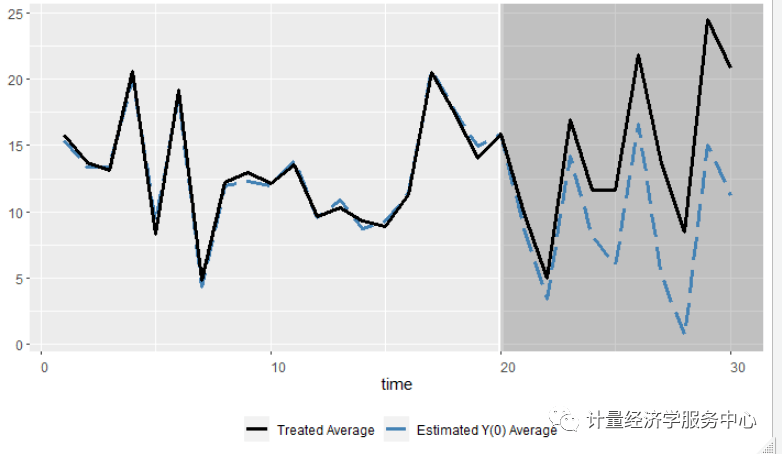
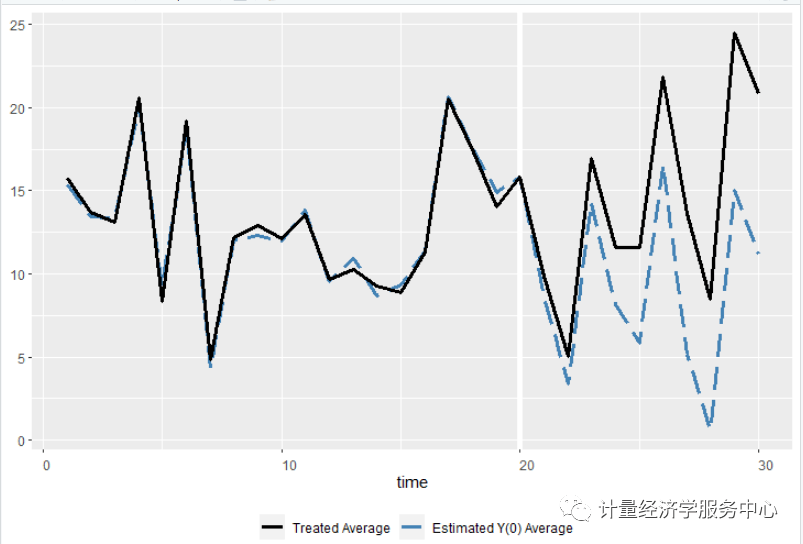
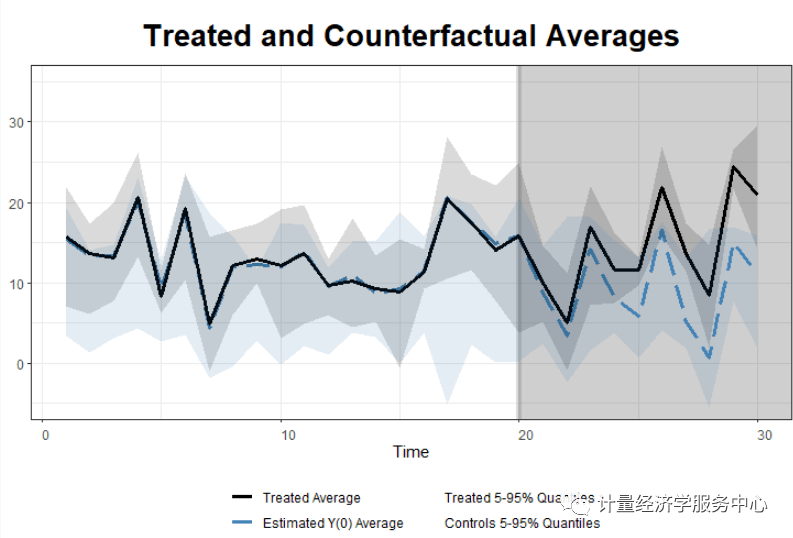
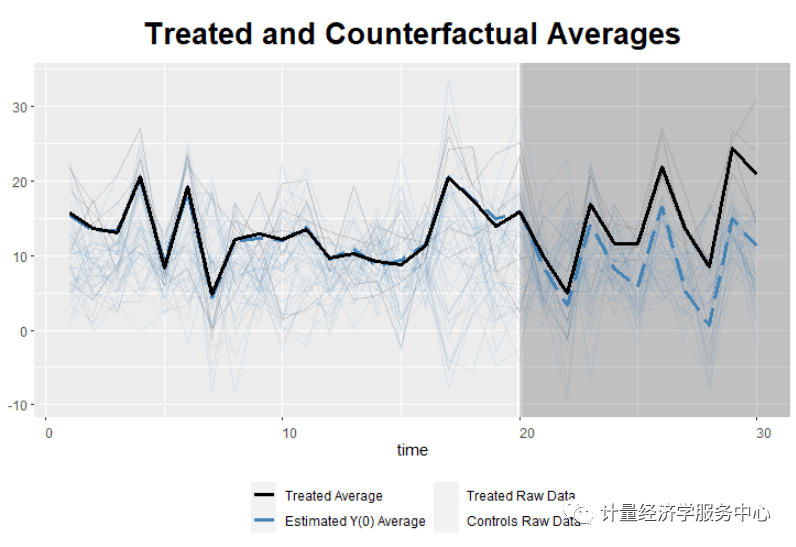
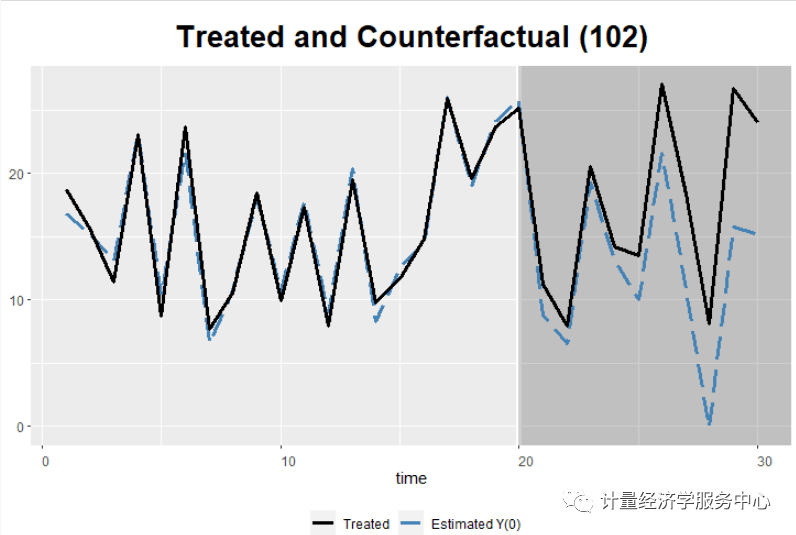
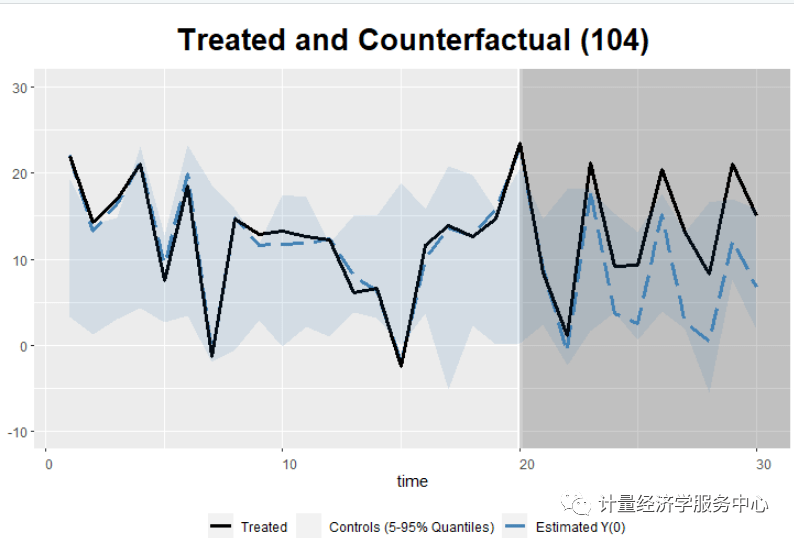
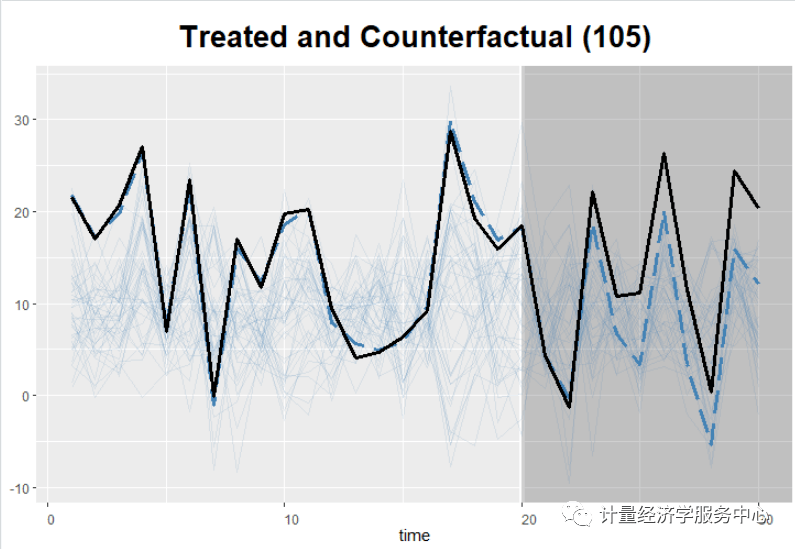
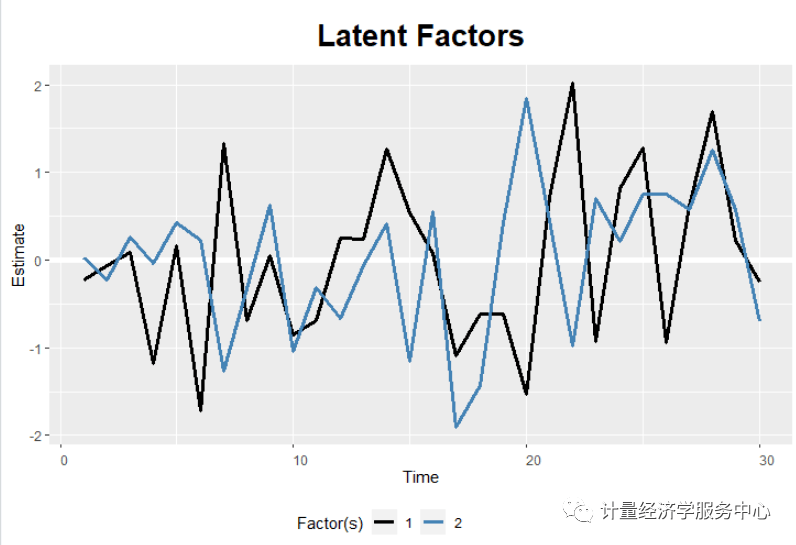
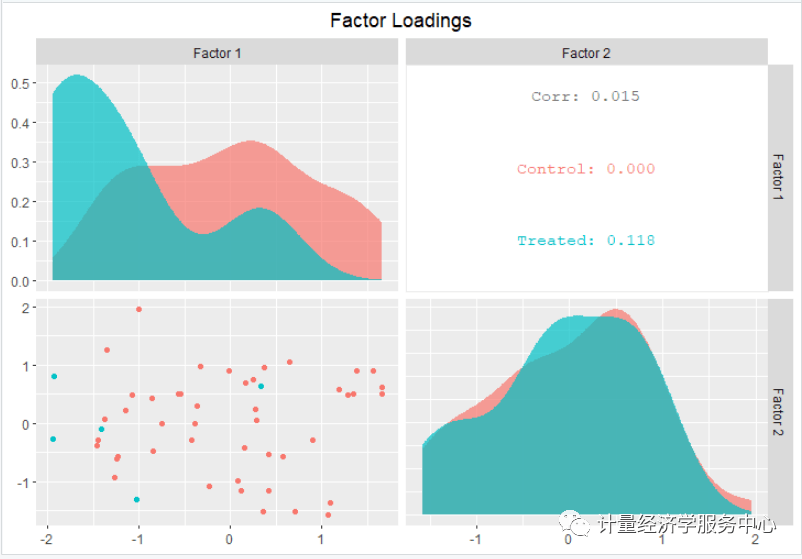
其他四个类型选项包括“raw”,它像panelView那样绘制原始数据(结果)变量;“反事实”(简称“ct”),将估计的反事实绘制出来;以及“因素”和“负荷”,分别表示估计的因素和负荷。下一个图是一个黑白主题的原始情节。处理(前处理和后处理)和控制单元涂上不同的颜色。
Addtional References:返回搜狐,查看更多
- Gobillon L. and Magnac T., 2016. “Regional Policy Evaluation: Interactive Fixed Effects and Synthetic Controls.” The Review of Economics and Statistics, July 2016, Vol. 98, No. 3, pp. 535–551.
- Athey S, Bayati M, Doudchenko N, et al. Matrix completion methods for causal panel data models[J]. arXiv preprint arXiv:1710.10251, 2017.