转自:程序员历小冰
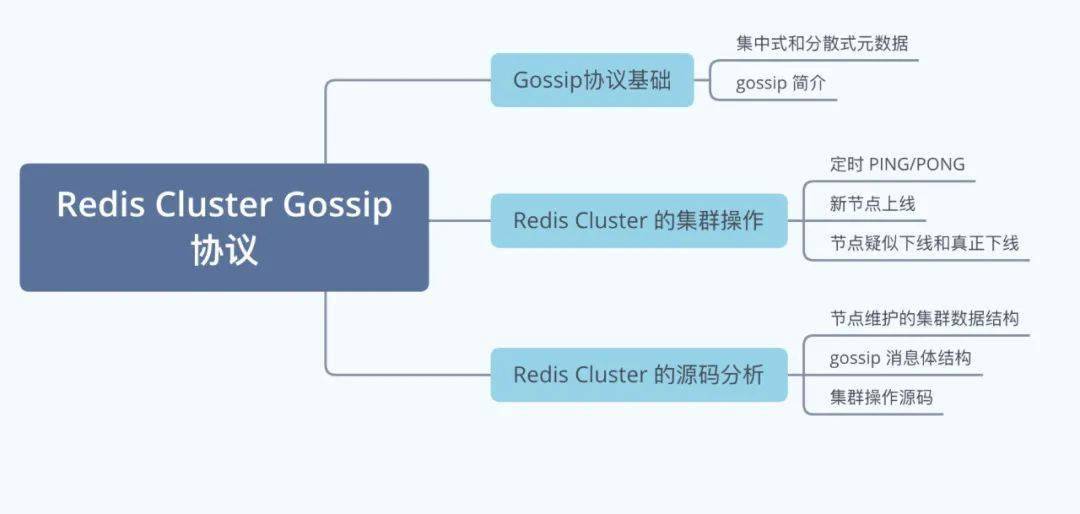
1. 集群模式和 Gossip 简介
对于数据存储领域,当数据量或者请求流量大到一定程度后,就必然会引入分布式。比如 Redis,虽然其单机性能十分优秀,但是因为下列原因时,也不得不引入集群。
- 单机无法保证高可用,需要引入多实例来提供高可用性;
- 单机能够提供高达 8W 左右的 QPS,再高的 QPS 则需要引入多实例;
- 单机能够支持的数据量有限,处理更多的数据需要引入多实例;
- 单机所处理的网络流量已经超过服务器的网卡的上限值,需要引入多实例来分流。
有集群,集群往往需要维护一定的元数据,比如实例的ip地址,缓存分片的 slots 信息等,所以需要一套分布式机制来维护元数据的一致性。这类机制一般有两个模式:分散式和集中式。
分散式机制将元数据存储在部分或者所有节点上,不同节点之间进行不断的通信来维护元数据的变更和一致性。Redis Cluster、Consul 等都是该模式。
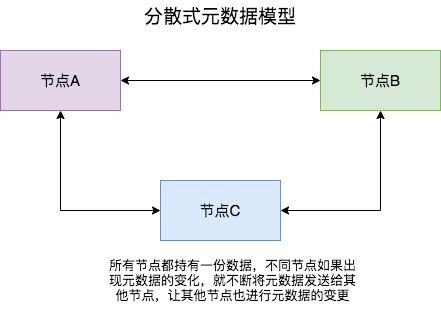
Gossip_model
而集中式是将集群元数据集中存储在外部节点或者中间件上,比如 Zookeeper。旧版本的 Kafka 和 Storm 等都是使用该模式。
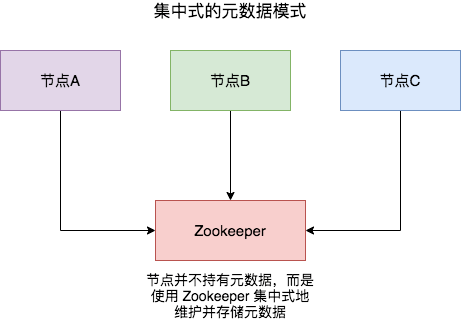
center_model
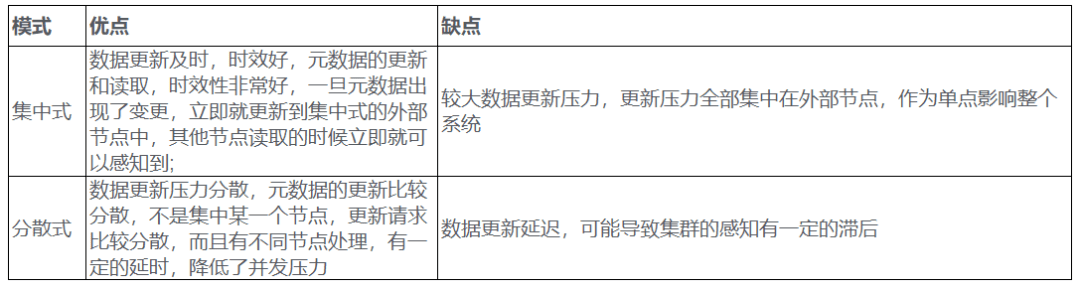
两种模式各有优劣,具体如下表所示:
分散式的元数据模式有多种可选的算法进行元数据的同步,比如说 Paxos、Raft 和 Gossip。Paxos 和 Raft 等都需要全部节点或者大多数节点(超过一半)正常运行,整个集群才能稳定运行,而 Gossip 则不需要半数以上的节点运行。
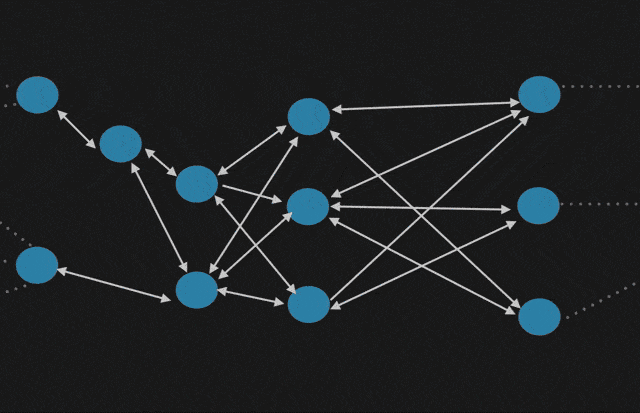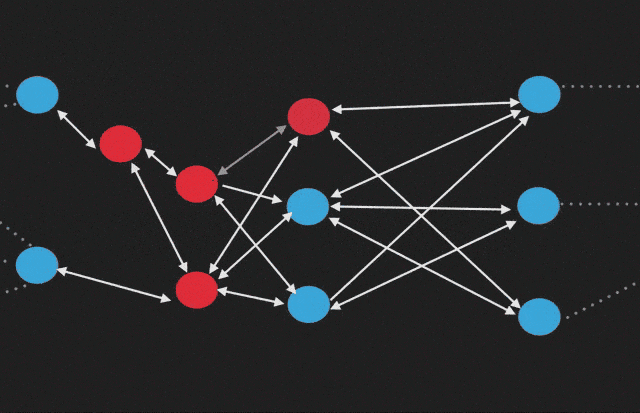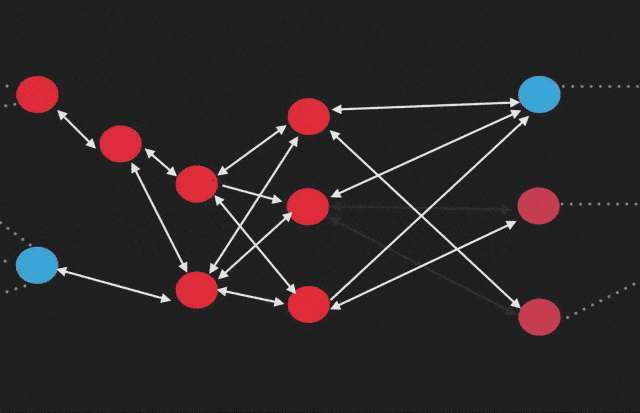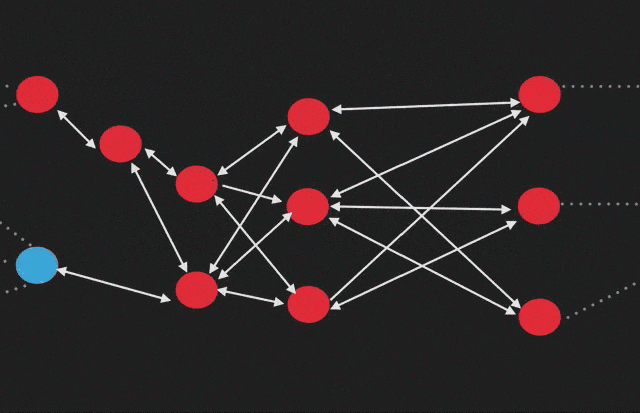
Gossip 协议,顾名思义,就像流言蜚语一样,利用一种随机、带有传染性的方式,将信息传播到整个网络中,并在一定时间内,使得系统内的所有节点数据一致。对你来说,掌握这个协议不仅能很好地理解这种最常用的,实现最终一致性的算法,也能在后续工作中得心应手地实现数据的最终一致性。
Gossip_gif
Gossip 协议又称 epidemic 协议(epidemic protocol),是基于流行病传播方式的节点或者进程之间信息交换的协议,在P2P网络和分布式系统中应用广泛,它的方法论也特别简单:
在一个处于有界网络的集群里,如果每个节点都随机与其他节点交换特定信息,经过足够长的时间后,集群各个节点对该份信息的认知终将收敛到一致。
这里的“特定信息”一般就是指集群状态、各节点的状态以及其他元数据等。Gossip协议是完全符合 BASE 原则,可以用在任何要求最终一致性的领域,比如分布式存储和注册中心。另外,它可以很方便地实现弹性集群,允许节点随时上下线,提供快捷的失败检测和动态负载均衡等。
此外,Gossip 协议的最大的好处是,即使集群节点的数量增加,每个节点的负载也不会增加很多,几乎是恒定的。这就允许 Redis Cluster 或者 Consul 集群管理的节点规模能横向扩展到数千个。
2. Redis Cluster 的 Gossip 通信机制
Redis Cluster 是在 3.0 版本引入集群功能。为了让让集群中的每个实例都知道其他所有实例的状态信息,Redis 集群规定各个实例之间按照 Gossip 协议来通信传递信息。
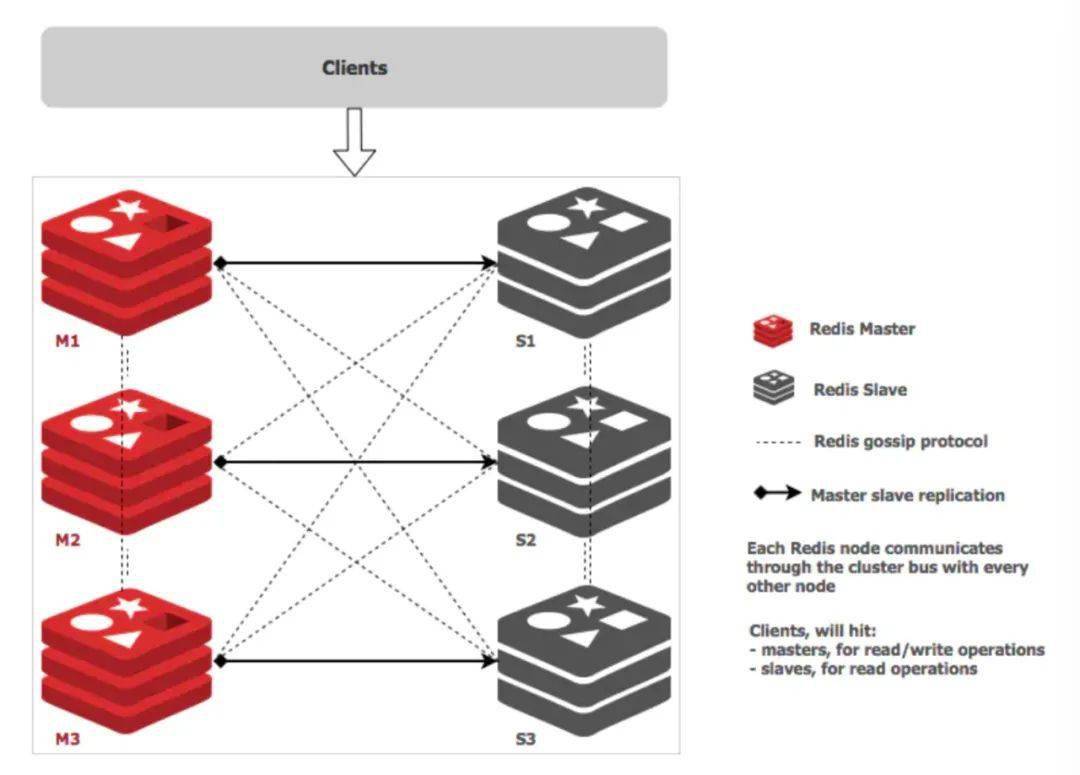
redis_cluster
上图展示了主从架构的 Redis Cluster 示意图,其中实线表示节点间的主从复制关系,而虚线表示各个节点之间的 Gossip 通信。
Redis Cluster 中的每个节点都 维护一份自己视角下的当前整个集群的状态,主要包括:
- 当前集群状态;
- 集群中各节点所负责的 slots 信息,及其 migrate 状态;
- 集群中各节点的 master-slave 状态;
- 集群中各节点的存活状态及怀疑 Fail 状态。
也就是说上面的信息,就是集群中 Node 相互八卦传播流言蜚语的内容主题,而且比较全面,既有自己的更有别人的,这么一来大家都相互传,最终信息就全面而且一致了。
Redis Cluster 的节点之间会相互发送多种消息,较为重要的如下所示:
- MEET:通过「cluster meet ip port」命令,已有集群的节点会向新的节点发送邀请,加入现有集群,然后新节点就会开始与其他节点进行通信;
- PING:节点按照配置的时间间隔向集群中其他节点发送 ping 消息,消息中带有自己的状态,还有自己维护的集群元数据,和部分其他节点的元数据;
- PONG: 节点用于回应 PING 和 MEET 的消息,结构和 PING 消息类似,也包含自己的状态和其他信息,也可以用于信息广播和更新;
- FAIL: 节点 PING 不通某节点后,会向集群所有节点广播该节点挂掉的消息。其他节点收到消息后标记已下线。
Redis 的源码中 cluster.h 文件定义了全部的消息类型,代码为 Redis 4.0版本。
通过上述这些消息,集群中的每一个实例都能获得其它所有实例的状态信息。这样一来,即使有新节点加入、节点故障、Slot 变更等事件发生,实例间也可以通过 PING、PONG 消息的传递,完成集群状态在每个实例上的同步。下面,我们依次来看看几种常见的场景。
2.1 定时 PING/PONG 消息
Redis Cluster 中的节点都会定时地向其他节点发送 PING 消息,来交换各个节点状态信息,检查各个节点状态,包括在线状态、疑似下线状态 PFAIL 和已下线状态 FAIL。
Redis 集群的定时 PING/PONG 的工作原理可以概括成两点:
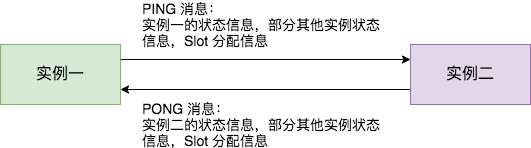
- 一是,每个实例之间会按照一定的频率,从集群中随机挑选一些实例,把 PING 消息发送给挑选出来的实例,用来检测这些实例是否在线,并交换彼此的状态信息。PING 消息中封装了发送消息的实例自身的状态信息、部分其它实例的状态信息,以及 Slot 映射表;
- 二是,一个实例在接收到 PING 消息后,会给发送 PING 消息的实例,发送一个 PONG 消息。PONG 消息包含的内容和 PING 消息一样。
下图显示了两个实例间进行 PING、PONG 消息传递的情况,其中实例一为发送节点,实例二是接收节点:
Gossip_PING
2.2 新节点上线
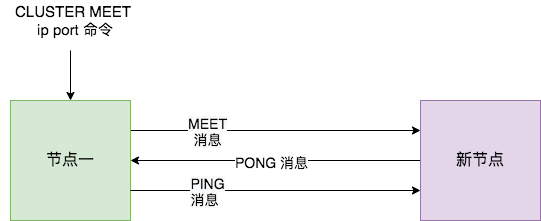
Redis Cluster 加入新节点时,客户端需要执行 CLUSTER MEET 命令,如下图所示。
meet
节点一在执行 CLUSTER MEET 命令时会首先为新节点创建一个 clusterNode 数据,并将其添加到自己维护的 clusterState 的 nodes 字典中。有关 clusterState 和 clusterNode 关系,我们在最后一节会有详尽的示意图和源码来讲解。
然后节点一会根据据 CLUSTER MEET 命令中的 IP 地址和端口号,向新节点发送一条 MEET 消息。新节点接收到节点一发送的MEET消息后,新节点也会为节点一创建一个 clusterNode 结构,并将该结构添加到自己维护的 clusterState 的 nodes 字典中。
接着,新节点向节点一返回一条 PONG 消息。节点一接收到节点B返回的PONG消息后,得知新节点已经成功的接收了自己发送的 MEET 消息。
最后,节点一还会向新节点发送一条 PING 消息。新节点接收到该条 PING 消息后,可以知道节点A已经成功的接收到了自己返回的 PONG 消息,从而完成了新节点接入的握手操作。
MEET 操作成功之后,节点一会通过稍早时讲的定时 PING 机制将新节点的信息发送给集群中的其他节点,让其他节点也与新节点进行握手。最终,经过一段时间后,新节点会被集群中的所有节点认识。
2.3 节点疑似下线和真正下线
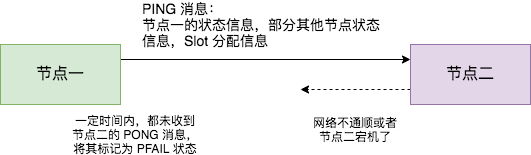
Redis Cluster 中的节点会定期检查已经发送 PING 消息的接收方节点是否在规定时间 ( cluster-node-timeout ) 内返回了 PONG 消息,如果没有则会将其标记为疑似下线状态,也就是 PFAIL 状态,如下图所示。
pfail
然后,节点一会通过 PING 消息,将节点二处于疑似下线状态的信息传递给其他节点,例如节点三。节点三接收到节点一的 PING 消息得知节点二进入 PFAIL 状态后,会在自己维护的 clusterState 的 nodes 字典中找到节点二所对应的 clusterNode 结构,并将主节点一的下线报告添加到 clusterNode 结构的 fail_reports 链表中。
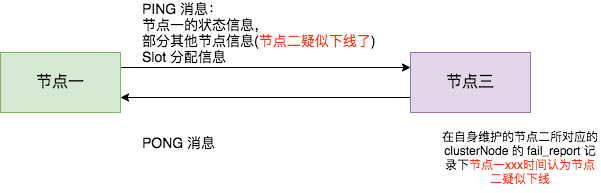
PING_FAIL
随着时间的推移,如果节点十 (举个例子)也因为 PONG 超时而认为节点二疑似下线了,并且发现自己维护的节点二的 clusterNode 的 fail_reports 中有 半数以上的主节点数量的未过时的将节点二标记为 PFAIL 状态报告日志,那么节点十将会把节点二将被标记为已下线 FAIL 状态,并且节点十会 立刻向集群其他节点广播主节点二已经下线的 FAIL 消息,所有收到 FAIL 消息的节点都会立即将节点二状态标记为已下线。如下图所示。
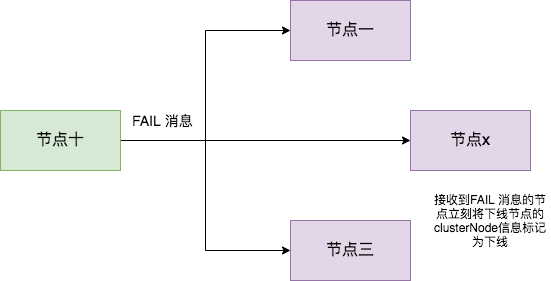
fail
需要注意的是,报告疑似下线记录是由时效性的,如果超过 cluster-node-timeout *2 的时间,这个报告就会被忽略掉,让节点二又恢复成正常状态。
3. Redis Cluster 通信源码实现
综上,我们了解了 Redis Cluster 在定时 PING/PONG、新节点上线、节点疑似下线和真正下线等环节的原理和操作流程,下面我们来真正看一下 Redis 在这些环节的源码实现和具体操作。
3.1 涉及的数据结构体
首先,我们先来讲解一下其中涉及的数据结构,也就是上文提到的 ClusterNode 等结构。
每个节点都会维护一个 clusterState 结构,表示当前集群的整体状态,它的定义如下所示。
它有三个比较关键的字段,具体示意图如下所示:
- myself 字段,是一个 clusterNode 结构,用来记录自己的状态;
- nodes 字典,记录一个 name 到 clusterNode 结构的映射,以此来记录其他节点的状态;
- slot 数组,记录slot 对应的节点 clusterNode结构。
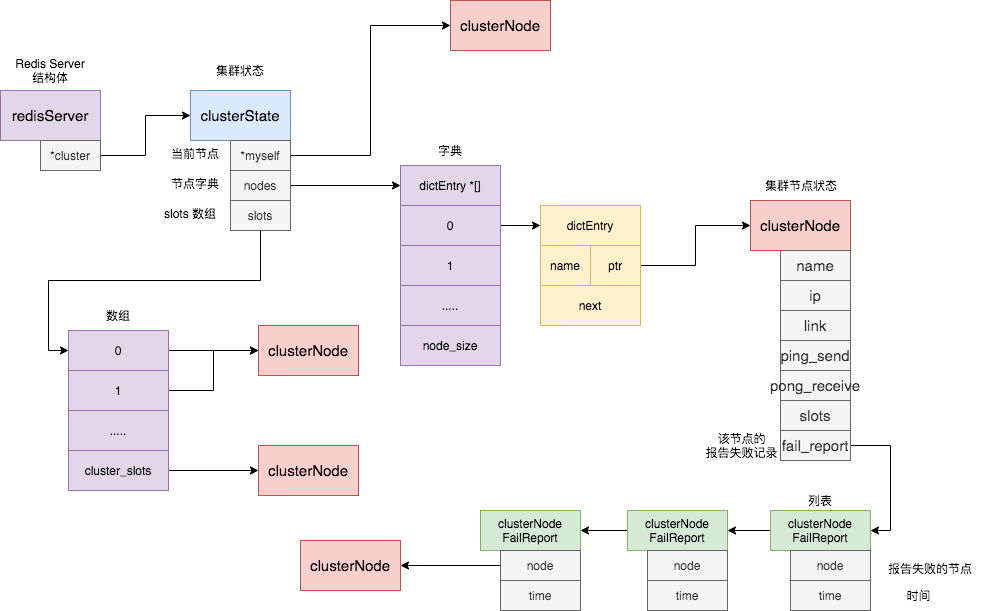
redis_cluster
clusterNode 结构保存了 一个节点的当前状态,比如节点的 创建时间、 节点的名字、 节点当前的配置纪元、 节点的IP地址和端口号等等。除此之外,clusterNode 结构的 link 属性是一个 clusterLink 结构,该结构保存了连接节点所需的有关信息,比如套接字描述符,输入缓冲区和输出缓冲区。clusterNode 还有一个 fail_report 的列表,用来记录疑似下线报告。具体定义如下所示。
clusterNodeFailReport 是记录节点下线报告的结构体, node 是报告节点的信息,而 time 则代表着报告时间。
3.2 消息结构体
了解了 Redis 节点维护的数据结构体后,我们再来看节点进行通信的消息结构体。通信消息最外侧的结构体为 clusterMsg,它包括了很多消息记录信息,包括 RCmb 标志位,消息总长度,消息协议版本,消息类型;它还包括了发送该消息节点的记录信息,比如节点名称,节点负责的 slot 信息,节点 ip 和端口等;最后它包含了一个 clusterMsgData 来携带具体类型的消息。
clusterMsgData 是一个 union 结构体,它可以为 PING、MEET、PONG 或者 FAIL 等消息体。其中当消息为 PING、MEET 和 PONG 类型时,ping 字段是被赋值的,而是 FAIL 类型时,fail 字段是被赋值的。
clusterMsgDataGossip 是 PING、PONG 和 MEET 消息的结构体,它会包括发送消息节点维护的其他节点信息,也就是上文中 clusterState 中 nodes 字段包含的信息,具体代码如下所示,你也会发现二者的字段是类似的。
typedefstruct{ charnodename[CLUSTER_NAMELEN]; /* 下线节点的名字 */} clusterMsgDataFail;
看完了节点维护的数据结构体和发送的消息结构体后,我们就来看看 Redis 的具体行为源码了。
3.3 随机周期性发送 PING 消息
Redis 的 clusterCron 函数会被定时调用,每被执行10次,就会准备向随机的一个节点发送 PING 消息。
它会先随机的选出 5 个节点,然后从中选择最久没有与之通信的节点,调用 clusterSendPing 函数发送类型为 CLUSTERMSG_TYPE_PING 的消息。
/* 随机 5 个节点,选出其中一个 */for(j = 0; j < 5; j++) { de = dictGetRandomKey(server.cluster->nodes);clusterNode * this= dictGetVal(de);
/* 不要 PING 连接断开的节点,也不要 PING 最近已经 PING 过的节点 */if( this->link == NULL || this->ping_sent != 0) continue; if( this->flags & (CLUSTER_NODE_MYSELF|CLUSTER_NODE_HANDSHAKE)) continue; /* 对比 pong_received 字段,选出更长时间未收到其 PONG 消息的节点(表示好久没有接受到该节点的PONG消息了) */if(min_pong_node == NULL || min_pong > this->pong_received) { min_pong_node = this; min_pong = this->pong_received; }}/* 向最久没有收到 PONG 回复的节点发送 PING 命令 */if(min_pong_node) { serverLog(LL_DEBUG, "Pinging node %.40s", min_pong_node->name); clusterSendPing(min_pong_node->link, CLUSTERMSG_TYPE_PING);}}
clusterSendPing 函数的具体行为我们后续再了解,因为该函数在其他环节也会经常用到。
3.4 节点加入集群
当节点执行 CLUSTER MEET 命令后,会在自身给新节点维护一个 clusterNode 结构体,该结构体的 link 也就是TCP连接字段是 null,表示是新节点尚未建立连接。
clusterCron 函数中也会处理这些未建立连接的新节点,调用 createClusterLink 创立连接,然后调用 clusterSendPing 函数来发送 MEET 消息。
3.5 防止节点假超时及状态过期
防止节点假超时和标记疑似下线标记也是在 clusterCron 函数中,具体如下所示。它会检查当前所有的 nodes 节点列表,如果发现某个节点与自己的最后一个 PONG 通信时间超过了预定的阈值的一半时,为了防止节点是假超时,会主动释放掉与之的 link 连接,然后会主动向它发送一个 PING 消息。
/* 如果等到 PONG 到达的时间超过了 node timeout 一半的连接 *//* 因为尽管节点依然正常,但连接可能已经出问题了 */if(node->link && /* is connected */now - node->link->ctime >server.cluster_node_timeout && /* 还未重连 */node->ping_sent && /* 已经发过ping消息 */node->pong_received < node->ping_sent && /* 还在等待pong消息 *//* 等待pong消息超过了 timeout/2 */now - node->ping_sent > server.cluster_node_timeout/ 2) {/* 释放连接,下次 clusterCron 会自动重连 */freeClusterLink(node->link);}
/* 如果目前没有在 PING 节点*//* 并且已经有 node timeout 一半的时间没有从节点那里收到 PONG 回复 *//* 那么向节点发送一个 PING ,确保节点的信息不会太旧,有可能一直没有随机中 */if(node->link && node->ping_sent == 0&& (now - node->pong_received) > server.cluster_node_timeout/ 2) {clusterSendPing(node->link, CLUSTERMSG_TYPE_PING);continue; }/* .... 处理failover和标记遗失下线 */}
3.6 处理 failover 和标记疑似下线
如果防止节点假超时处理后,节点依旧未收到目标节点的 PONG 消息,并且时间已经超过了 cluster_node_timeout,那么就将该节点标记为疑似下线状态。
/* 后续代码只在节点发送了 PING 命令的情况下执行*/if(node->ping_sent == 0) continue;
/* 计算等待 PONG 回复的时长 */delay = now - node->ping_sent;/* 等待 PONG 回复的时长超过了限制值,将目标节点标记为 PFAIL (疑似下线)*/if(delay > server.cluster_node_timeout) { /* 超时了,标记为疑似下线 */if(!(node->flags & (REDIS_NODE_PFAIL|REDIS_NODE_FAIL))) { redisLog(REDIS_DEBUG, "*** NODE %.40s possibly failing", node->name);// 打开疑似下线标记node->flags |= REDIS_NODE_PFAIL;update_state = 1; }}
3.7 实际发送 Gossip 消息
以下是前方多次调用过的 clusterSendPing 方法的源码,代码中有详细的注释,大家可以自行阅读。主要的操作就是将节点自身维护的 clusterState 转换为对应的消息结构体。
/* 计算要携带多少节点的信息,最少3个,最多 1/10 集群总节点数量*/wanted = floor(dictSize(server.cluster->nodes)/ 10); if(wanted < 3) wanted = 3; if(wanted > freshnodes) wanted = freshnodes;
/* .... 省略 totlen 的计算等*/
/* 如果发送的信息是 PING ,那么更新最后一次发送 PING 命令的时间戳 */if(link->node && type == CLUSTERMSG_TYPE_PING) link->node->ping_sent = mstime;/* 将当前节点的信息(比如名字、地址、端口号、负责处理的槽)记录到消息里面 */clusterBuildMessageHdr(hdr,type);
/* Populate the gossip fields */intmaxiterations = wanted* 3; /* 每个节点有 freshnodes 次发送 gossip 信息的机会每次向目标节点发送 2 个被选中节点的 gossip 信息(gossipcount 计数) */while(freshnodes > 0&& gossipcount < wanted && maxiterations--) { /* 从 nodes 字典中随机选出一个节点(被选中节点) */dictEntry *de = dictGetRandomKey(server.cluster->nodes);clusterNode * this= dictGetVal(de);
/* 以下节点不能作为被选中节点:* Myself:节点本身。* PFAIL状态的节点* 处于 HANDSHAKE 状态的节点。* 带有 NOADDR 标识的节点* 因为不处理任何 Slot 而被断开连接的节点 */if( this== myself) continue; if( this->flags & CLUSTER_NODE_PFAIL) continue; if( this->flags & (CLUSTER_NODE_HANDSHAKE|CLUSTER_NODE_NOADDR) || ( this->link == NULL&& this->numslots == 0)) {freshnodes--; /* Tecnically not correct, but saves CPU. */continue; }
// 检查被选中节点是否已经在 hdr->data.ping.gossip 数组里面// 如果是的话说明这个节点之前已经被选中了// 不要再选中它(否则就会出现重复)if(clusterNodeIsInGossipSection(hdr,gossipcount, this)) continue;
/* 这个被选中节点有效,计数器减一 */clusterSetGossipEntry(hdr,gossipcount, this); freshnodes--;gossipcount++;}
/* .... 如果有 PFAIL 节点,最后添加 */
/* 计算信息长度 */totlen = sizeof(clusterMsg)- sizeof( unionclusterMsgData); totlen += ( sizeof(clusterMsgDataGossip)*gossipcount); /* 将被选中节点的数量(gossip 信息中包含了多少个节点的信息)记录在 count 属性里面*/hdr->count = htons(gossipcount);/* 将信息的长度记录到信息里面 */hdr->totlen = htonl(totlen);/* 发送网络请求 */clusterSendMessage(link,buf,totlen);zfree(buf);}
voidclusterSetGossipEntry(clusterMsg *hdr, inti, clusterNode *n) { clusterMsgDataGossip *gossip;/* 指向 gossip 信息结构 */gossip = &(hdr->data.ping.gossip[i]);/* 将被选中节点的名字记录到 gossip 信息 */memcpy(gossip->nodename,n->name,CLUSTER_NAMELEN); /* 将被选中节点的 PING 命令发送时间戳记录到 gossip 信息 */gossip->ping_sent = htonl(n->ping_sent/ 1000); /* 将被选中节点的 PONG 命令回复的时间戳记录到 gossip 信息 */gossip->pong_received = htonl(n->pong_received/ 1000); /* 将被选中节点的 IP 记录到 gossip 信息 */memcpy(gossip->ip,n->ip, sizeof(n->ip)); /* 将被选中节点的端口号记录到 gossip 信息 */gossip->port = htons(n->port);gossip->cport = htons(n->cport);/* 将被选中节点的标识值记录到 gossip 信息 */gossip->flags = htons(n->flags);gossip->notused1 = 0; }
下面是 clusterBuildMessageHdr 函数,它主要负责填充消息结构体中的基础信息和当前节点的状态信息。
/* 如果当前节点是salve,则master为其主节点,如果当前节点是master节点,则master就是当前节点 */master = (nodeIsSlave(myself) && myself->slaveof) ?myself->slaveof : myself;
memset(hdr, 0,sizeof(*hdr)); /* 初始化协议版本、标识、及类型, */hdr->ver = htons(CLUSTER_PROTO_VER);hdr->sig[ 0] = 'R'; hdr->sig[ 1] = 'C'; hdr->sig[ 2] = 'm'; hdr->sig[ 3] = 'b'; hdr->type = htons(type);/* 消息头设置当前节点id */memcpy(hdr->sender,myself->name,CLUSTER_NAMELEN);
/* 消息头设置当前节点ip */memset(hdr->myip, 0,NET_IP_STR_LEN); if(server.cluster_announce_ip) { strncpy(hdr->myip,server.cluster_announce_ip,NET_IP_STR_LEN);hdr->myip[NET_IP_STR_LEN -1] = '0'; }
/* 基础端口及集群内节点通信端口 */int announced_port = server.cluster_announce_port ?server.cluster_announce_port : server.port;int announced_cport = server.cluster_announce_bus_port ?server.cluster_announce_bus_port :(server.port + CLUSTER_PORT_INCR);/* 设置当前节点的槽信息 */memcpy(hdr->myslots,master->slots,sizeof(hdr->myslots));memset(hdr->slaveof, 0,CLUSTER_NAMELEN); if(myself->slaveof != NULL) memcpy(hdr->slaveof,myself->slaveof->name, CLUSTER_NAMELEN);hdr->port = htons(announced_port);hdr->cport = htons(announced_cport);hdr->flags = htons(myself->flags);hdr->state = server.cluster->state;
/* 设置 currentEpoch and configEpochs. */hdr->currentEpoch = htonu64(server.cluster->currentEpoch);hdr->configEpoch = htonu64(master->configEpoch);
/* 设置复制偏移量 */if(nodeIsSlave(myself)) offset = replicationGetSlaveOffset;elseoffset = server.master_repl_offset;hdr->offset = htonu64(offset);
/* Set the message flags. */if(nodeIsMaster(myself) && server.cluster->mf_end) hdr->mflags[ 0] |= CLUSTERMSG_FLAG0_PAUSED;
/* 计算并设置消息的总长度 */if(type == CLUSTERMSG_TYPE_FAIL) { totlen = sizeof(clusterMsg)-sizeof(union clusterMsgData);totlen += sizeof(clusterMsgDataFail);} elseif(type == CLUSTERMSG_TYPE_UPDATE) { totlen = sizeof(clusterMsg)-sizeof(union clusterMsgData);totlen += sizeof(clusterMsgDataUpdate);}hdr->totlen = htonl(totlen);}
4. 后记
本来只想写一下 Redis Cluster 的 Gossip 协议,没想到文章越写,内容越多,最后源码分析也是有点虎头蛇尾,大家就凑合看一下,也希望大家继续关注我后续的问题。返回搜狐,查看更多