版权声明
来源:腾讯科技(qqtech),书享界(readsharecn)
作者:黄仁勋,NVIDIA公司联合创始人兼首席执行官
导语
6月2日,英伟达公司联合创始人兼首席执行官黄仁勋在Computex 2024(2024台北国际电脑展)上发表主题演讲,分享了人工智能时代如何助推全球新产业革命。在两小时的演讲中,黄仁勋详细阐述了自己对“GPU加速AI计算革命”及“AI工厂”的理解,也特别提到了人工智能与机器人的结合,认为机器人技术的应用远不止于人形机器人,“机械化将成为常态,工厂将全面实现自动化,机器人将协同工作,制造出一系列机械化产品。”。以下是腾讯科技整理的两小时演讲全文实录:
观点提要
①黄仁勋展示了最新量产版Blackwell芯片,并称将在2025年推出Blackwell Ultra AI芯片,下一代AI平台命名为Rubin,2027年推Rubin Ultra,更新节奏将是“一年一次”,打破“摩尔定律”。
②黄仁勋宣称英伟达推动了大语言模型诞生,其在2012年后改变了GPU架构,并将所有新技术集成在单台计算机上。
③英伟达的加速计算技术帮助实现了100倍速率提升,而功耗仅增加到原来的3倍,成本为原来的1.5倍。
④黄仁勋预计下一代AI需要理解物理世界。他给出的方法是让AI通过视频与合成数据学习,并让AI互相学习。
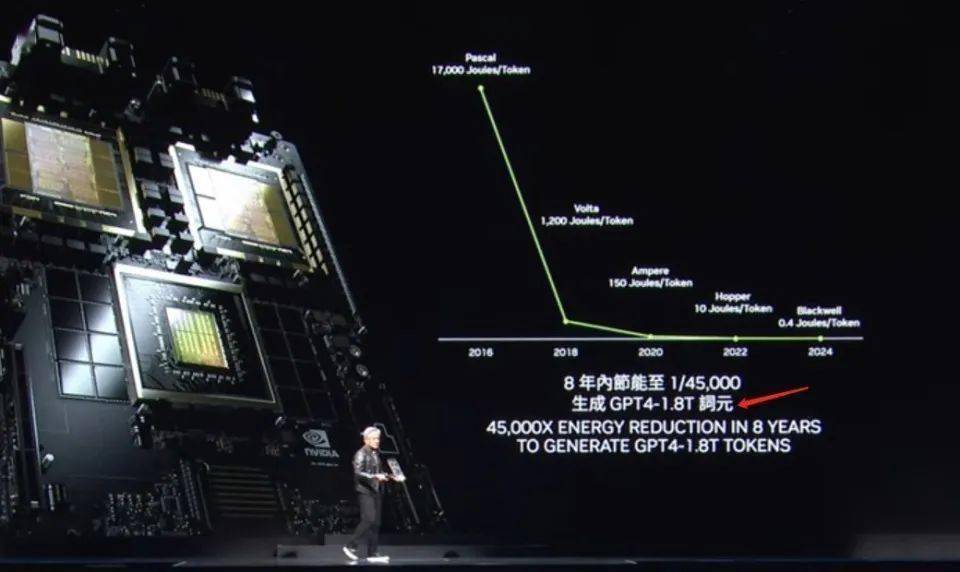
⑤黄仁勋在PPT里甚至给token敲定了一个中文译名——词元。
⑥黄仁勋表示,机器人时代已经到来,将来所有移动的物体都将实现自主运行。
尊敬的各位来宾,我非常荣幸能再次站在这里。首先,我要感谢台湾大学为我们提供这个体育馆作为举办活动的场所。上一次我来到这里,是我从台湾大学获得学位的时候。今天,我们即将探讨的内容很多,所以我必须加快步伐,以快速而清晰的方式传达信息。我们有很多话题要聊,我有许多激动人心的故事要与大家分享。
我很高兴能够来到中国台湾,这里有我们很多合作伙伴。事实上,这里不仅是英伟达发展历程中不可或缺的一部分,更是我们与合作伙伴共同将创新推向全球的关键节点。我们与许多合作伙伴共同构建了全球范围内的人工智能基础设施。今天,我想与大家探讨几个关键议题:
1)我们共同的工作正在取得哪些进展,以及这些进展的意义何在?
2)生成式人工智能到底是什么?它将如何影响我们的行业,乃至每一个行业?
3)一个关于我们如何前进的蓝图,我们将如何抓住这个令人难以置信的机遇?
接下来会发生什么?生成式人工智能及其带来的深远影响,我们的战略蓝图,这些都是我们即将探讨的令人振奋的主题。我们正站在计算机行业重启的起点上,一个由你们铸就、由你们创造的新时代即将开启。现在,你们已经为下一段重要旅程做好了准备。
1
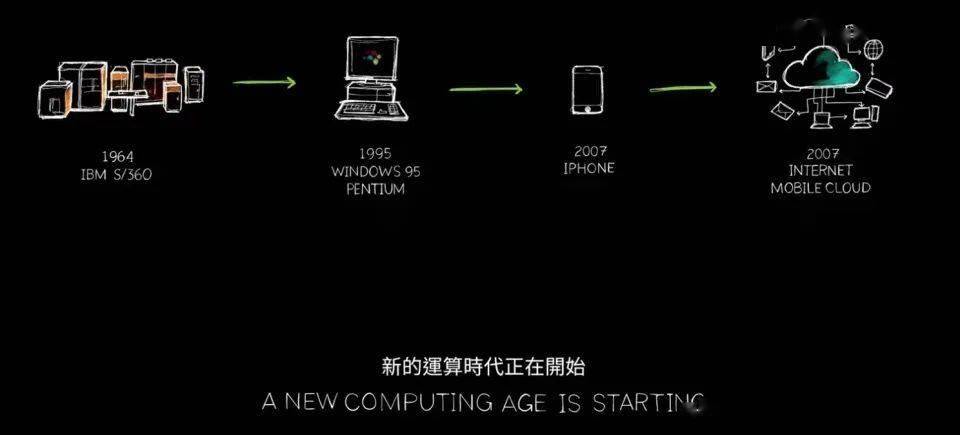
新的计算时代正在开始
但在开始深入讨论之前,我想先强调一点:英伟达位于计算机图形学、模拟和人工智能的交汇点上,这构成了我们公司的灵魂。今天,我将向大家展示的所有内容,都是基于模拟的。这些不仅仅是视觉效果,它们背后是数学、科学和计算机科学的精髓,以及令人叹为观止的计算机架构。没有任何动画是预先制作的,一切都是我们自家团队的杰作。这就是英伟达的领会,我们将其全部融入了我们引以为傲的Omniverse虚拟世界中。现在,请欣赏视频!
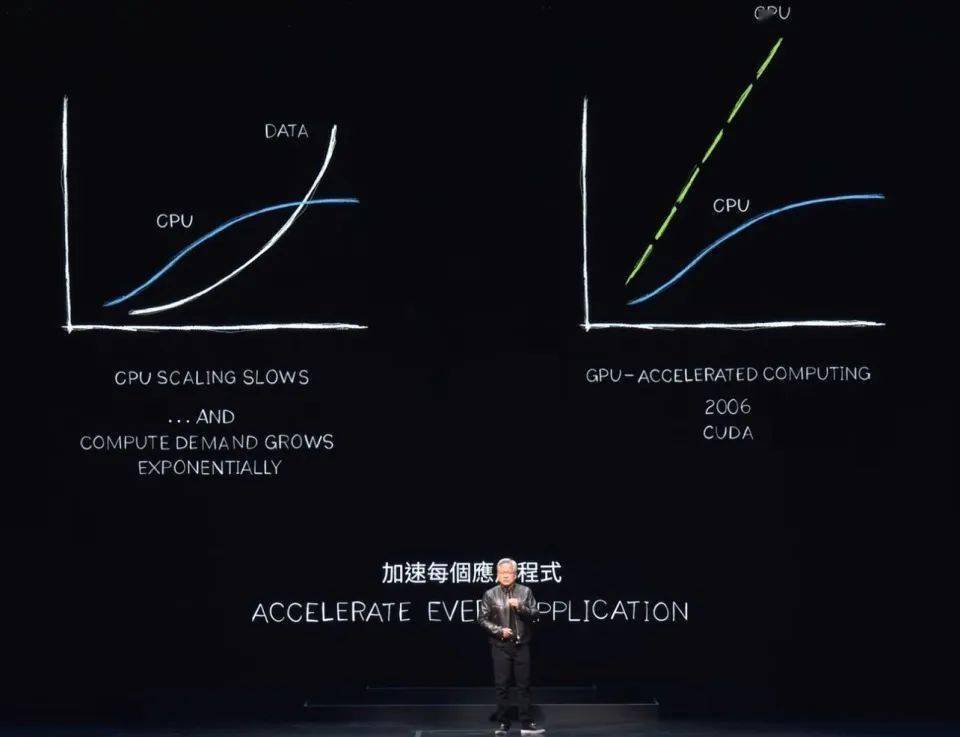
全球数据中心的电力消耗正在急剧上升,同时计算成本也在不断攀升。我们正面临着计算膨胀的严峻挑战,这种情况显然无法长期维持。数据将继续以指数级增长,而CPU的性能扩展却难以像以往那样快速。然而,有一种更为高效的方法正在浮现。
近二十年来,我们一直致力于加速计算的研究。CUDA技术增强了CPU的功能,将那些特殊处理器能更高效完成的任务卸载并加速。事实上,由于CPU性能扩展的放缓甚至停滞,加速计算的优势愈发显著。我预测,每个处理密集型的应用都将实现加速,且不久的将来,每个数据中心都将实现全面加速。
现在,选择加速计算是明智之举,这已成为行业共识。想象一下,一个应用程序需要100个时间单位来完成。无论是100秒还是100小时,我们往往无法承受运行数天甚至数月的人工智能应用。
在这100个时间单位中,有1个时间单位涉及需要顺序执行的代码,此时单线程CPU的重要性不言而喻。操作系统的控制逻辑是不可或缺的,必须严格按照指令序列执行。然而,还有许多算法,如计算机图形学、图像处理、物理模拟、组合优化、图处理和数据库处理,特别是深度学习中广泛使用的线性代数,它们非常适合通过并行处理进行加速。为了实现这一目标,我们发明了一种创新架构,将GPU与CPU完美结合。
专用的处理器能够将原本耗时的任务加速至令人难以置信的速度。由于这两个处理器能并行工作,它们各自独立且自主运行。这意味着,原本需要100个时间单位才能完成的任务,现在可能仅需1个时间单位即可完成。尽管这种加速效果听起来令人难以置信,但今天,我将通过一系列实例来验证这一说法。
这种性能提升所带来的好处是惊人的,加速100倍,而功率仅增加约3倍,成本仅上升约50%。我们在PC行业早已实践了这种策略。在PC上添加一个价值500美元的GeForce GPU,就能使其性能大幅提升,同时整体价值也增加至1000美元。在数据中心,我们也采用了同样的方法。一个价值十亿美元的数据中心,在添加了价值5亿美元的GPU后,瞬间转变为一个强大的人工智能工厂。今天,这种变革正在全球范围内发生。
节省的成本同样令人震惊。每投入1美元,你就能获得高达60倍的性能提升。加速100倍,而功率仅增加3倍,成本仅上升1.5倍。节省的费用是实实在在的!
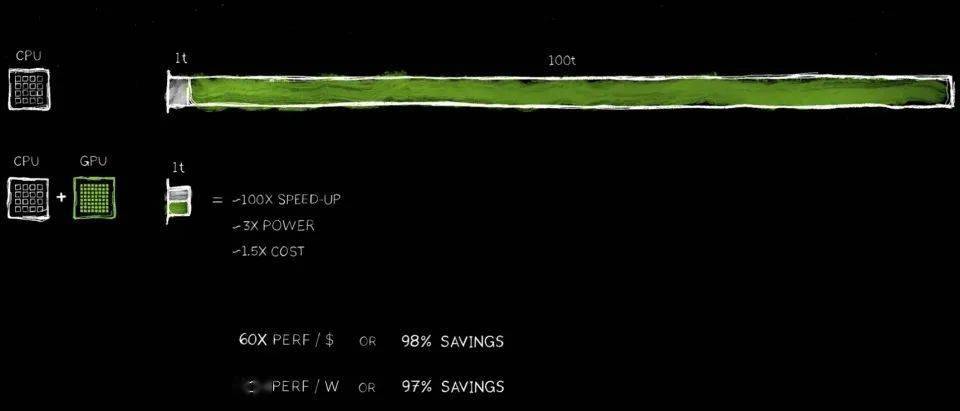
显然,许多公司在云端处理数据上花费了数亿美元。当数据得到加速处理时,节省数亿美元就变得合情合理。为什么会这样呢?原因很简单,我们在通用计算方面经历了长时间的效率瓶颈。
现在,我们终于认识到了这一点,并决定加速。通过采用专用处理器,我们可以重新获得大量之前被忽视的性能提升,从而节省大量金钱和能源。这就是为什么我说,你购买得越多,节省得也越多。
现在,我已经向你们展示了这些数字。虽然它们并非精确到小数点后几位,但这准确地反映了事实。这可以称之为“CEO数学”。CEO数学虽不追求极致的精确,但其背后的逻辑是正确的——你购买的加速计算能力越多,节省的成本也就越多。
2
350个函式库帮助开拓新市场
加速计算带来的结果确实非凡,但其实现过程并不容易。为什么它能节省这么多钱,但人们却没有更早地采用这种技术呢?原因就在于它的实施难度太大。
没有现成的软件可以简单地通过加速编译器运行,然后应用程序就能瞬间提速100倍。这既不符合逻辑也不现实。如果这么容易,那么CPU厂商早就这样做了。
事实上,要实现加速,软件必须进行全面重写。这是整个过程中最具挑战性的部分。软件需要被重新设计、重新编码,以便将原本在CPU上运行的算法转化为可以在加速器上并行运行的格式。
这项计算机科学研究虽然困难,但我们在过去的20年里已经取得了显著的进展。例如,我们推出了广受欢迎的cuDNN深度学习库,它专门处理神经网络加速。我们还为人工智能物理模拟提供了一个库,适用于流体动力学等需要遵守物理定律的应用。另外,我们还有一个名为Aerial的新库,它利用CUDA加速5G无线电技术,使我们能够像软件定义互联网网络一样,用软件定义和加速电信网络。
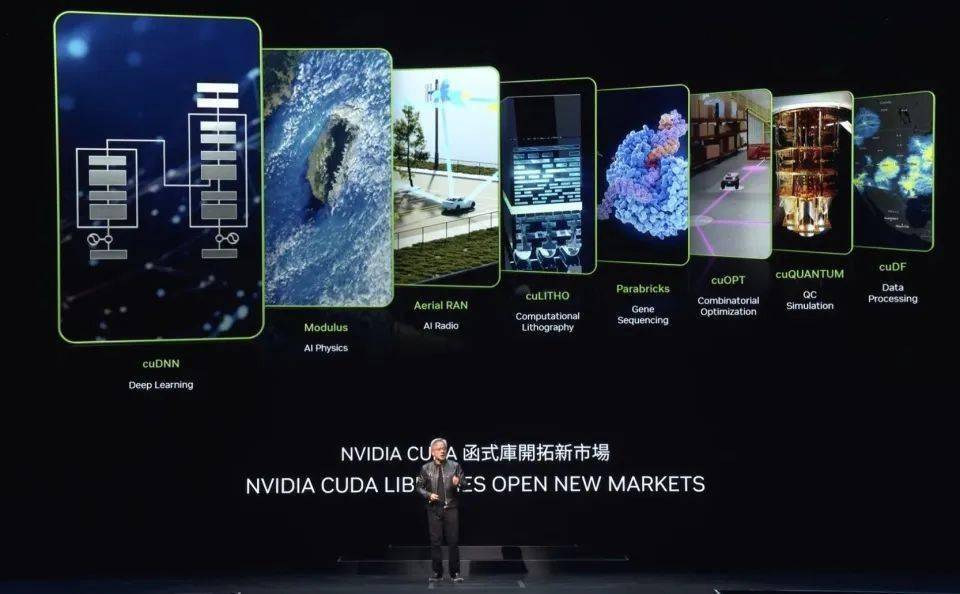
这些加速能力不仅提升了性能,还帮助我们将整个电信行业转化为一种与云计算类似的计算平台。此外,Coolitho计算光刻平台也是一个很好的例子,它极大地提升了芯片制造过程中计算最密集的部分——掩模制作的效率。台积电等公司已经开始使用Coolitho进行生产,不仅显著节省了能源,而且大幅降低了成本。他们的目标是通过加速技术栈,为算法的更进一步发展和制造更深更窄的晶体管所需的庞大计算能力做好准备。
Pair of Bricks是我们引以为傲的基因测序库,它拥有世界领先的基因测序吞吐量。而Co OPT则是一个令人瞩目的组合优化库,能够解决路线规划、优化行程、旅行社问题等复杂难题。人们普遍认为,这些问题需要量子计算机才能解决,但我们却通过加速计算技术,创造了一个运行极快的算法,成功打破了23项世界纪录,至今我们仍保持着每一个主要的世界纪录。返回搜狐,查看更多