今天分享的是大模型专题系列深度研究报告:《大模型专题:从技术路径,纵观国产大模型逆袭之路》
出品方:德邦证券
报告共计:45页
海量/完整电子版/报告下载方式:公众号《人工智能学派》
本文全面分析了国产大模型的发展现状和未来前景,特别是对国内大模型厂商的策略和技术进步进行了详细探讨。文章指出,尽管国内大模型在整体上与海外龙头大模型还存在一定差距,但在长文本处理等方面已经展现出明显的竞争优势,并且通过降价和迭代提升了自身的竞争力。然而,国产大模型也面临一系列挑战,包括如何进一步提高技术性能和稳定性,以及如何扩大在全球市场的份额,这些都将是未来发展的关键所在。
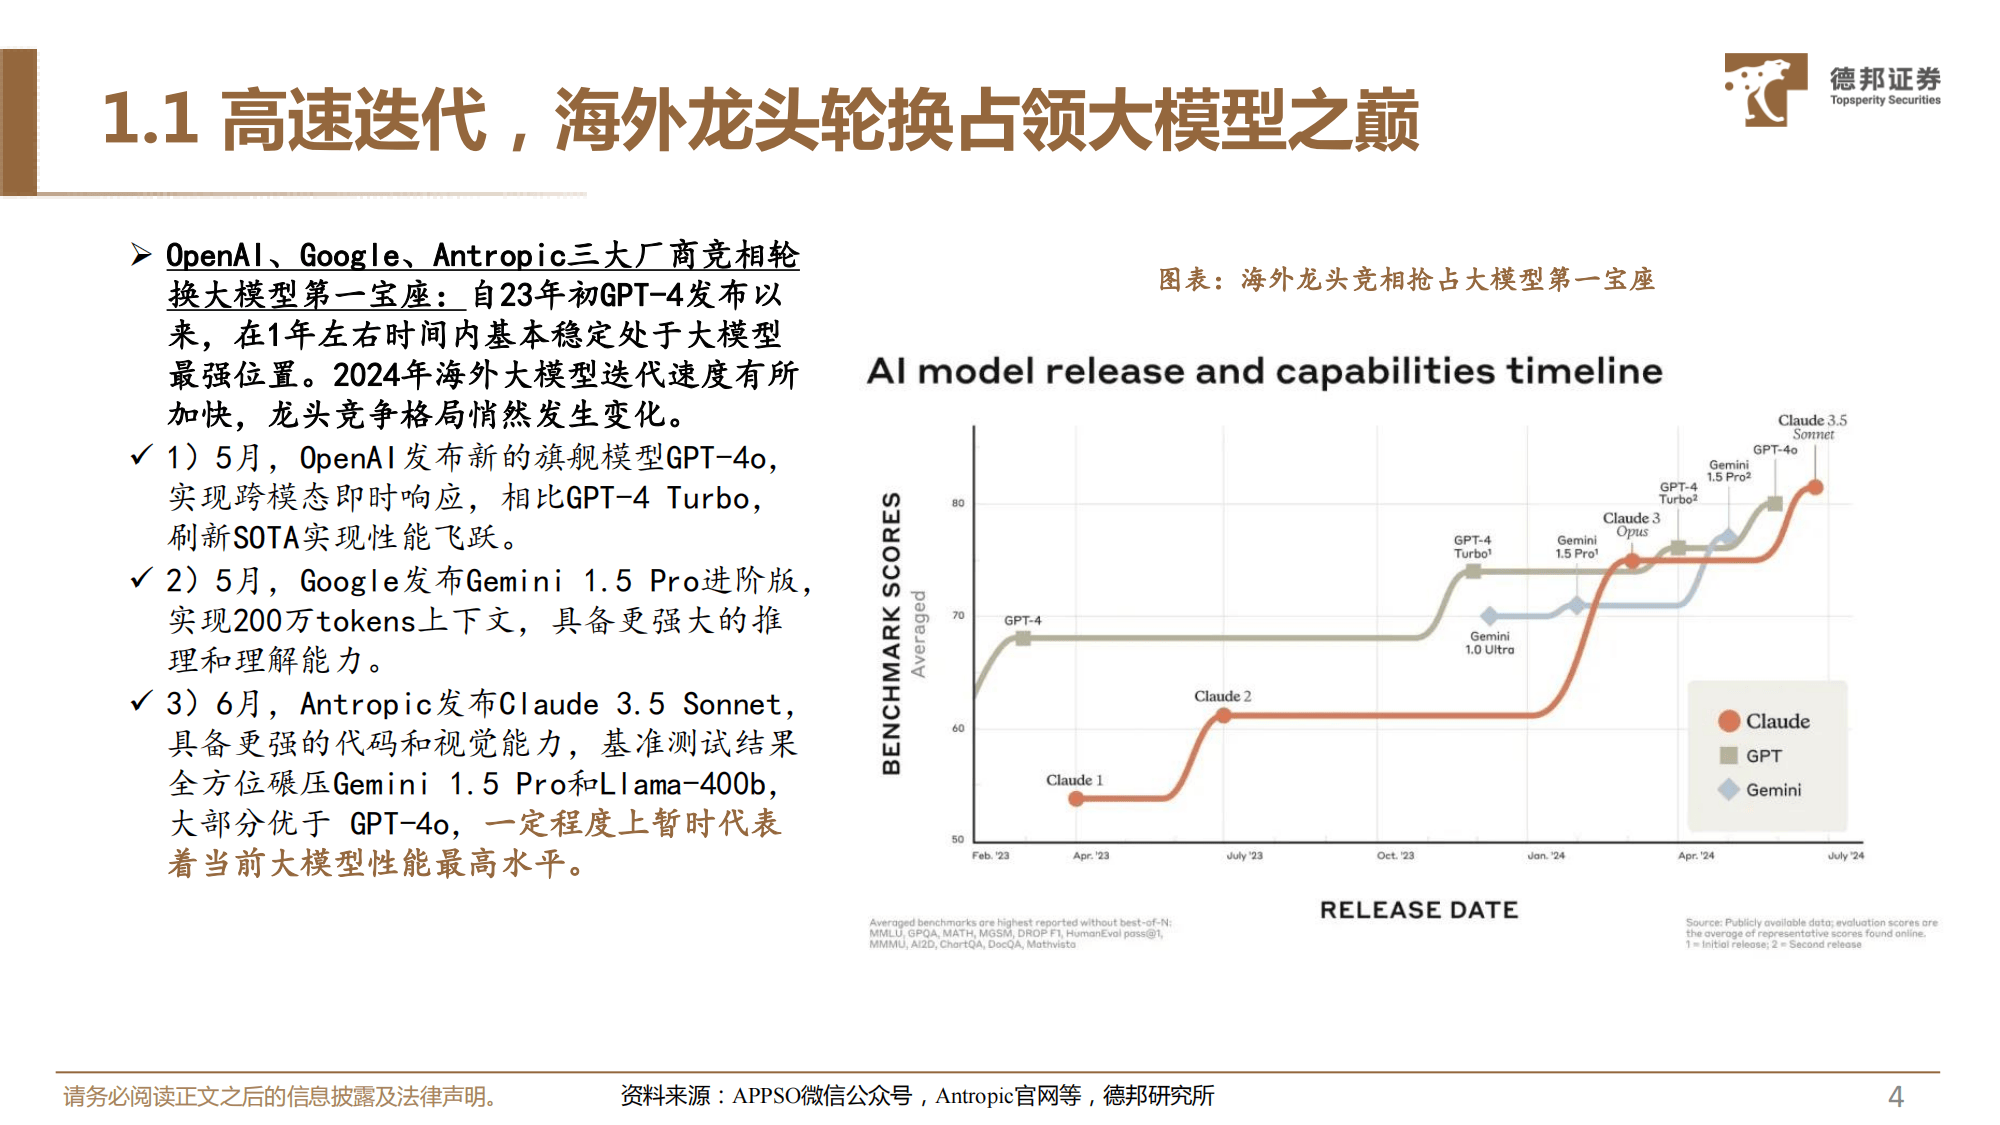
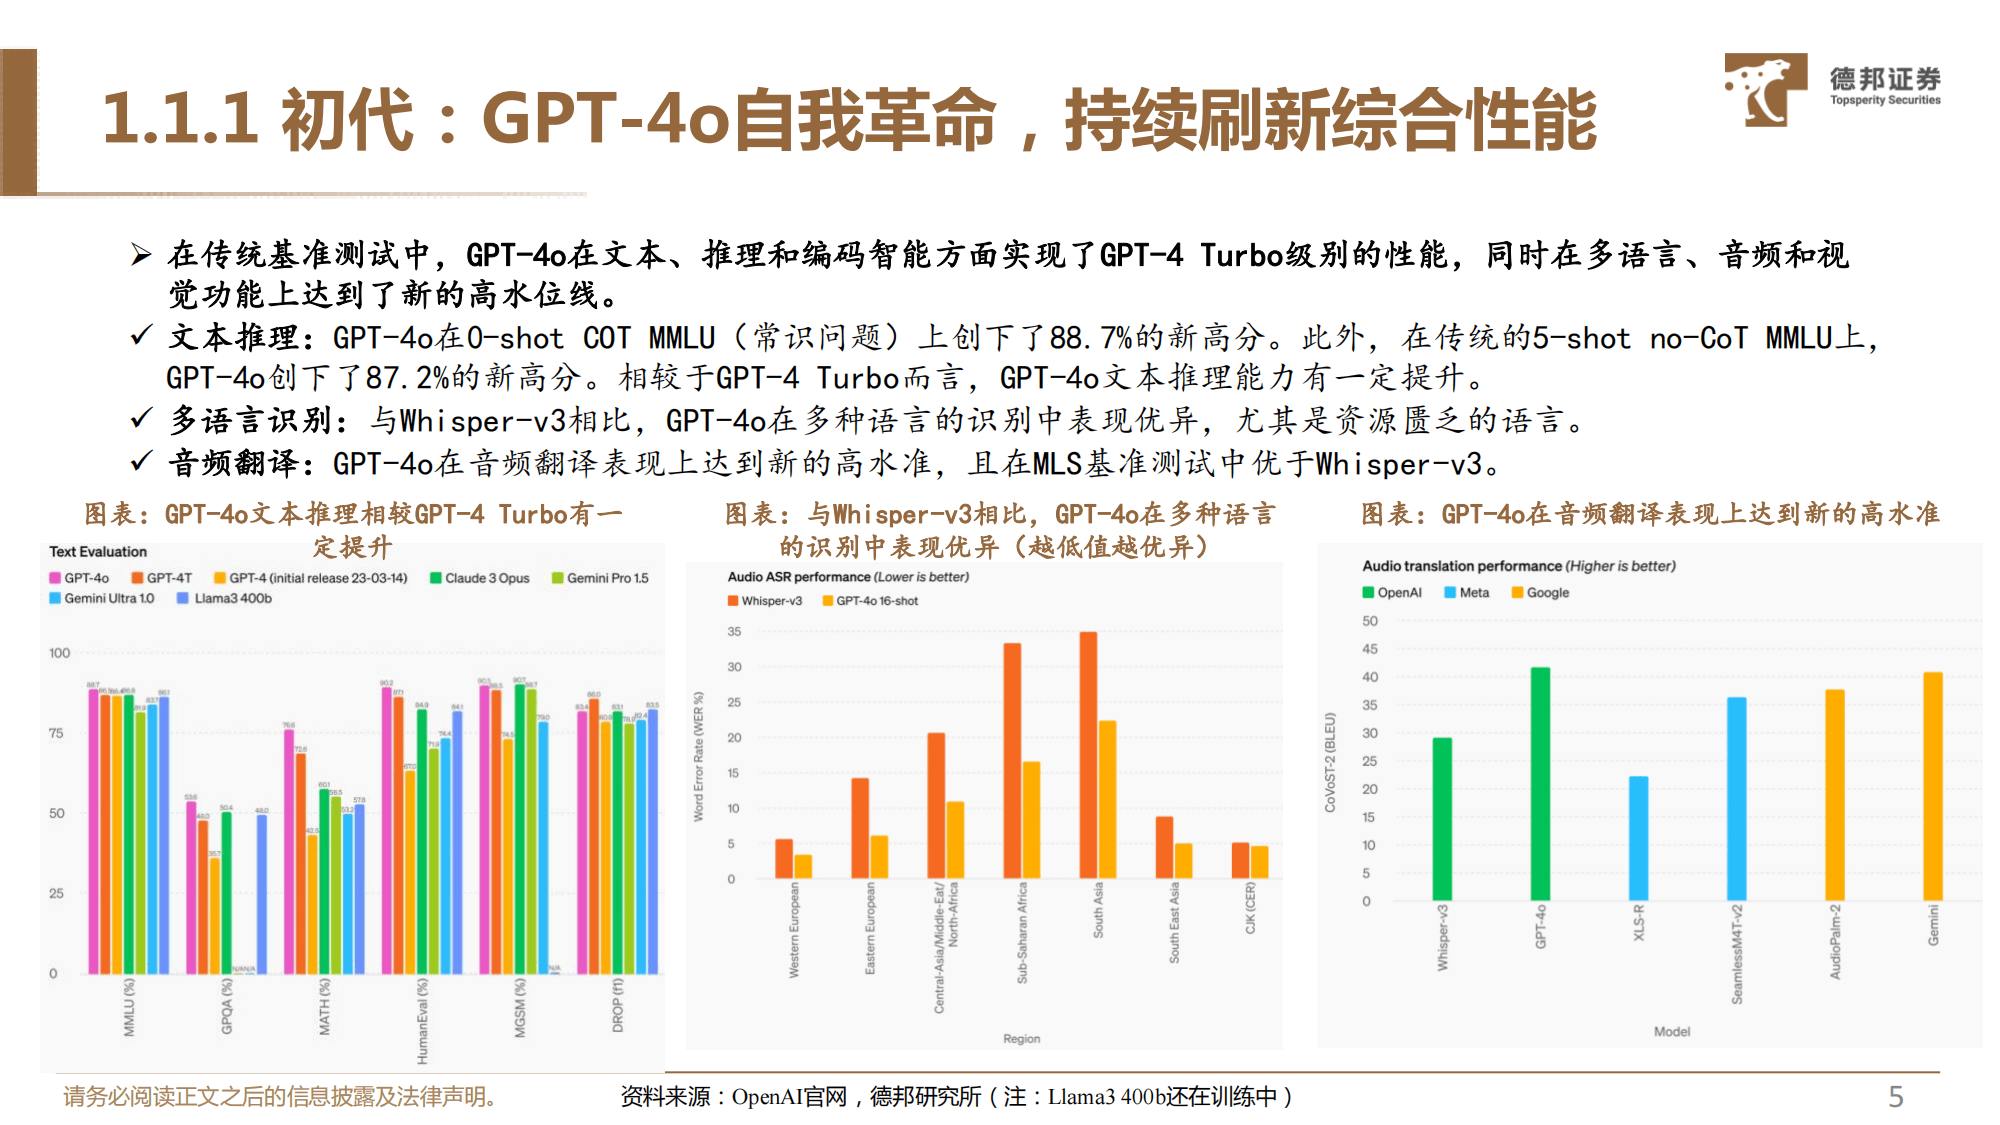
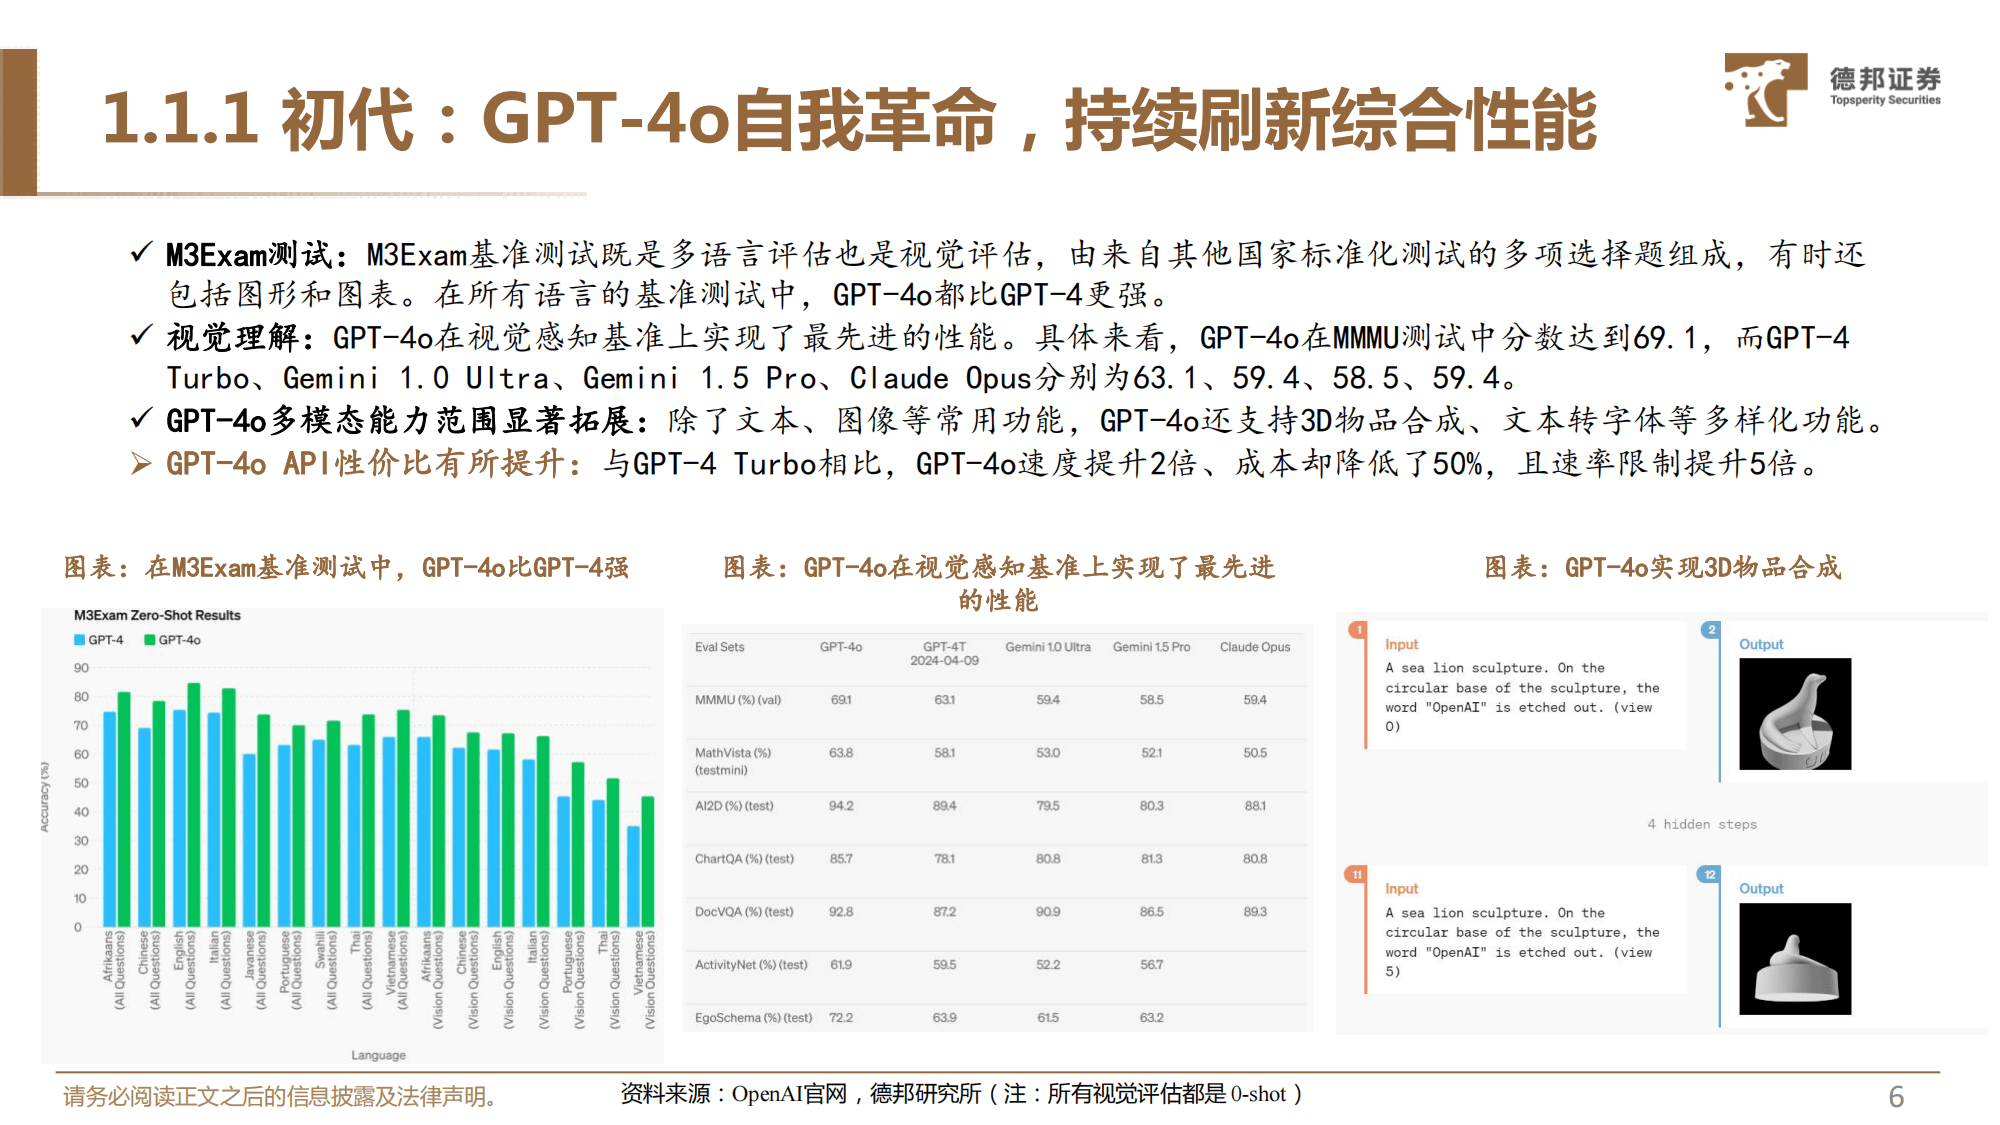
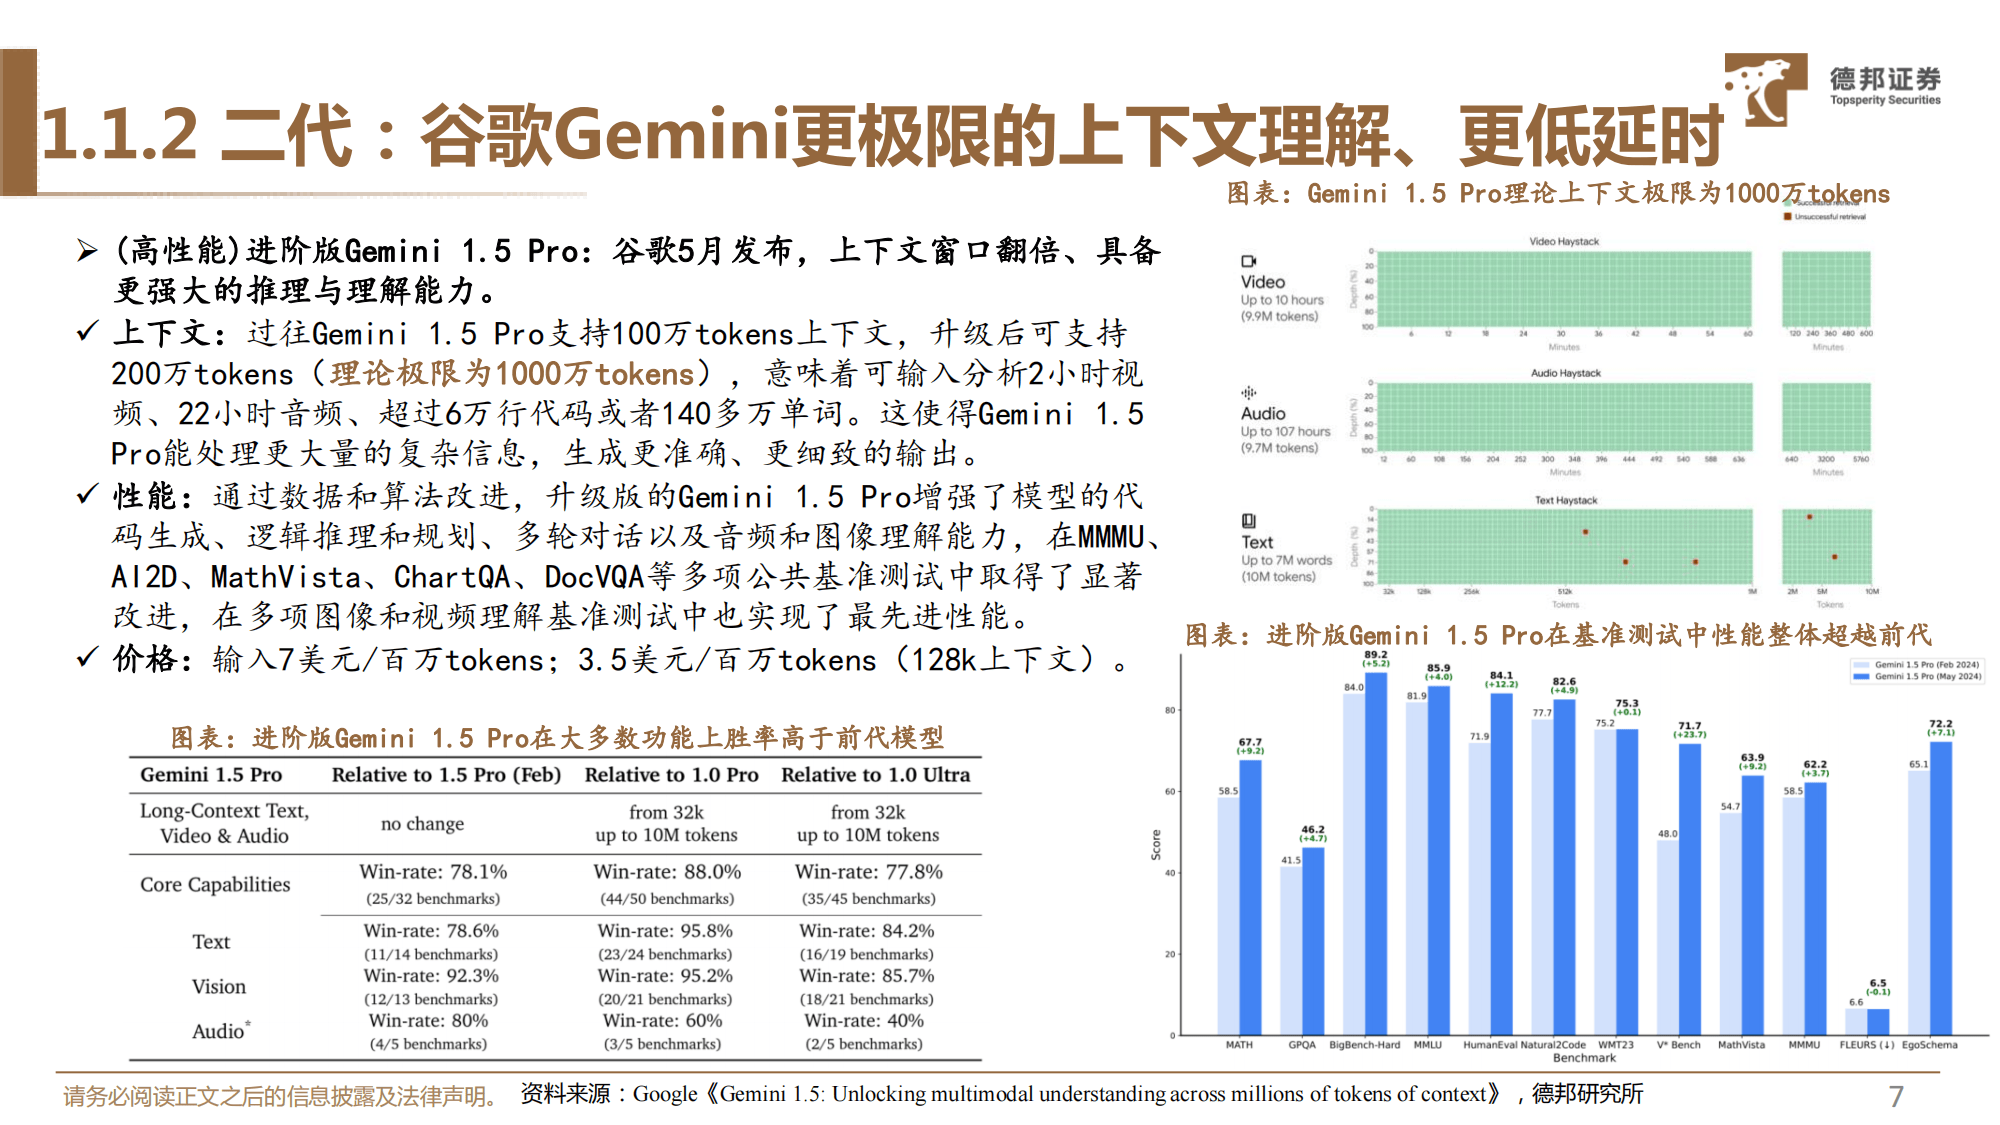
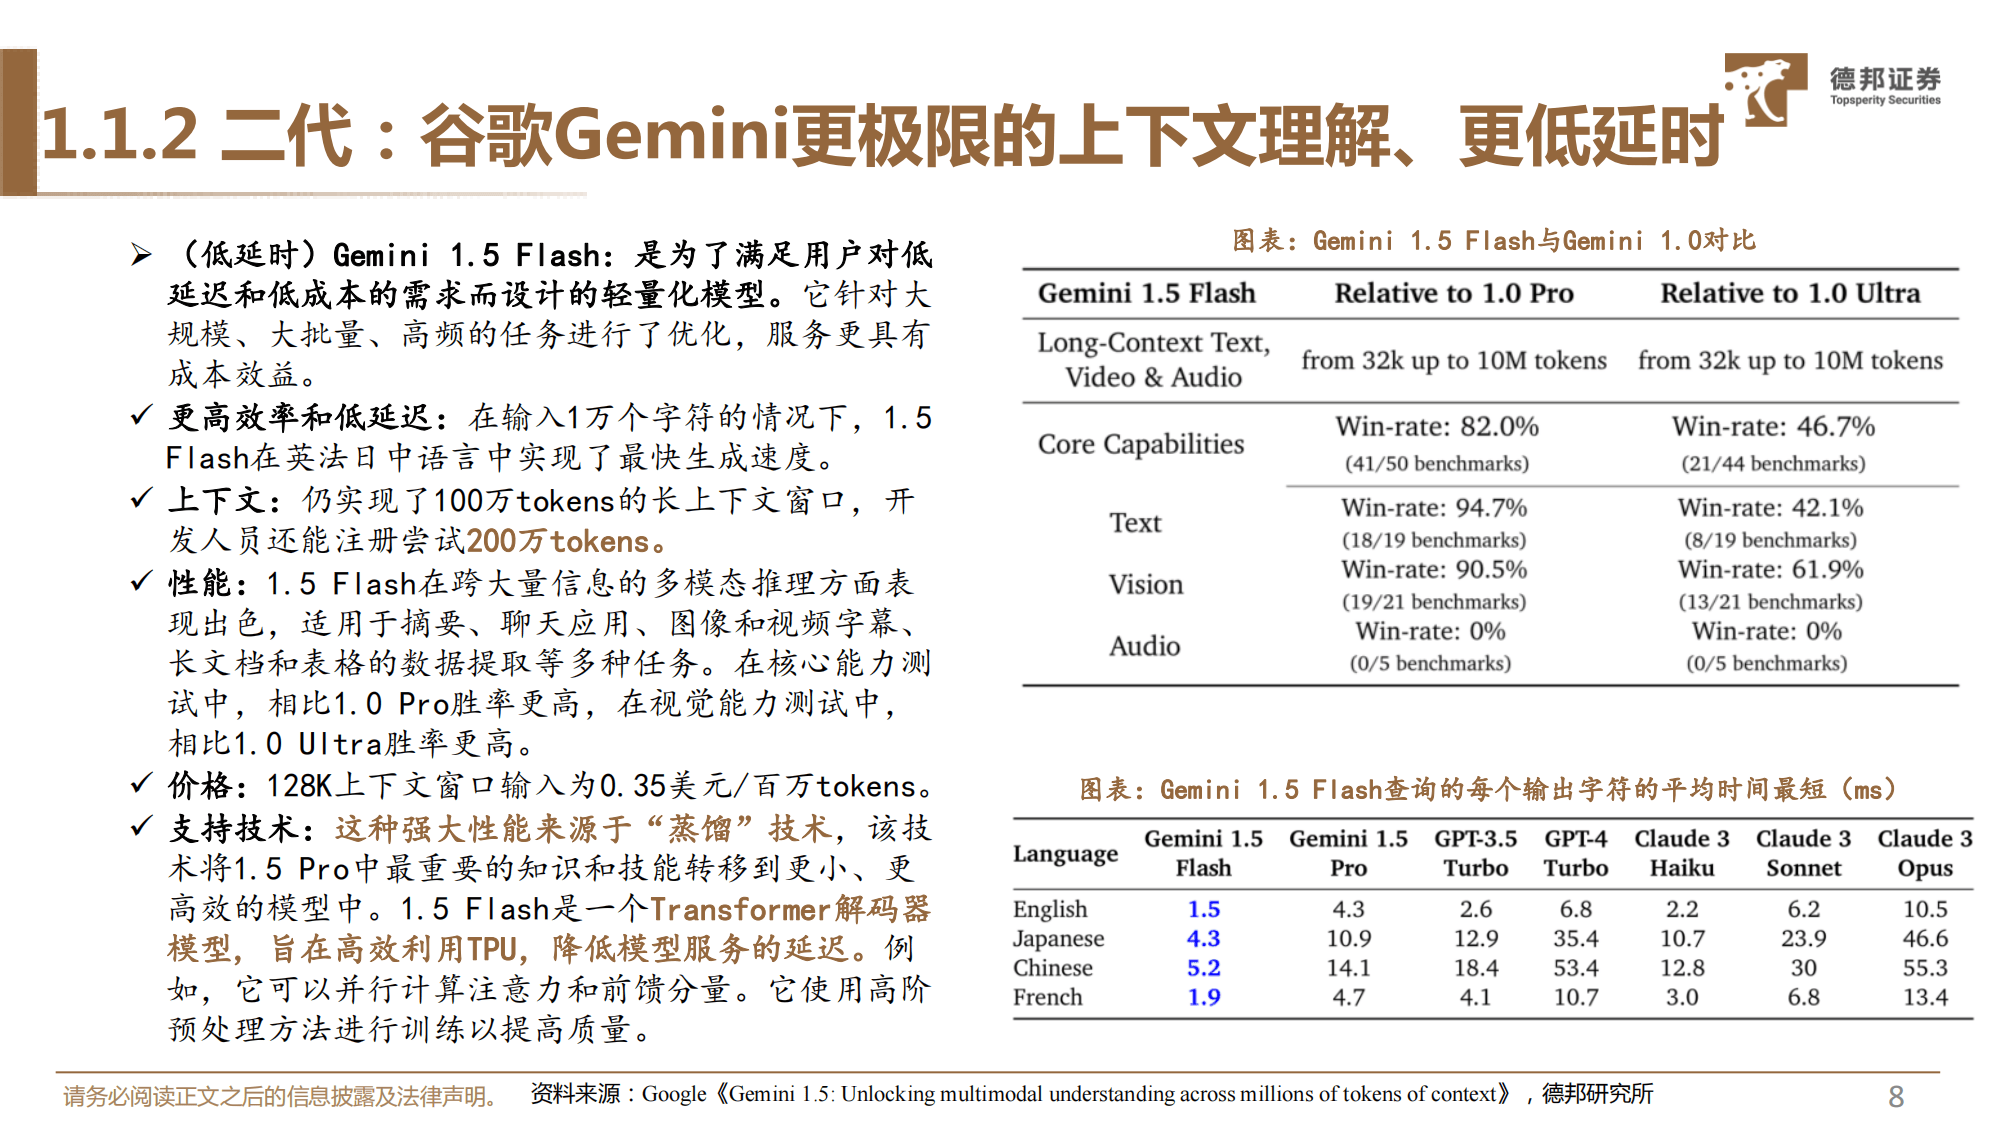
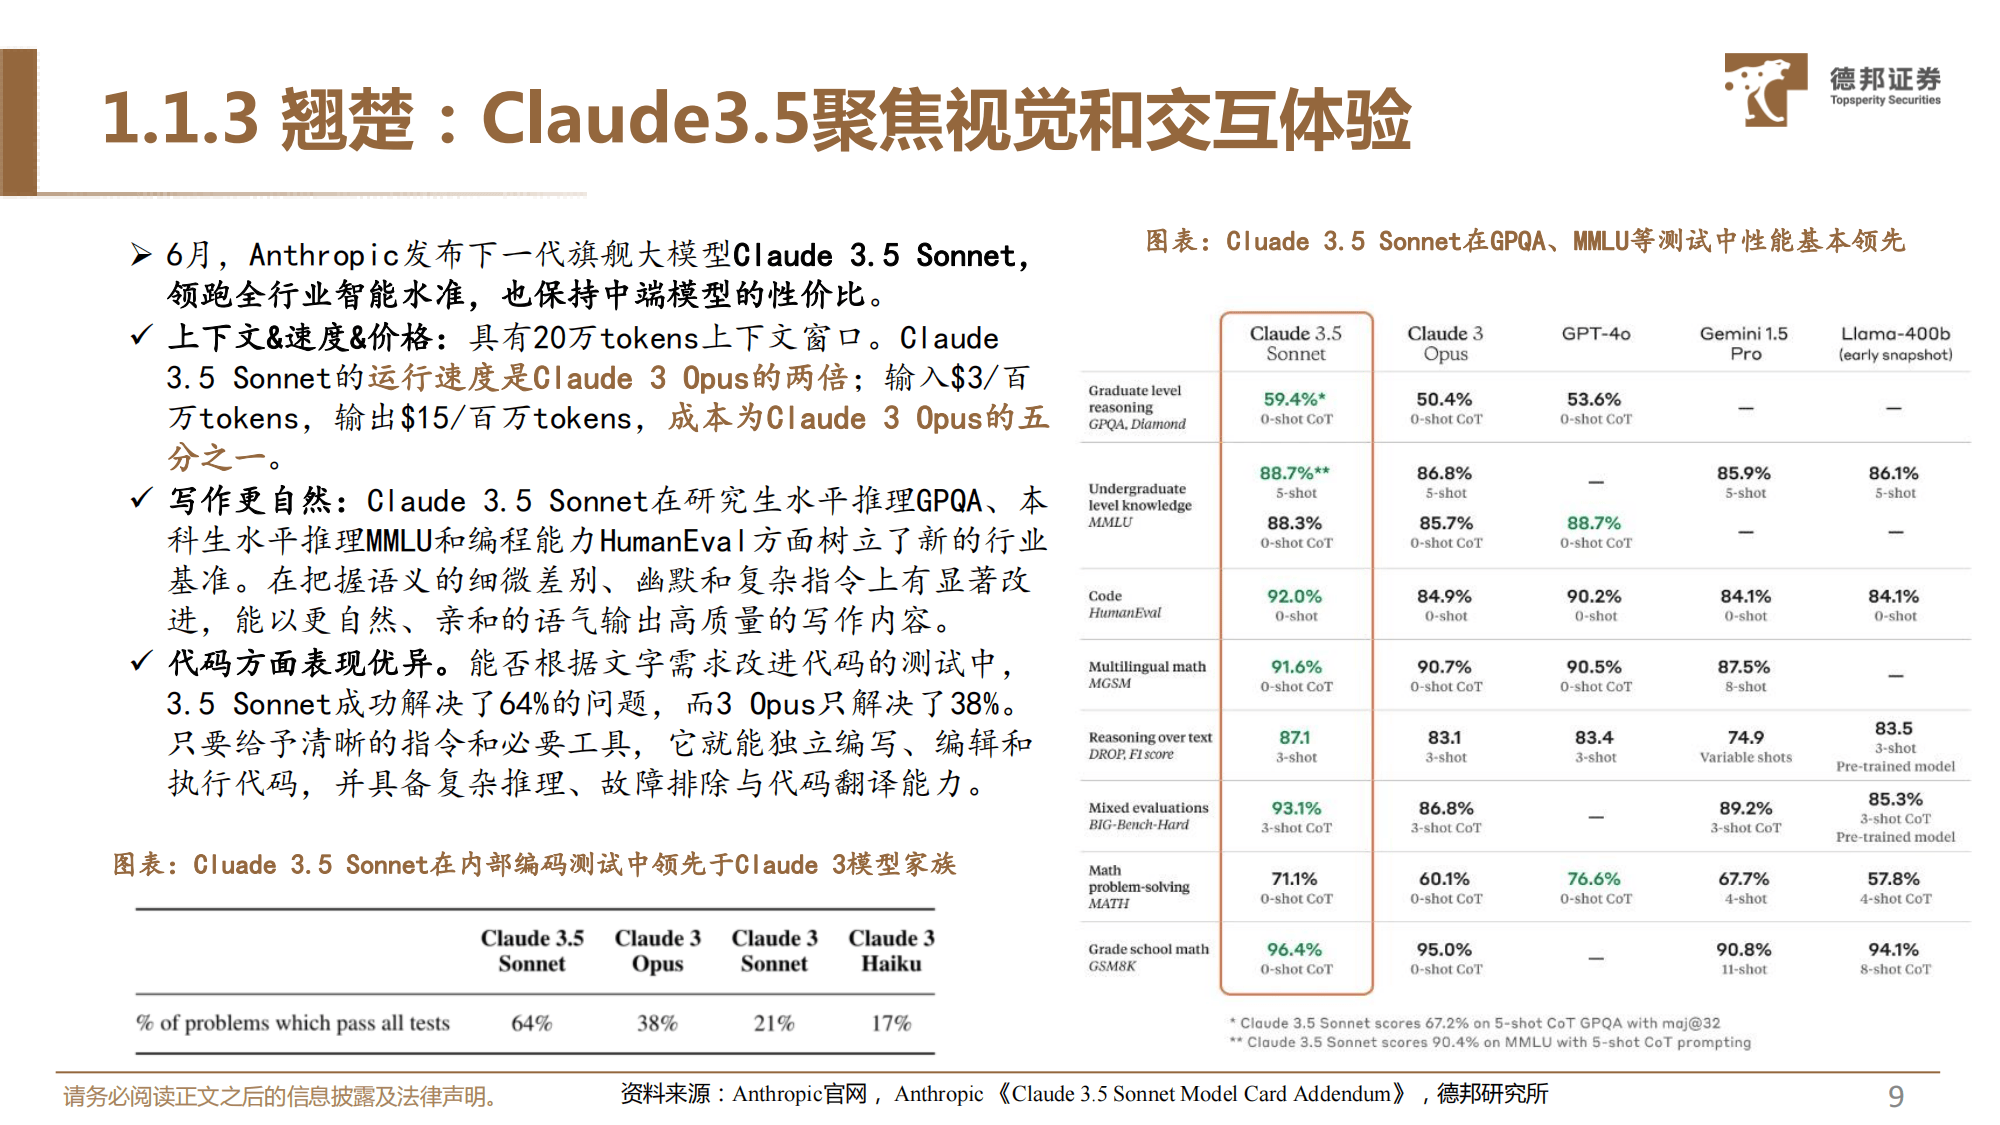
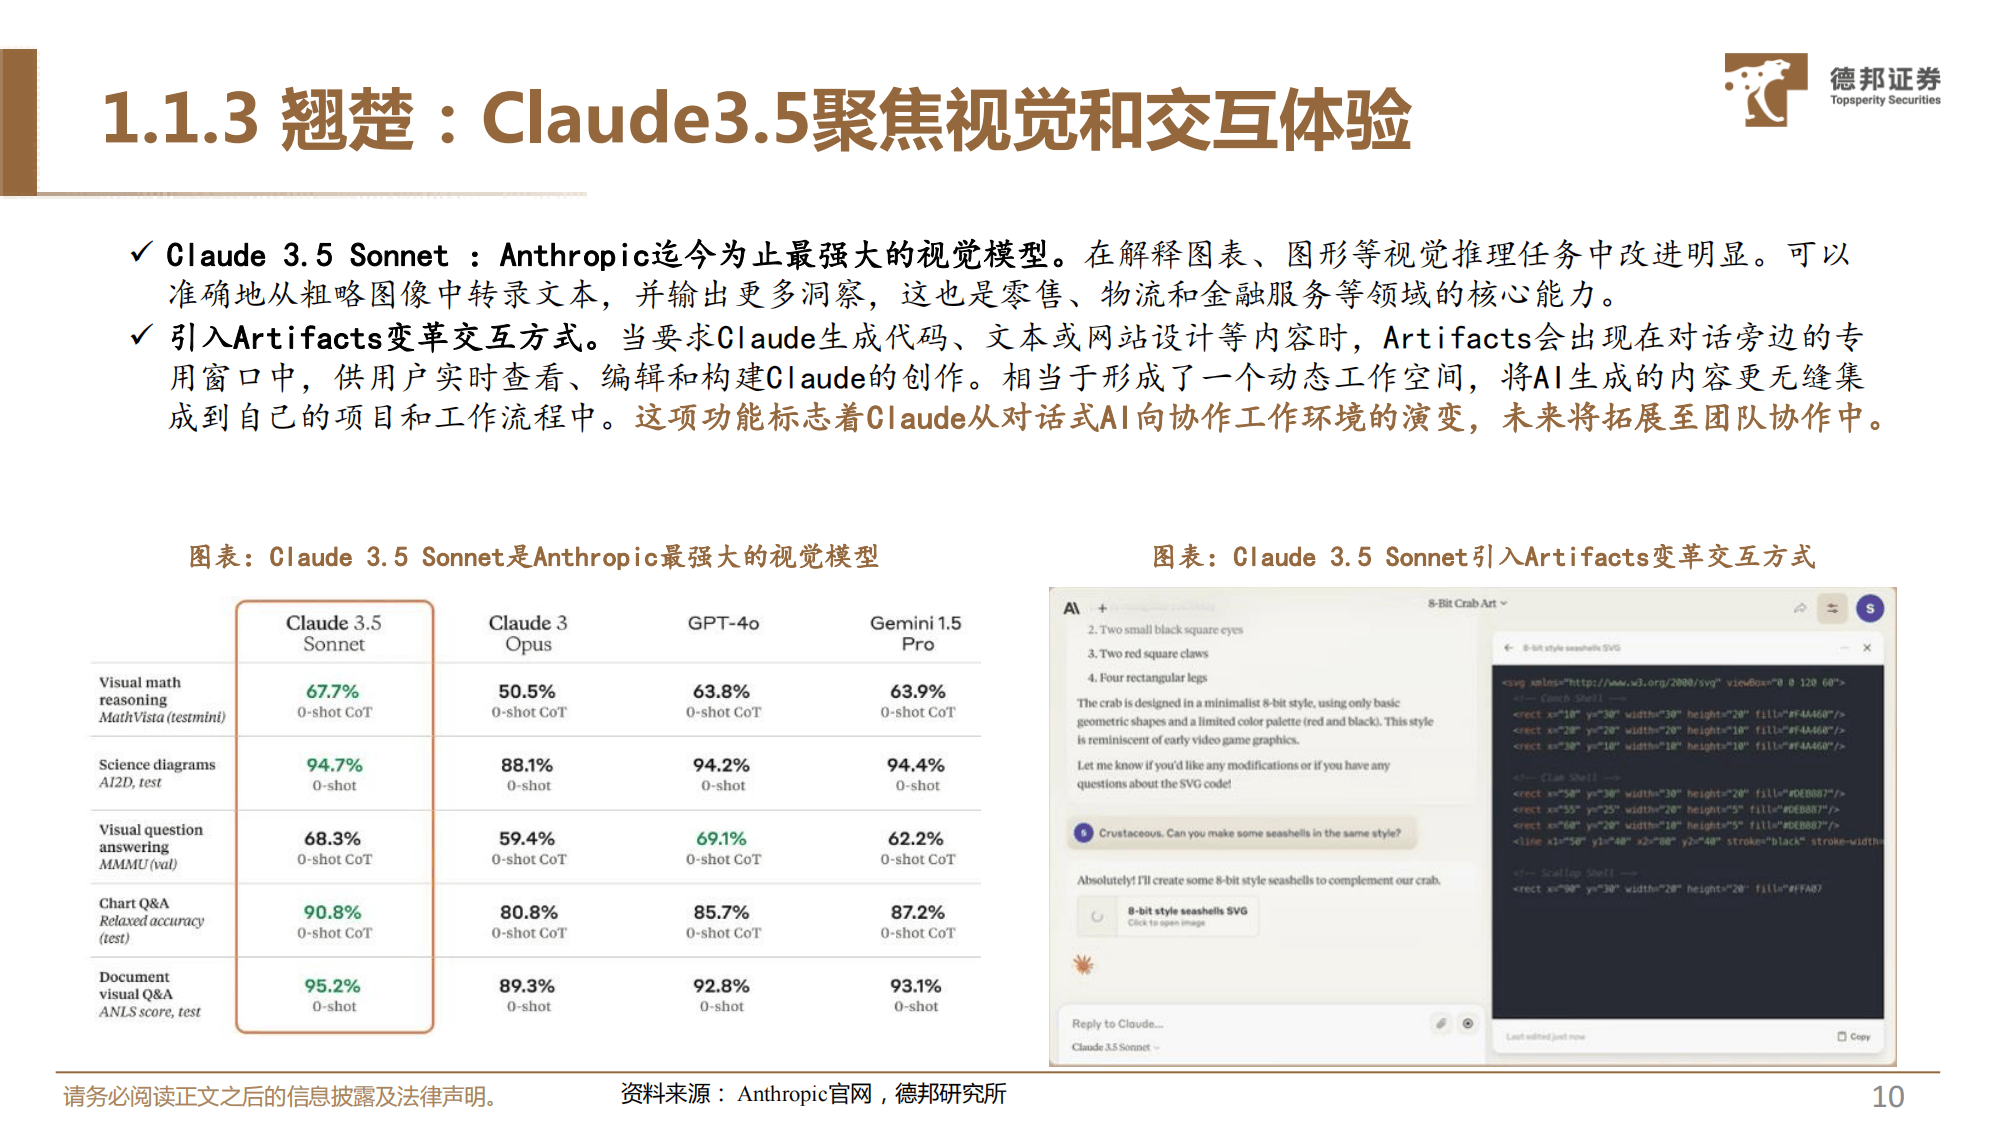
海外龙头大模型的发展与挑战:海外大模型如GPT-4、谷歌Gemini和Anthropic的Claude3.5 Sonnet等,在多模态交互、上下文理解和响应速度等方面不断刷新性能记录。这些模型通过高速迭代和多模态技术争抢市场份额,同时也面临着模型规模过大导致的计算复杂性和存储需求增加的挑战。
- 多模态交互:海外大模型能够理解和响应多种输入,包括文本、音频和视频,实现了毫秒级的响应速度。
- 上下文理解:这些模型在处理长时间跨度的上下文信息时表现出强大的推理和理解能力。
- 响应速度:海外大模型在多模态理解方面已经达到人类水平,响应速度快如人类对话中的反应时间。
- 计算复杂性和存储需求:大型模型的运行带来了巨大的计算和存储挑战。
国内大模型的技术进步与市场策略:国内大模型厂商如华为、阿里巴巴、腾讯和百度等,正在通过聚焦长文本处理和降价迭代来提升自身的竞争力。这些公司在长文本处理方面已经显示出赶超GPT的趋势,特别是在工具使用、知识与百科、长文本和生成与创作等方面。
- 聚焦长文本:国内大模型在长文本处理方面已经展现出优势,部分模型已经在处理200万字以上的超长上下文方面超越了海外大模型。
- 降价迭代:为了加速市场渗透和提升市场份额,国内大模型厂商纷纷降价,以吸引更多开发者参与和应用场景的拓展。
- 技术策略:国内大模型厂商通过优化注意力机制、引入长期记忆机制和位置编码外展等技术来突破长文本处理的限制。
- 市场定位:国内大模型厂商通过提供更具竞争力的价格和迭代速度,试图在全球市场中占据一席之地。
总的来说,国产大模型的发展前景广阔,但也面临着多方面的挑战。通过聚焦长文本处理和降价迭代,国内大模型厂商正在努力缩小与海外竞争对手的差距。同时,市场的需求和技术的进步也为投资者提供了投资机会。