王孝焱,孙秀彬,纪伊曼,张涛,刘云霞
摘 要
【关键词】纵向数据:群组轨迹模型:发展轨迹:队列研究

前 言
基本原理
1. GBTM:

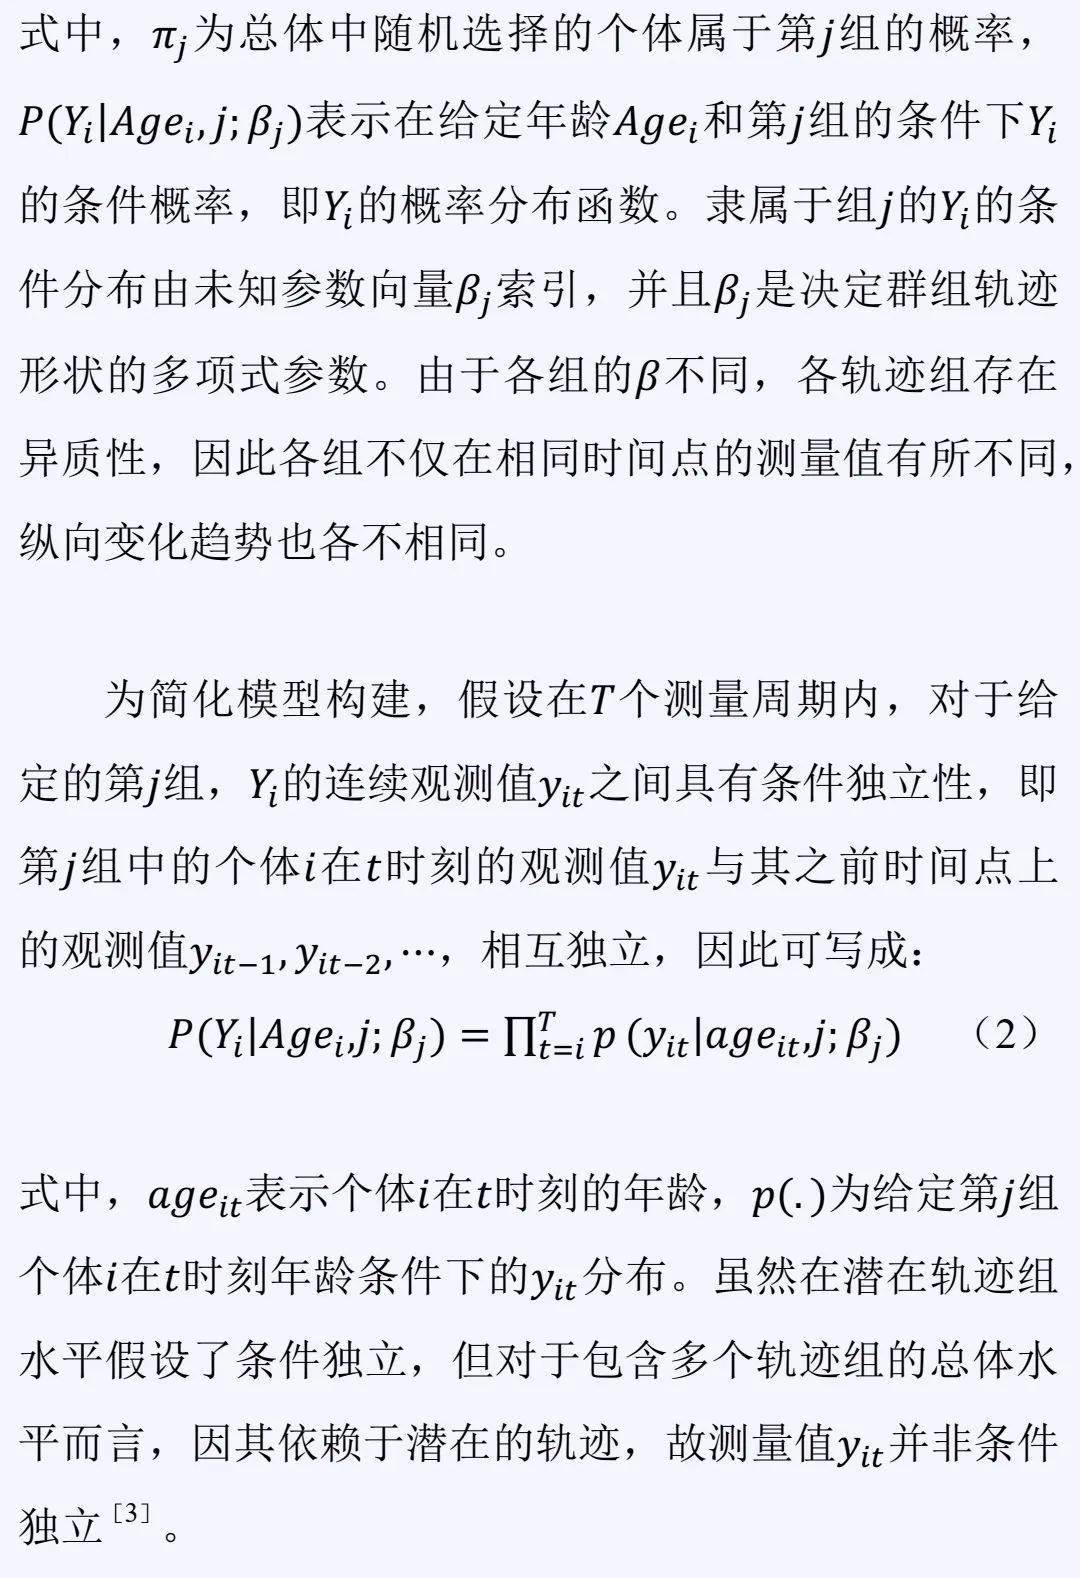
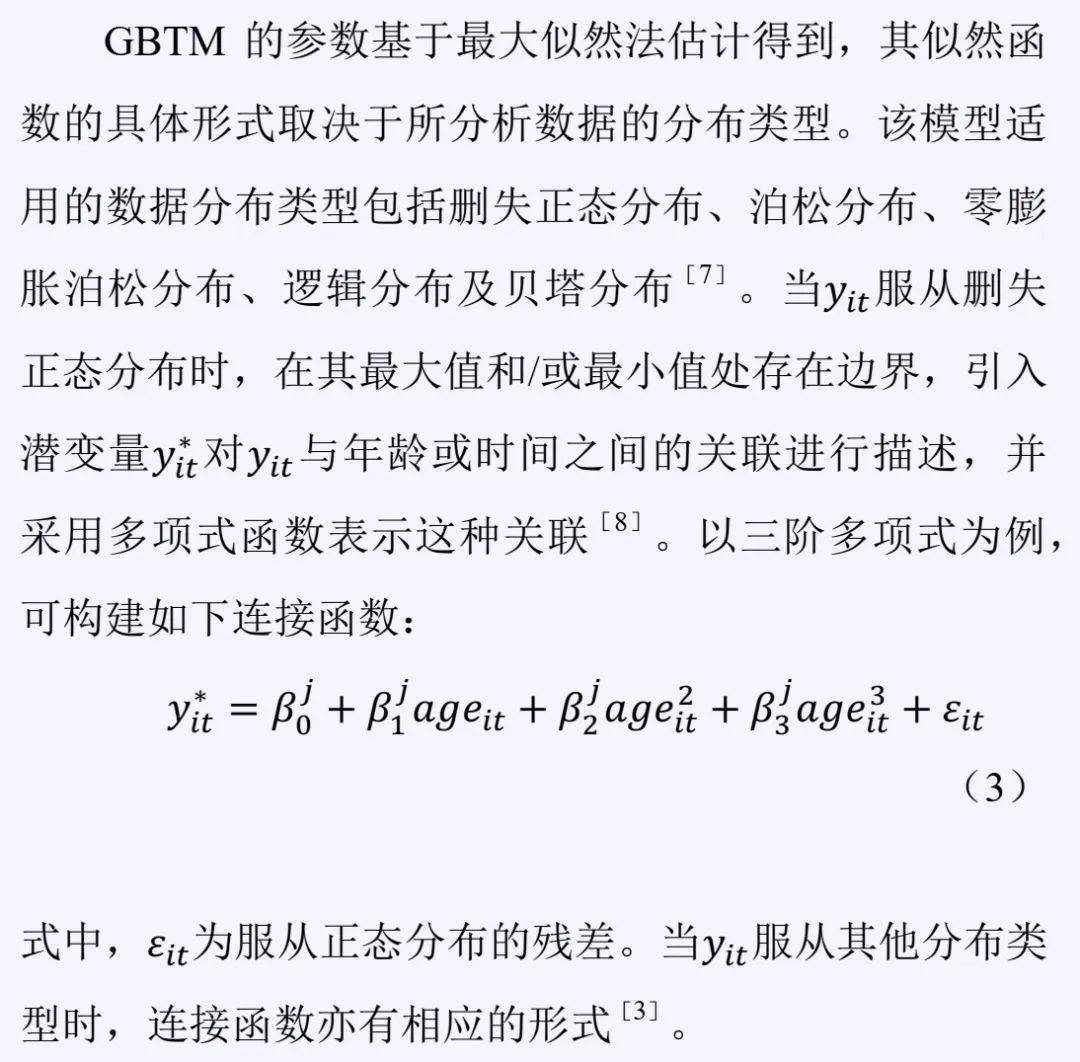
2. GBMTM:
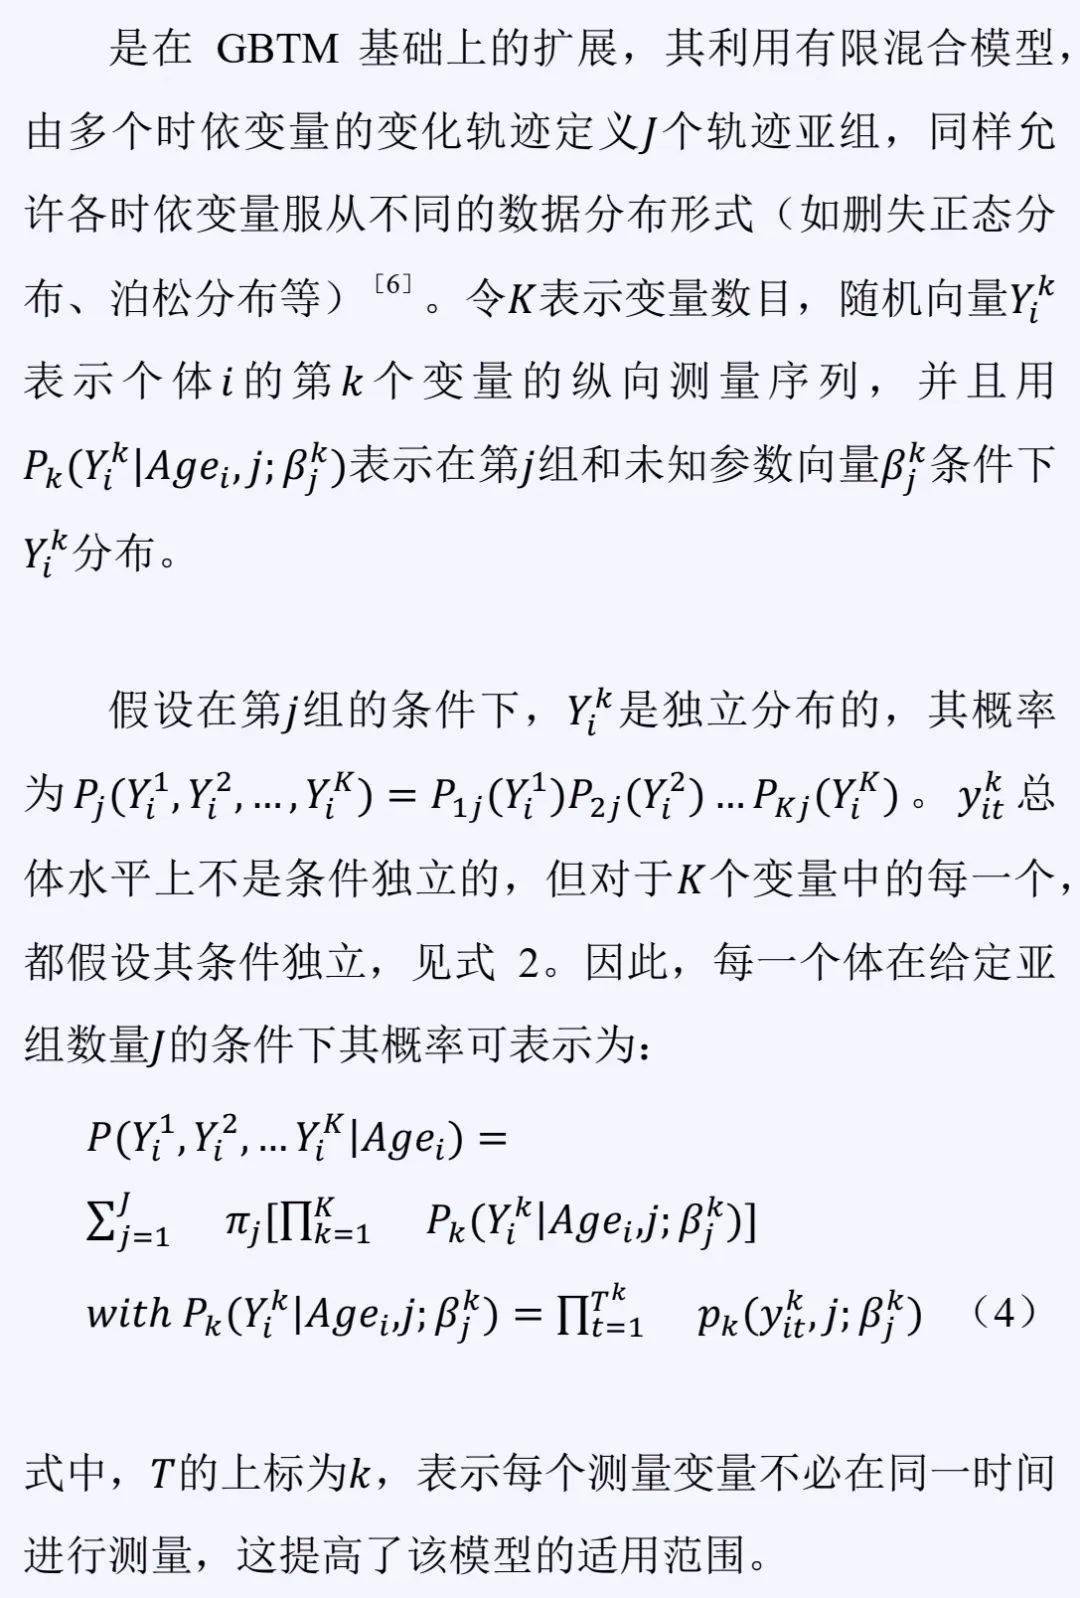
3. 最优组数及项式参数的选择:
GBTM及 GBMTM的选择通常包括 2步 [ 8-10] 。第一步选择最优轨迹组数:轨迹组数由 1开始,轨迹的最高项式次数固定为 3(三次项),在此基础上增加轨迹组数,依据贝叶斯信息准则( BIC)、平均后验概率( APPA)、正确分类优势( OCC)及组成员比例选择最优轨迹组数:
①BIC尽可能接近 0;
②各组 APPA>0.7;
③各组 OCC>5.0;
④各组至少包含 5%的参与者 [ 3,10] 。
第二步选择轨迹形状:在确定最优轨迹组数基础上,对每条轨迹从高阶三次项开始拟合,若高阶项式次数无统计学意义则继续拟合低阶项式次数,一次项即使无统计学意义也要将其保留在最终模型中。
选择合适的轨迹组数是轨迹分析的关键问题,研究中不能仅依赖于上述统计学评价标准,还应综合考虑模型的解释能力、复杂性和实用性等[ 3,10] 。最佳模型需要确保能够以最简洁和实用的方式概括数据特征;同时,还要避免过度拟合数据。如果额外的亚组并未捕捉到与其他亚组截然不同的轨迹,为简约起见,则更倾向于选择较少数量的轨迹亚组[ 10] 。目前模型构建可以通过 SAS软件的 Proc Traj过程、 Stata软件的 traj程序包和 R软件的 gbmt程序包实现 [ 6,11] 。
实例分析
1. 数据来源及统计分析:
(1)研究设计与来源:
实例数据来自于一项基于智能穿戴设备的老年人健康管理研究[ 12]。在 2018-2022年(以 3个月为 1季,共 20季),纳入基线未患高血压的 11 090名参与者,研究终点为参与者被诊断为高血压,随访时间截至 2022年 12月 31日。排除标准:
①测量值异常及重要协变量信息缺失者( n=1 024);
②基线至研究终点或随访截止时间内随访季数 <3者( n=5 276)。
最终共 4 790名参与者纳入研究。
(2)纵向测量指标:
睡眠时长(包括清醒时长、深睡眠时长、浅睡眠时长, min)、运动量( cal)和心率(次 /min)均通过统一配备的智能运动手环监测。研究中计算深睡比(即深睡眠时长 /睡眠时长)和各项指标的季平均值纳入分析。
(3)协变量:
年龄(岁)、性别、文化程度、居住形式和慢性病患病情况等通过问卷调查收集; BMI通过体脂秤获得。
(4)结局事件:
通过手臂式电子血压计进行血压监测, SBP≥140 mmHg( 1 mmHg=0.133 kPa)和 /或 DBP≥90 mmHg则认为参与者发生高血压[ 13]。计算季平均 SBP和 DBP纳入分析。
(5)统计学分析:
2. 结果:
(1)基线特征:
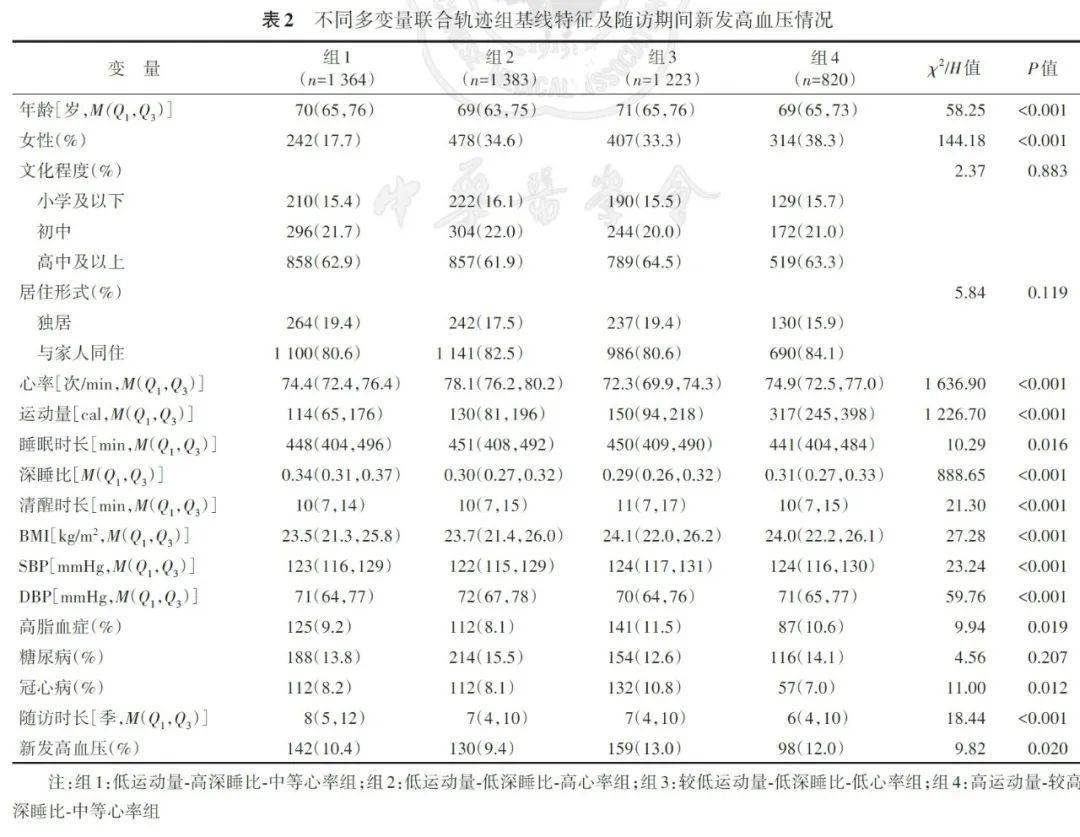
4 790名参与者的随访时长 M( Q1, Q3)为 7( 4, 11)季,随访期间共 529名发生高血压。未发生高血压者随访次数 M( Q1, Q3)为 6( 4, 10)次,发生高血压者随访次数 M( Q1, Q3)为 5( 4, 7)次。未发生高血压人群年龄 M( Q1, Q3)为 69( 64, 75)岁,发生高血压人群年龄 M( Q1, Q3)为 72( 66, 78)岁。
(2)GBTM分组:
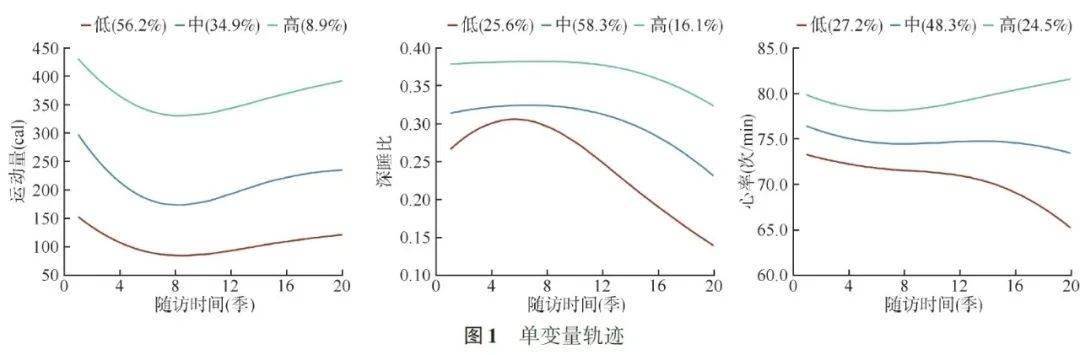
(3)GBMTM分组:
基于 GBMTM拟合轨迹过程中的逐步筛选指标,结果显示,轨迹组数为 5的模型其 BIC值优于轨迹组数为 4的模型,拟合指标均达到推荐值。然而,轨迹组数为 5的模型中并未发现与轨迹组数为 4的模型有实质性差异的组。见表 1。
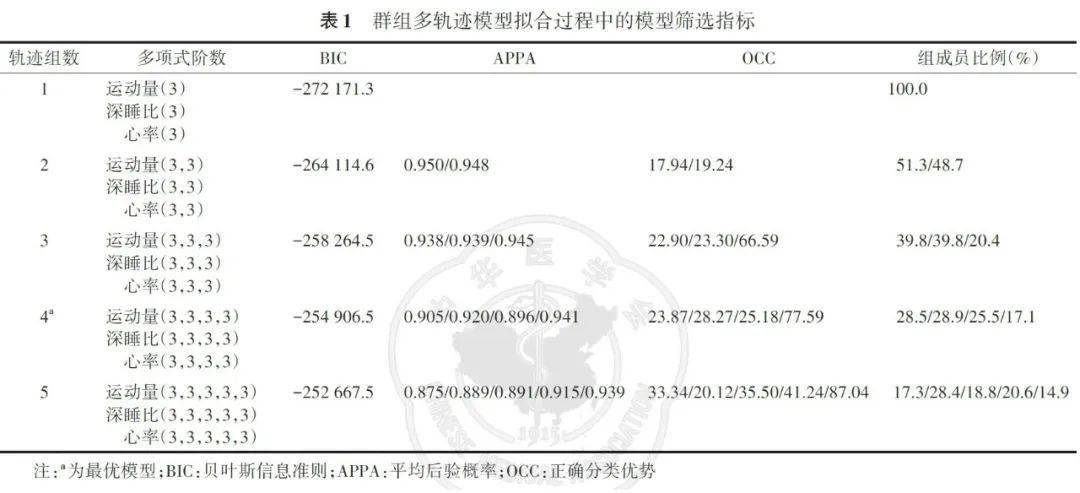
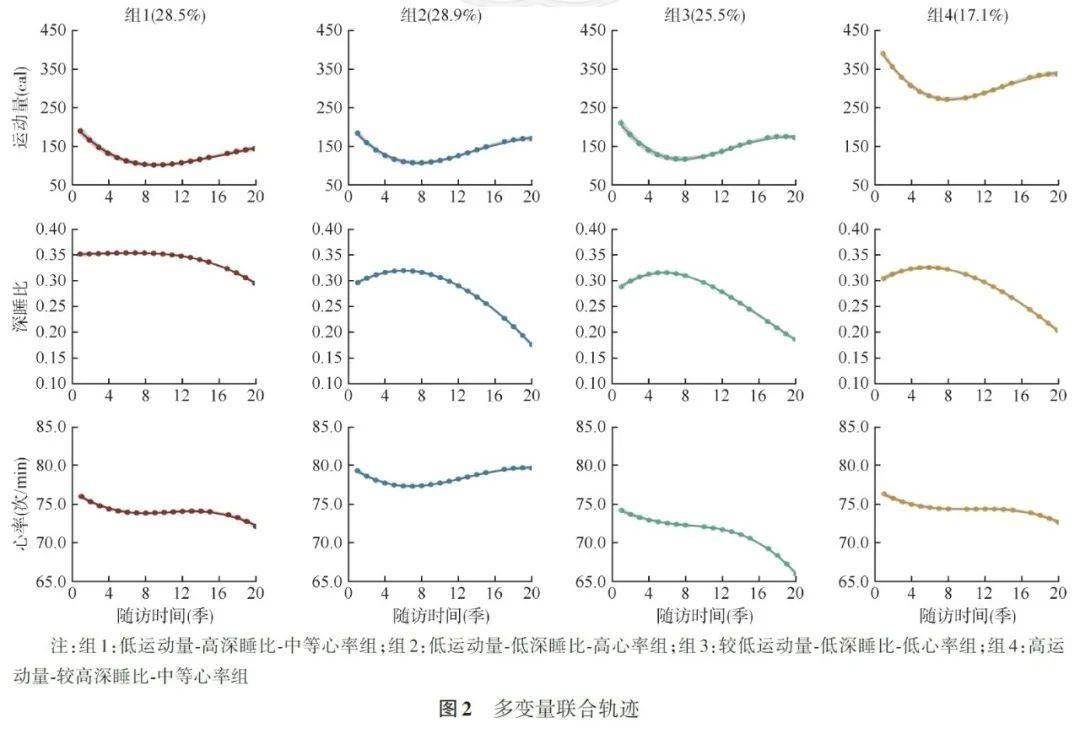
为简单起见,本研究最终选择轨迹组数为 4的联合轨迹模型,按轨迹特征分别命名为:低运动量 -高深睡比 -中等心率组(组 1)、低运动量 -低深睡比 -高心率组(组 2)、较低运动量 -低深睡比 -低心率组(组 3)和高运动量 -较高深睡比 -中等心率组(组 4)。其中,组 1各项纵向指标的变化趋势均较为平稳且深睡比最高;组 2心率水平最高;组 3与组 2的差异主要体现在心率水平及变化趋势不同,组 3心率水平低且呈下降趋势;组 4运动量最高。见图 2。
各轨迹组中组 1中女性比例最低,组 2中高脂血症患者比例最低,组 3中 BMI水平较高且冠心病患者比例较高,组 4的随访时长最短。不同轨迹组间的基线运动量、深睡比及心率差异有统计学意义(均 P<0.001)。见表 2。
(4)不同轨迹分组的高血压发生风险:
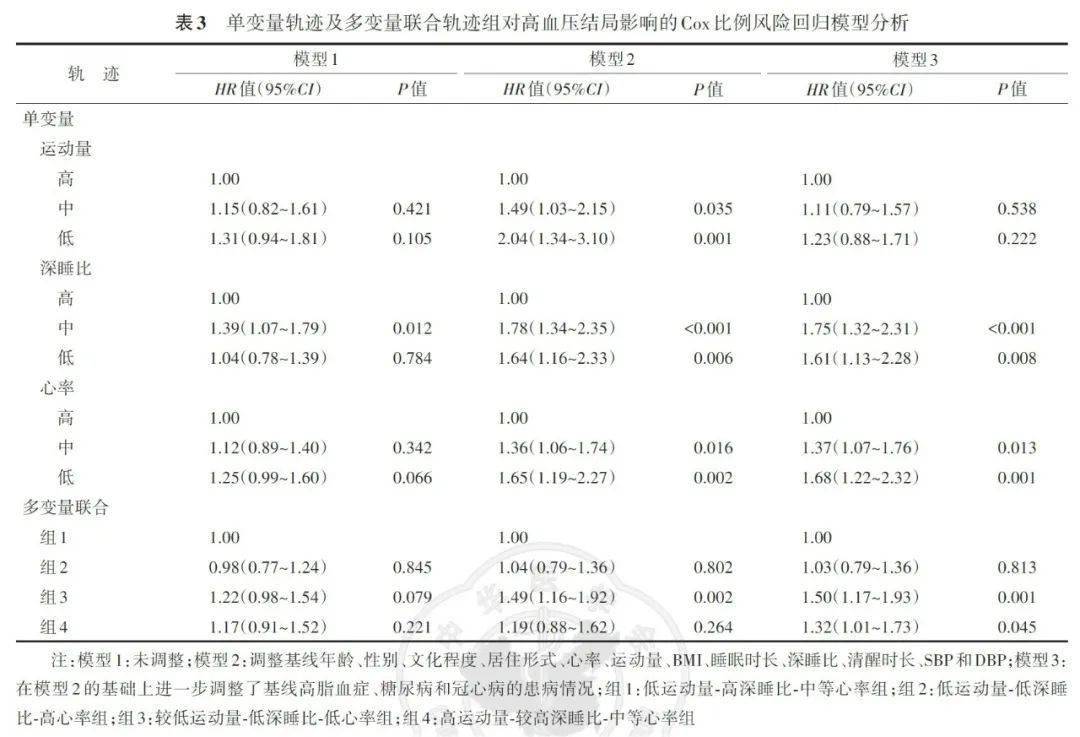
在单变量轨迹分析中,深睡比轨迹组及心率轨迹组与参与者高血压发生风险间有统计学关联。在调整混杂因素的模型 3中,以高深睡比组作为参照,中等深睡比组和低深睡比组的风险比( HR)值( 95%CI)分别为 1.75( 1.32~2.31)和 1.61( 1.13~2.28),以高心率作为参照,中等心率组和低心率组的 HR值( 95%CI)分别为 1.37( 1.07~1.76)和 1.68( 1.22~2.32)。在变量联合轨迹分析中,以组 1(低运动量 -高深睡比 -中等心率组)作为参照,在调整混杂因素的模型 3中,组 3(较低运动量 -低深睡比 -低心率组)和组 4(高运动量 -较高深睡比 -中等心率组)的 HR值( 95%CI)分别为 1.50( 1.17~1.93)和 1.32( 1.01~1.73),而未发现组 2(低运动量 -低深睡比 -高心率组)与参与者高血压发生风险间有统计学关联。见表 3。
讨 论
近年来,针对个变量发展轨迹的聚类分析方法不断涌现,如GBMTM、变量潜在类别混合模型(MLCMM)[5,18] 和贝叶斯一致聚类模型(BCC)[19] 等基于模型的方法,以及K均值聚类[20] 等基于算法的方法。值得注意的是,上述基于模型的方法均需要轨迹形式和随机效应分布形式的假设,但在如何对随机效应进行建模方面存在差异,GBMTM假设不存在随机效应,而MLCMM假设亚组间的随机效应分布存在差异,但在变量间无差异[21] 。虽然后者建模更灵活,但其假设所有变量具有相同的随机效应分布,这在实际中可能是不现实的,特别是当每个变量代表不同的生物过程时。相比而言,BCC则假设随机效应在亚组和变量之间均存在差异,并且进一步假设如果给定潜在类别,不同变量的随机效应分布是独立的。另一方面,基于算法的方法不需要关于轨迹形式和随机效应分布形式的假设,因此可更灵活地捕获曲线的形状,特别是在分析非项式轨迹时。然而,此类方法无法量化分组的不确定性,其要求测量值无缺失且在固定时间点记录[22] 。由于目前尚无相应的统计学检验方法来评估这些假设,故很难在实际中进行验证。因此,需要在具体研究设计和学科知识的基础上仔细考虑这些假设,并对可能的模型进行相互比较[17] 。与其他方法相比,GBMTM具有以下优势:
①不同变量的测量时间可以是不同尺度(如年、小时或分钟);
②能够同时对个不同类型的变量进行聚类分组(如连续变量、离散变量和分类变量);
③允许数据含有缺失值;
④允许通过后验聚类概率量化组内成员的不确定性;
⑤分组结果易于解释。 返回搜狐,查看更多