做转录组+代谢组联合分析时,你是否常陷入两个困境:一是手里攥着几百个差异基因和几十种差异代谢物,却找不到它们的关联逻辑;二是知道某代谢物(如有机酸、香气萜类)和表型强相关,却说不清“哪些基因调控该代谢物合成”“代谢物又如何影响表型”?
加权基因共表达网络分析(WGCNA),恰好能打破这种“碎片化分析”的局限。它以转录组基因为核心构建共表达网络,将基因按表达模式聚类成“功能模块”,再通过模块与“代谢组差异分子+目标表型”的双向关联,最终定位“基因-代谢物-表型”的调控链。
为避免单个案例无法解释清楚,小编给大家找了3篇高分研究,涉及植物低磷适应、果实香气调控、重金属胁迫缓解,多角度给大家拆解每个案例中“转录组模块与代谢组的联动逻辑”,干货满满,赶紧收藏防止找不到噢!
用途1:模块-性状关联——解析“转录-代谢协同调控表型”的机制
案例——低磷胁迫下莎草“胡萝卜状根”的代谢适应
研究背景
莎草科植物的“胡萝卜状根”是低磷环境的特有适应结构:一方面通过分泌有机酸(如苹果酸)溶解土壤难溶性磷,另一方面通过增加根毛密度扩大吸收面积。但“哪些基因调控有机酸合成?”“根形态变化与代谢调整是否由同一网络控制?”,该研究利用WGCNA的“模块聚类”回答了这两个问题。
样本设计
短苞苔草根组织,2个磷水平(高磷HP/低磷LP),LP组分三个发育阶段,n=3,15样本。
代谢组检测:聚焦在根系分泌物中的有机酸(苹果酸、丙二酸)、根组织中的碳水化合物(蔗糖、半乳糖),通过VIP≥1且p<0.05,最终得到28个差异代谢物。
WGCNA分析设计与核心步骤
1. 数据预处理:转录组保留表达量≥2的19,843个基因(去除低表达噪声)
2. 软阈值确定:power值检验,当power=6时,基因网络的“无标度拓扑拟合指数”>0.8(满足WGCNA要求),且平均基因连通性最高(1259.62),确保网络可靠性。(文献未展示图形)
3. 模块构建与表型关联:共聚类得到22个共表达模块(图1A)
模块-样本表达热图(图1B):锁定两个关键模块,黑色模块在S2-S3高表达、浅黄色模块在S1高表达,对应“先分化根毛(S1),再强化磷吸收(S2-S3)”的生理过程。
基因-代谢物关联:
富集气泡图:黑色模块富集“糖酵解”“有机酸运输”通路(图1C-D),浅黄色模块集“植物细胞壁组织”“根毛发育”通路——与“基因-代谢物关联结果”完全匹配,证明模块功能不是“推测”而是“有多层证据支撑”。
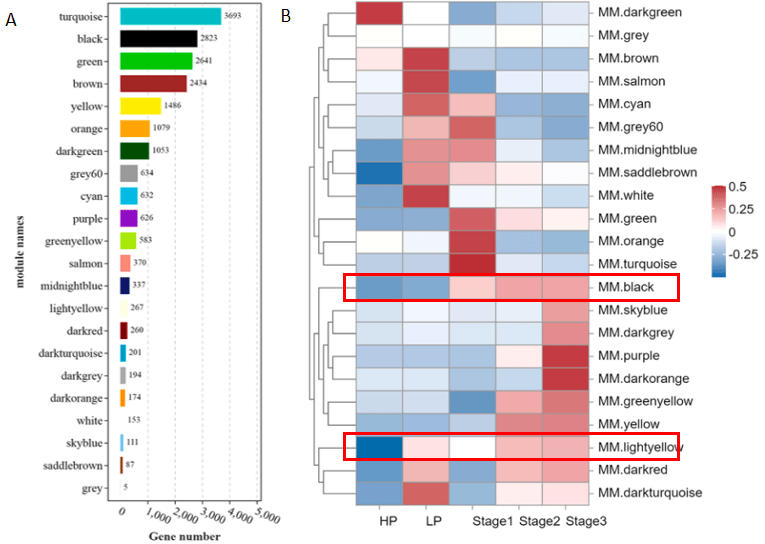
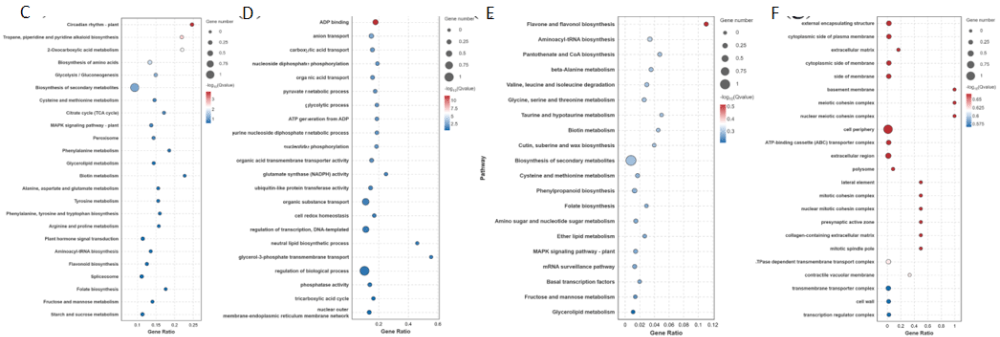
图1模块分类柱状图(A);模块-样本相关性热图(B);
黑色和浅黄色模块内基因的KEGG和GO富集分析气泡图(C-F)
核心价值
若仅做转录组差异分析,会发现“糖酵解基因和根毛发育基因均在低磷下上调”,但无法区分“两者是否独立调控”;若仅做代谢组,会发现“苹果酸和蔗糖均积累”,却找不到调控基因。WGCNA通过“模块聚类”,明确这两个过程分属“黑色-浅黄色模块”,且有各自的“基因-代谢物协同逻辑”,最终整合为“低磷适应的两步策略”。
用途2:锚定品质表型—筛选调控代谢物合成的hub基因
案例——海拔影响草莓果肉香气
研究背景
草莓香气由200+挥发性代谢物构成,其中紫苏醇(单萜类)、α-法尼烯(倍半萜类)是“高海拔草莓更香浓”的核心原因。但“海拔如何通过基因调控萜类合成?”“是否有一个基因能同时影响多种香气物质?”,这些育种关键问题可通过WGCNA的“模块-表型关联+hub基因筛选”解决。
样本设计
3个草莓基因型(P1:香气淡;P2香气中等;F₁:香气浓郁)×2个海拔,n=3,共18样本
代谢组检测:重点关注萜类(紫苏醇、α-法尼烯)、酯类(E-2-己烯基苯甲酸酯),通过VIP≥1且p<0.05,最终得到16个差异香气代谢物。
WGCNA分析设计与核心步骤
1. 数据预处理:9292个DEGs(差异表达基因,FDR<0.05,|log₂FC|≥1)
2. 软阈值设定与模块构建:设定软阈值=10,聚类得到21个模块。
3. 模块与表型关联
模块-样本表达热图(图2A):锁定调控草莓品质的核心模块——“saddlebrown”,该模块与香气成分(紫苏醇、α-法尼烯)、糖酸比、硬度均呈极显著正相关(P<0.001)。
4. hub分子筛选:
对saddlebrown模块内的基因,按“模块内连通性(|K.in|>40)”和“模块相关性(|MM|>0.90)”筛选hub基因,最终得到3个关键调控基因(图2B中星标分子)。
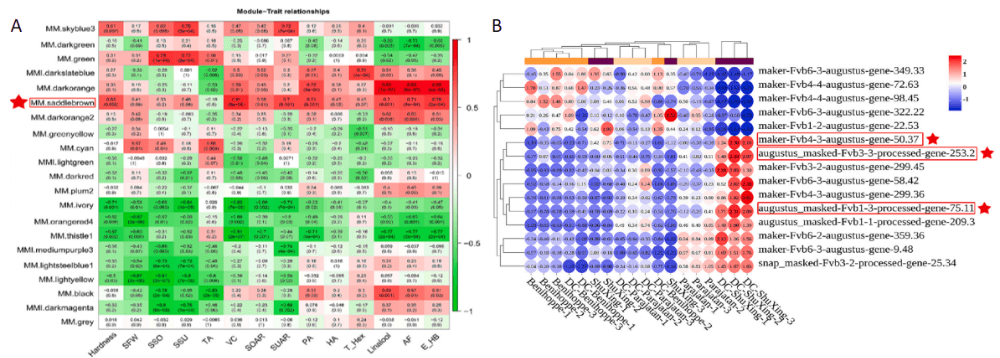
图2 模块性状关联热图(A);目标模块基因在不同样本中表达风丰度热图
5. 3个hub基因的“代谢调控证据”:
这3个基因在高海拔草莓中的表达量是低海拔的1.9-2.5倍,且与香气代谢物(紫苏醇)含量呈正相关(r>0.85),完美印证了它们的调控作用。
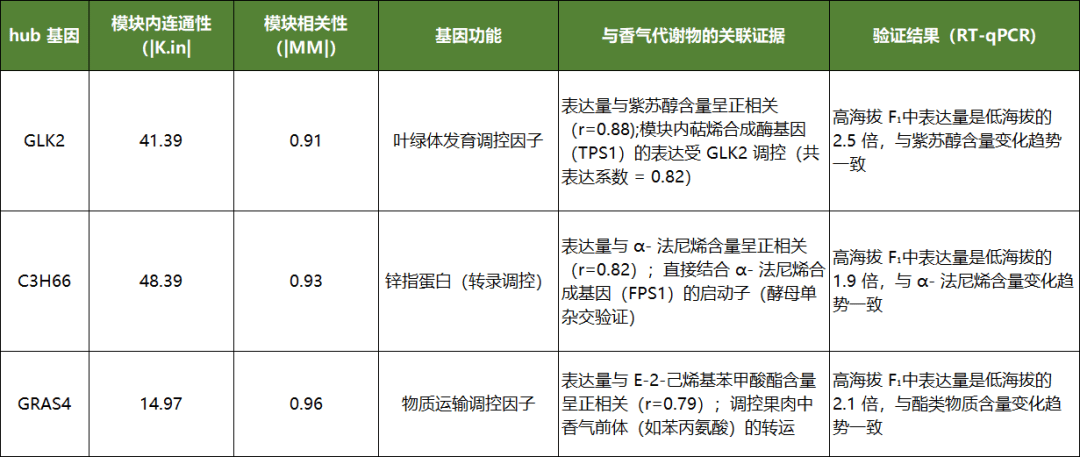
核心价值
WGCNA从海量基因中精准筛选出可用于育种的hub基因,解决了“代谢组差异分子多但调控靶点不明确”的问题,为优质草莓分子育种提供直接依据。
用途3:解析外源干预效应,构建“多维度互作网络”
案例——硅纳米颗粒缓解黑麦草铅胁迫
研究背景
铅(Pb)会抑制植物根系吸收氮、磷等营养元素,还会诱导活性氧积累;硅纳米颗粒(SiNPs)可缓解Pb毒性,但机制存在争议:有人认为SiNPs会在根表面形成屏障,阻止Pb进入;也有人认为SiNPs会调控植物代谢,增强Pb解毒能力——WGCNA通过“多维度数据整合”,明确了“代谢调控是核心机制”。
样本设计
黑麦草根组织,4个处理组(CK、Pb、SiNPs、Pb+SiNPs),n=3,共12个样本。
多维度数据采集:①转录组(DEGs);②代谢组(根组织中谷氨酸、GABA、己酸;根系分泌物中草酸);③环境/生理指标(土壤DOC含量、植物根Pb含量、光合参数Pₙ)WGCNA分析设计与核心步骤。
分析设计与核心步骤
1. 数据预处理:DEGs(差异基因)+DEMs(差异代谢物:谷氨酸、己酸)+环境/生理指标(土壤DOC、SOM;植物Pb含量、光合参数Pₙ)。
2. 软阈值设定与模块构建:设定软阈值=6,聚类得到22个模块。
3. 多维度关联及验证
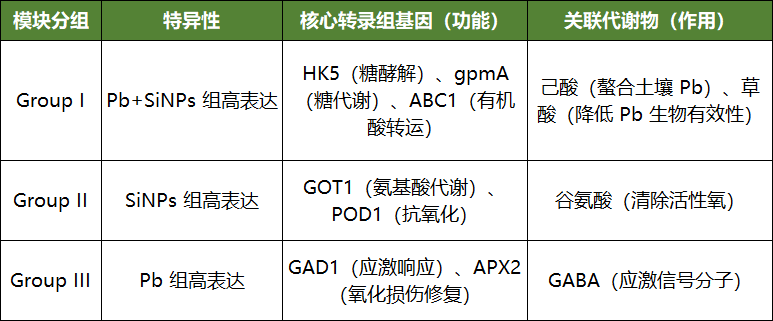
模块-样本表达热图(图3A)中,按不同处理的关联性,将模块又分为了三组。
①将模块内核心基因和代谢物关联
②将模块内核心基因和环境/生理指标关联
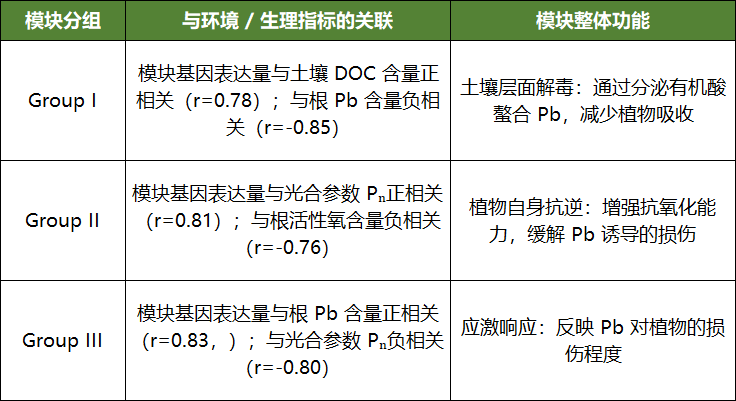
GroupI的糖酵解基因与根分泌物中草酸正相关,草酸促进Si吸收;Si含量升高显著降低根中Pb含量,最终形成“SiNPs→GroupI激活→草酸分泌→Si吸收→Pb解毒”的闭环。
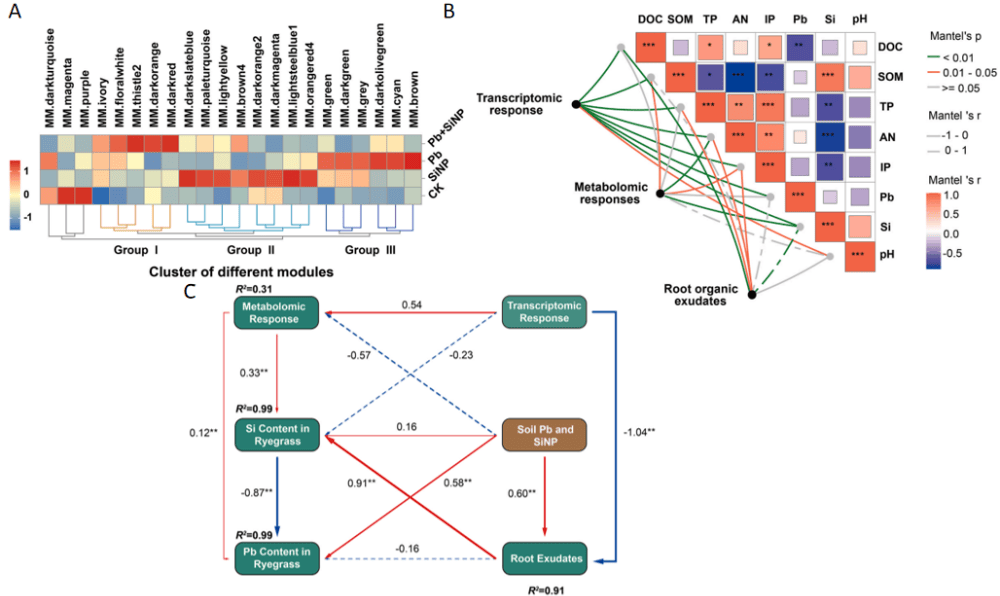
图3 模块-样本关联热图(A);Mantel检验热图(B);PLS-SEM图(C)
核心价值
WGCNA整合“分子-生理-环境”多维度数据,不仅解析了SiNPs缓解Pb毒性的机制,更构建了可推广的“外源干预-植物响应”网络模型,为重金属污染土壤修复提供新策略。
WGCNA在转录、代谢组研究中的共性逻辑与实操建议
结合上述3篇文献,小编在此给大家整理了一套详细实操流程:
1. 样本设计(针对整合分析):
①需≥12个(生物学重复≥3),否则模块聚类易受噪声干扰;
②转录组样本与代谢组样本必须完全匹配”(同一植株、同一组织、同一处理时间),避免“基因与代谢物来自不同样本”的逻辑漏洞;
③若研究“胁迫/发育”,需覆盖关键阶段,否则模块可能无法体现“时空/处理特异性”;
④代谢物检测优选“与表型直接相关的代谢物”(如案例2的香气萜类、案例3的抗逆氨基酸),而非“无目的的全代谢物检测”,减少数据冗余。
2. 数据预处理:
代谢组保留VIP≥1、p<0.05的差异代谢物;转录组保留FPKM>2的基因。降低数据噪音。
3. 模块筛选与构建:
①软阈值选择:power值使拓扑拟合指数R²>0.8,确保网络可靠性;
②模块-表型关联:选|r|>0.8、P<0.01的模块,相关性过低的模块可能无实际功能;
③功能验证:模块需同时满足“KEGG/GO富集与表型相关”+“模块内基因与代谢物正相关(r>0.65,p<0.05)”,两层证据支撑,避免假阳性;
④hub分子筛选:按“|K.in|>40且|MM|>0.9”筛选,且最好用RT-qPCR(基因)、靶向代谢组(代谢物)验证表达趋势,确保hub分子的可靠性。
小 结
很多小伙伴在做“转录组-代谢组整合分析”时,只是“分别做差异分析,再找几个共富集通路”,本质是“数据堆砌”。而WGCNA的价值在于:
对转录组:将差异基因聚类为“功能模块”,避免“单个基因分析”的碎片化;
对代谢组:将代谢物作为“模块功能的验证指标”,明确“基因调控哪些代谢物”;
对表型:构建“模块-代谢物-表型”的关联,最终形成可验证的“调控链”(如案例2的“GLK2→TPS1→紫苏醇→香气品质”)。
通过本文的3个案例,你会发现只要掌握“模块功能定位需结合转录组+代谢组+表型”的逻辑,就能让你的研究从“描述现象”升级为“解析机制”,轻松满足高分文章的要求。返回搜狐,查看更多