CDA
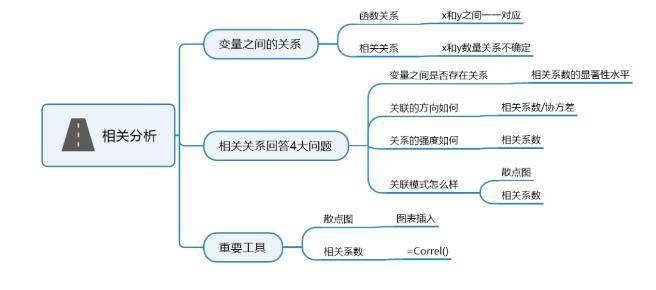
相关性分析用于衡量两个或多个变量之间的关联强度和方向,变量间存在相互影响但不一定存在因果关系。
“万物皆有联”,是大数据一个最重要的核心思维。事物这种相互影响、相互关联的关系,在统计学上就叫做相关关系,简称相关性。 今天,我们将从实战角度给大家系统梳理「相关性分析」的完整工作流程。
01
“相关性”是什么?
在日常工作中,我们经常会遇到下面这些问题:
HR经常会问:影响员工离职的关键原因是什么?是工资还是发展空间?
销售人员会问:哪些要素会促使客户购买某产品?是价格还是质量?
营销人员会问:影响客户流失的关键因素有哪些?是竞争还是服务等?
产品设计人员:影响汽车产品受欢迎的关键功能有哪些?价格、还是动力等?
要解答这些问题,都离不开相关性分析。无论是运营问“优惠券面额与复购率到底有没有关系?”,还是产品问“新功能上线后留存提升是巧合还是因果?”这些问题的第一步都是度量相关性。
相关性可简单的分为正相关、负相关和不相关,当然也有相关性程度的强弱之分,可视化图表表示如下:
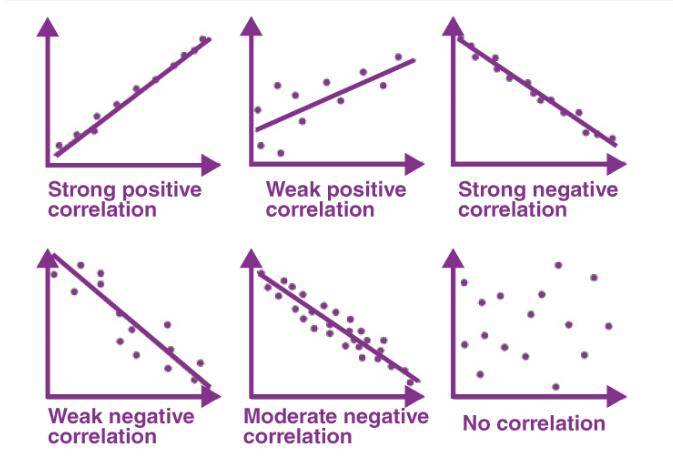
在数据分析中,我们通常使用相关系数来衡量变量之间的相关程度。常见的相关系数包括皮尔逊相关系数、斯皮尔曼相关系数、切比雪夫相关系数等等。
1.皮尔逊相关系数
即Pearson Correlation Coefficient,用于衡量两个连续变量之间的线性关系,值介于-1和1之间。值越接近1或-1,表示变量之间的线性关系越强;值接近0,表示几乎没有线性关系。
2.斯皮尔曼秩相关系数
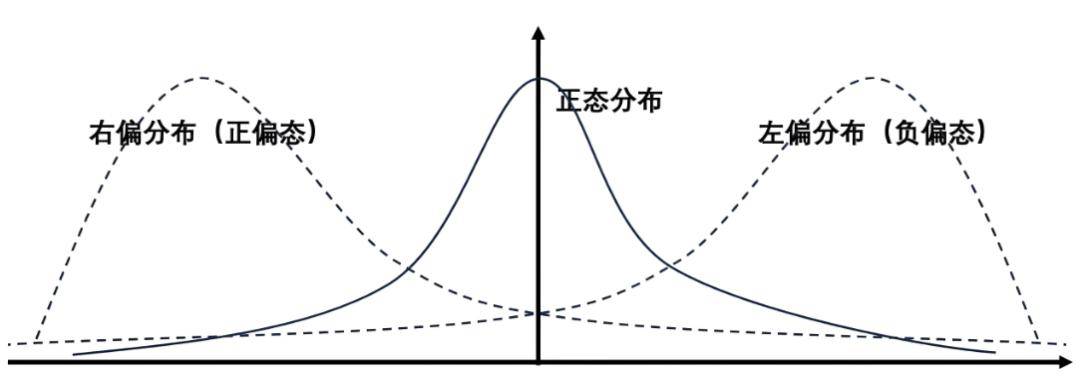
Spearman's Rank Correlation Coefficient,用于衡量两个变量之间的单调关系,即使这种关系不是线性的。常用于处理不满足正态分布或包含异常值的数据。
3.肯德尔等级相关系数
即Kendall's Tau,用于衡量两个变量之间的相关性,适合处理小样本数据或数据中存在相同值的情况。
其中,皮尔逊相关系数是最为常见的一种,它可以用来衡量两个变量之间的线性关系程度。
相关性并不代表因果关系。两个变量之间的相关性只是表明它们之间存在某种联系或关联,但并不一定能够说明其中一个变量的变化是导致另一个变量发生变化的原因。
02
相关性分析流程六步法
我们以 2023年6–8月某自营电商“美妆类目”真实日志为例,分析目标是量化“优惠券面额”与“用户 90 日复购率”之间的关系。
1.业务问题拆解
核心指标:90 日复购率(连续,0–1)。
关键变量:优惠券面额(连续,0–200 元)。
潜在混淆:客单价、访问频次、品类偏好、用户等级。
2.数据清洗 & 探索
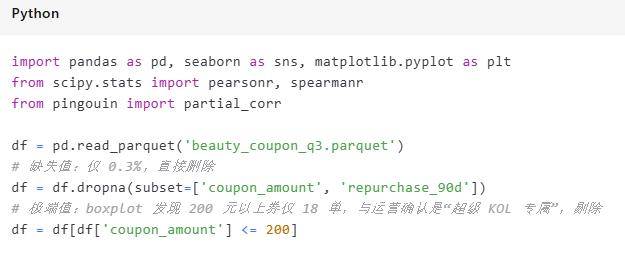
在做相关性分析前,需要对对数据的异常值、缺失值、重复值等进行清洗,确保数据可用。
也可以先通过绘制散点图来直观感受一下数据是否有相关性,如果有相关性,再进行后续的操作,没有相关性就可以停止了。
3.单相关系数计算
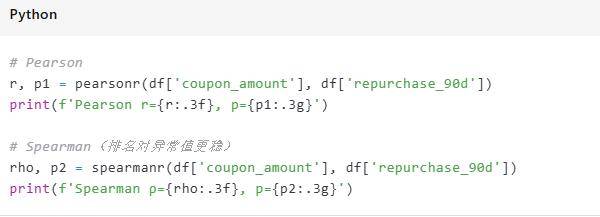
根据对数据进行但相关系数进行计算,最后得结果:
Pearson r = 0.42,p < 0.001
Spearman ρ = 0.39,p < 0.001
→ 两者方向一致,说明存在中等偏强的正向单调关系,且非完全线性。
4.可视化验证
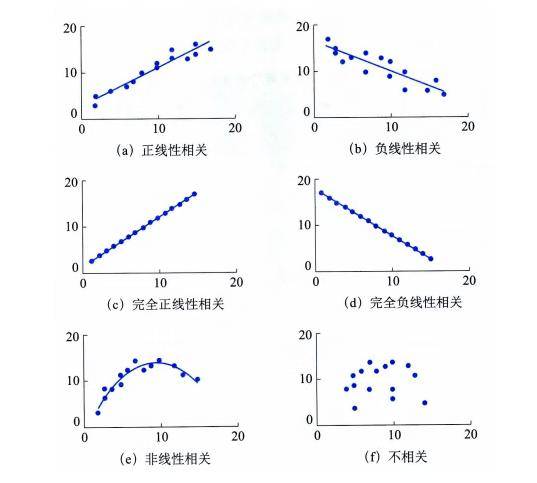
散点图显示:
– 0 元券(对照组)复购率均值 18%;
– 50–100 元券区间复购率随面额抬升斜率最大;
– 150 元以上斜率趋缓,疑似边际递减。
5.控制混淆——偏相关
输出:r_partial = 0.35,p < 0.001。
解释:剔除客单价影响后,面额与复购率仍有实质性相关,强度从 0.42 降到 0.35,说明约 1/6 的原始相关可被“高客单用户更爱领高面额券”解释,但主效应仍在。
6.业务落地 & 因果下一步
相关结果已支持“继续加大券面额”的假设,但需因果验证。
设计阶梯券随机实验:将6000人按10/30/50/80 元4组真正随机发放,观测复购率差异,用双重差分剔除季节因素。
若实验证实因果,再建立 ROI 模型:用回归量化“每增加 1 元券成本带来多少毛利”,找到最优面额。