作者:中原银行零售信贷与信用卡部 信亚楠 蒋梦梦
一、引言:智能风控体系演进与决策树算法的再思考
随着金融业务的不断拓展和创新,大数据、人工智能等技术的迅猛发展,智能风控体系应运而生,它通过对海量数据的实时分析和挖掘,能够精准识别潜在风险,为金融决策提供有力支持,有效降低信用风险、欺诈风险等各类风险带来的损失,显著提升金融机构的风险管理效率和竞争力。在智能风控体系的庞大架构中,众多算法模型犹如精密仪器上的关键零部件,各自发挥着独特作用。逻辑回归结构简单,表现稳健,可解释性极强。通过特征分箱和WOE编码,可以生成一个直观的、有业务解释性的评分卡。这是金融领域,尤其是银行长期以来的黄金标准和基线模型。2016年xgboost横空出世,集成算法逐渐走到了风控建模的舞台中央,成为目前业界的主流算法和性能冠军。集成算法能自动捕捉复杂的特征交互,学习捕捉数据中微妙的非线性交互关系,通常能够达到更高的预测精度。
在众多算法中,决策树因其模型结构清晰、规则可解释性强,在风控领域长盛不衰,得到众多建模人员的青睐。其基本思想是通过对特征空间的递归划分,构建树形结构以实现分类或回归任务。决策树能够直观地输出“如果-那么”类型的业务规则,便于风控策略人员理解与应用,因此在客户分群、反欺诈识别、额度定价等场景中广泛应用。
然而,传统的单颗决策树算法存在着诸多明显的缺点,限制了其在复杂风控场景中的应用效果。
一是稳定性差:决策树对数据的微小变化极为敏感,哪怕是数据中出现少量噪声或异常值,都可能导致生成的决策树结构发生巨大改变,进而使风险评估结果产生较大偏差。例如,在客户信用评估中,若某客户的一条交易记录因数据录入错误而出现偏差,可能就会使决策树的分支结构发生变化,原本被评估为低风险的客户可能会被误判为高风险。
二是容纳指标少:当面对海量高维数据和众多维度时,传统决策树在选择特征进行分裂时,往往只能关注到部分重要特征,难以充分利用所有有效信息,导致对复杂风险模式的识别能力不足。
三是易过拟合:如果不对决策树进行适当的剪枝处理,它很容易过度学习训练数据中的细节和噪声,使模型在训练集上表现出色,但在新的测试数据或实际应用中,却无法准确泛化,导致风险预测出现较大误差,无法有效识别真实风险。
四是对数据变化敏感:金融市场环境瞬息万变,客户的行为特征和风险状况也在不断变化,传统决策树算法难以快速适应数据分布的动态变化,当新的数据模式出现时,其性能会显著下降,无法及时准确地捕捉风险信号。
二、破局:递归样本删除决策树算法
为克服传统决策树算法的上述缺陷,本文创新性地提出了递归样本删除决策树算法。该算法的核心思想在于通过逐层剥离已被“理解”的样本,迭代地在剩余“疑难”样本上构建新的决策树,从而实现对客户群体的多层次、精细化分群。
1.算法流程
该算法的执行过程可形式化表述如下:
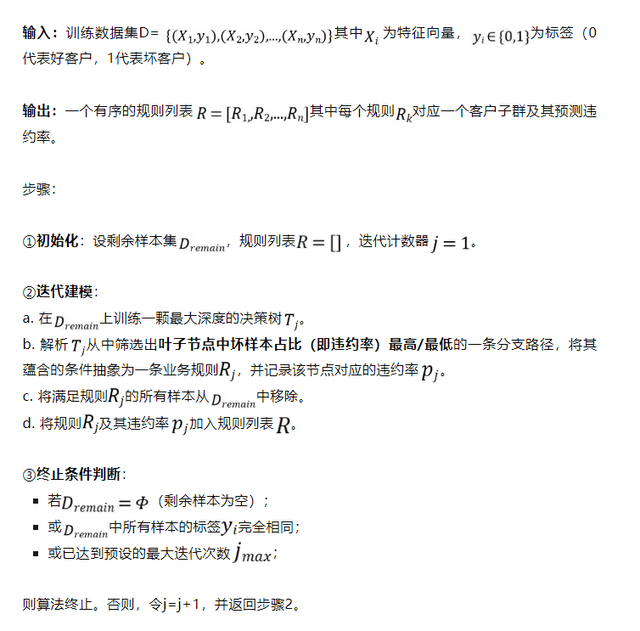
 图1 递归样本删除决策树算法流程图
2.算法的创新点与提升之处
①稳定性增强:通过将整体样本集分解为多个互斥的子集,并在各子集上独立建树,有效降低了模型对整体数据扰动的敏感性。即使某一次划分因数据波动产生偏差,其影响也被限制在后续的迭代中,不会像单颗树那样“牵一发而动全身”。
②风险区分度极致化:该算法主动地、层层递进地识别出数据集中风险最高的子群。第一棵树捕捉全局最危险的客群,移除后,第二棵树则在剩余客户中寻找“次危险”客群,如此往复。这使得最终输出的规则集对客户风险的排序能力(即模型的Ordering Power)非常出色,客群间违约率梯度明显。
③业务可解释性与策略亲和力:输出的规则集R是一个天然排好序的“风险客户清单”。策略人员可以像阅读一份诊断报告一样,清晰地看到:“具备特征A和B的客户,风险最高;排除他们后,具备特征C和D的客户风险次之……”这为制定差异化的审批、额度、定价策略提供了极其直接、透明的依据。
④适用于智能风控中的客户分群:传统聚类算法(如K-Means)分群结果往往与风险关联不强,而该算法直接以“识别风险差异”为目标进行分群,实现了风控视角下的“无监督”分群向“有监督”分群的跨越,完美契合了策略人员制定客户分群标准的需求。
三、应用:中原银行原e贷PLUS产品中的实践
2022年6月10日,中原银行创新推出原e贷PLUS,主打面向机关事业单位、央国企、上市公司等优质单位员工的纯信用贷款。该产品采用单位白名单准入机制,具有审批速度快,授信额度高,手续资料简的优点。自推出以来,产品快速发展的同时保持了较低的不良率水平,近两年平均增长率高达78%,已成长为中原银行消费信贷业务的核心产品,也是全行首款规模突破百亿元的自营个人信用类贷款产品。
然而,随着原 e 贷 PLUS 业务的持续推进,客户数量不断积累,业务数据日益丰富,早期冷启动时制定的授信策略逐渐暴露出诸多不足。
一是授信系数维度单一。授信系数主要依据单位性质设定,过度依赖单位背景,一定程度上忽略了客户本人的综合资质和风险水平。在实际业务中,不同单位的员工,即使单位性质相同,其个人收入稳定性、信用记录、负债情况等可能存在很大差异,授信系数无法准确反映这些个体差异,导致额度适配性和风险差异性不足,可能出现高风险客户获得高额度授信,而低风险优质客户额度却未得到充分匹配的情况,增加了潜在风险。
二是单位分层较粗。原有的单位分层体系不够精细,层级之间区分不明显。不同层级单位在行业地位、经营稳定性、发展前景等方面存在差异,对员工的收入保障和风险承担能力也有不同影响。但较粗的单位分层无法有效体现这些差异,使得在授信决策时无法针对不同层级单位的员工制定差异化策略,影响了授信的精准度和合理性。
为解决这些问题,我们启动了授信策略重构的项目,秉持“人”和“单位”并重的授信理念,对授信策略进行全面优化。引入递归样本删除决策树算法用于“人”的资质分层,取得了良好效果(授信策略见图2)。
 图2 授信策略示意
一是构建客户风险分群模型。利用MOB13的表现样本,运用递归样本删除决策树算法,对大量客户数据进行深度分析和挖掘。该算法充分发挥其优势,能够深入挖掘客户数据中的潜在风险特征和模式,将客户按照风险程度进行精准分群。与传统专家分群相比,不仅保持了规则明确、解释性强的优点,便于风控人员理解和操作,同时还具备极强的风险区分能力,能够清晰地区分不同客群之间的风险差异,使各客群之间违约率差异性明显,为后续制定差异化授信策略提供了有力依据。
二是完善单位分层分类体系。重新制定了一套全新的单位分层分类体系,对单位进行了更细致的划分,细化出16个一级分类、82个二级分类。组织大量人力对存量4万多个准入单位的层级进行全面梳理,确保每个单位都能准确归类到相应层级。通过这一举措,能够更准确地评估不同单位的风险水平和员工的信用状况,为授信决策提供更精确的参考。
递归算法分群结果具有清晰的逻辑、良好的业务解释性以及风险排序性
 图3 客户分群违约率情况
客户分群违约率情况如图3所示,新策略在平均额度几乎不变的情况下,取得了显著成效,预测违约率降低20%。这一成果充分展示了递归样本删除决策树算法在实际应用中的强大威力,以及新授信策略的科学性和有效性。通过精准的客户风险分群和细致的单位分层分类,中原银行能够更准确地识别风险,合理分配授信额度,在有效控制风险的同时,提升了业务的整体质量和效益,为原 e 贷 PLUS 产品的持续健康发展奠定了坚实基础。
四、创新:金融发展的永恒动力
递归样本删除决策树算法在中原银行原 e 贷 PLUS 产品中的成功应用,为金融机构在风险管理和业务发展方面提供了宝贵的经验和借鉴。从实际应用成果来看,该算法助力中原银行有效解决了原 e 贷 PLUS 授信策略中存在的问题,实现了风险与收益的平衡优化。通过精准的客户风险分群和细致的单位分层分类,银行能够更深入地了解客户特征和风险状况,从而制定出更具针对性和科学性的授信策略。
在金融科技飞速发展的时代背景下,传统的风险管理模式和业务策略已难以满足市场变化和客户需求。金融机构必须勇于突破传统思维的束缚,积极引入新的技术和理念,开展业务创新。思维创新为业务创新提供了方向和动力,促使金融机构不断探索新的风险管理方法和业务模式,以适应复杂多变的市场环境。业务创新则是将思维创新转化为实际行动,通过具体的产品和服务优化,提升金融机构的核心竞争力。递归样本删除决策树算法的应用,正是中原银行在思维创新的驱动下,积极探索智能风控新技术,实现业务创新的生动实践,为银行带来了显著的经济效益和市场竞争力提升。
展望未来,智能风控算法在金融领域的发展前景极为广阔。随着大数据、人工智能、区块链等新兴技术的不断发展和融合,智能风控算法将不断进化和完善,为金融机构提供更强大、更精准、更智能的风险管理工具。在技术发展趋势方面,一方面,算法将更加注重对多源异构数据的融合处理,不仅包括传统的金融交易数据,还将涵盖更多的非结构化数据,如社交媒体数据、物联网设备数据等,从而更全面地刻画客户画像,深入挖掘潜在风险;另一方面,深度学习、强化学习等人工智能技术将在智能风控中发挥更大作用,实现风险预测和决策的自动化、智能化,实时根据市场变化和客户行为调整风控策略。返回搜狐,查看更多