文章来源:计量语言学
大语言模型的兴起,正挑战传统语言学的认识论基础,揭示了语言本质上是一个数据驱动的概率系统。当语言学家精心打造的“规则大船”,在真实世界的语料浪潮中风雨飘摇时,大语言模型已通过概率建模,在深海中破浪前行。从“人为立法”到“万象寻律”,这场语言学研究的范式转型,已势不可挡。近日,刘海涛教授在《当代外语研究》(2026年第1期)上发表了题为《当“特征”不再是符号:大语言模型引发的语言学变革》的文章。 文章从语言学核心概念“特征”切入,深入探讨了大语言模型兴起背景下语言学研究范式的根本转变。原文论述宏阔,本期推文特摘取原文主要观点,以飨读者。
过去七十年里,人工智能潮起潮落,在前五十年里基本没有引起大众的关注,直到最近才开始进入万众瞩目阶段,取得了前所未有的成功,至今热度不减。这一轮人工智能之所以“起飞”,并不是因为人类在知识获得、表征与使用等领域取得了重大突破,而是得益于大数据和深度学习的加持。语言是人类智能的窗口,也是这次数智革命的引爆点和数智体破解人类软件系统的切入点,以致“大语言模型”已几乎成为“人工智能”的同义词。
当机器通过海量数据训练获得了接近人类的语言能力,而语言学家却无法解释其内在机制时,学科存在的合法性便会遭遇根本性质疑,传统的语言观和语言学方法论必然面临重构。这种范式转变的内核在于:突破点不在于我们“理解”了知识,而在于我们用计算重构了知识——大数据与算法的合力,替代了对人类认知本质的追问。更关键的是,智能已不再依附于生物躯壳,它在数字维度形成了独立的知识表征体系。这不仅是技术的异军突起,更是语言学认识论的彻底重写。
诺贝尔奖和图灵奖双料得主、数基智能的奠基人之一辛顿将大模型理解语言的过程总结为:特征→握手→结构。然而,在理论和计算语言学中,这种基于特征合一(握手)的理论与语言分析方法并不陌生,但却从未达到大语言模型的高度。同样是基于特征,为什么大语言模型可以,而此前那些基于特征的语言处理系统的效果却不尽人意呢?我们习以为常的“特征”概念是否依然成立?还是说,我们对“特征”的理解本身亟需重构?本文并非简单回答“大语言模型是否基于特征”的问题,而是力图揭示:在大语言模型中,“特征”本身的定义、获取方式、交互机制与表征形态均已发生根本性转变。要理解这场变革的深度,首先必须直面传统特征理论在真实语言面前的局限。当语言的复杂性远超预设规则所能覆盖的范围时,基于符号的特征系统便难以为继。
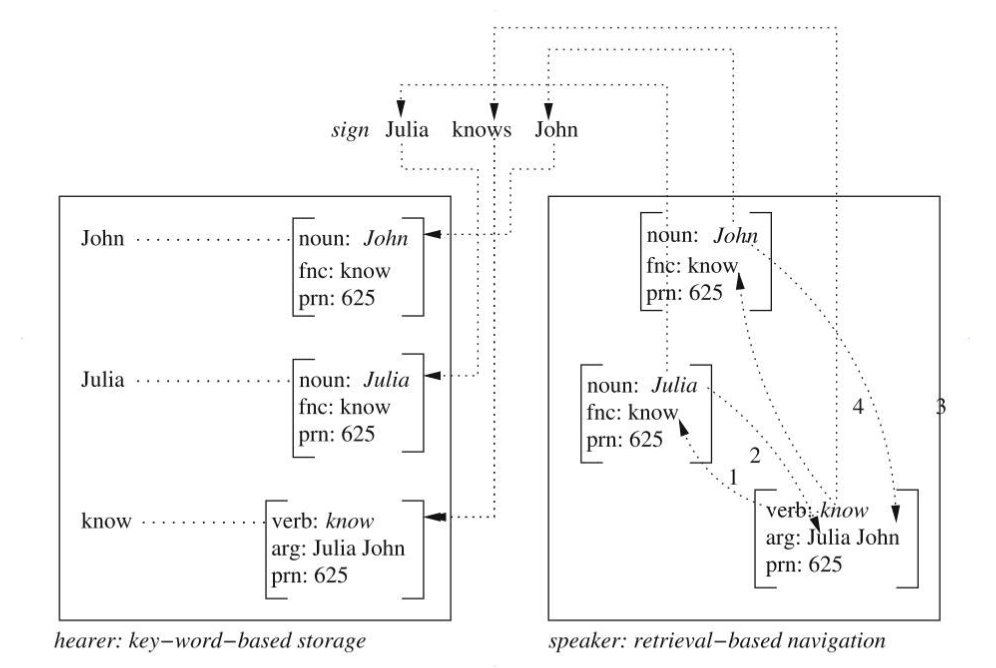
自然语言交流示意图(引自Hausser 2017: 435)
我们正站在一个语言学悄然转身的临界点上。过去半个多世纪,语言研究的主流范式围绕着“特征”这一核心概念展开——它被写成[+复数]、[−宾格]、[+完成体]这样一组组离散、明确、人工定义的符号标签,像一张张精准的身份证,贴在每个词、每个短语甚至每个句法节点身上;再通过“合一”“约束”“选择”等逻辑操作,让这些标签彼此匹配、相互推导,最终生成合乎语法的句子。这套蓝图曾寄托了无数希望:它结构精巧、逻辑严密,被视为通往自然语言理解的终极密钥。然而,现实却反复敲响警钟——规则的围墙愈筑愈高,系统愈发臃肿,却在真实语境的冲击下节节败退:面对层出不穷的新词、幽微的隐喻、微妙的歧义或辛辣的讽刺,这套僵化的系统显得捉襟见肘。人们终于意识到,或许并非模型不够聪明,而是我们从一开始就试图用枯燥的几何线条,去捕捉流动的语言生命。
大语言模型的出现,并没有否定“特征”的重要性,却彻底改变了它的存在形态。它不再是一串由人精心设计、写在纸上的符号,而是一组高维、稠密、连续的浮点数向量——每一个维度都没有独立的语义名称,但整体构成一个精微的语义坐标系。同一个词,在不同上下文中会激活完全不同的向量:“苹果”出现在“苹果手机”里,和出现在“苹果派”里,虽然书写相同,但在模型内部却是两个截然不同的“人”。这种差异不是靠人去标注,而是模型从万亿词的真实语料中自动学会的——它记住了“苹果”和“iPhone”“芯片”“发布会”高频共现,也记住了“苹果”和“烤箱”“奶油”“肉桂”经常一起出现。语义不再是抽象的定义,而变成了空间中的位置;关系不再是逻辑上的蕴含,而成了几何上的距离与方向。更奇妙的是,“国王减[男人]加[女人]约等于[女王]”这样的类比运算,在向量空间里也是基本成立的。这不是程序员硬编码进去的,而是统计规律在高维空间中自然浮现的结果。换言之,模型从未试图去“定义”性别,却在海量的使用语境中,通过数值映射精准捕捉到了性别的逻辑脉络;它从未“背诵”过语法教条,却在词频共现、依存强度与语境分布的交织中,内化了远比教科书更细腻、灵动且富有弹性的语言直觉。
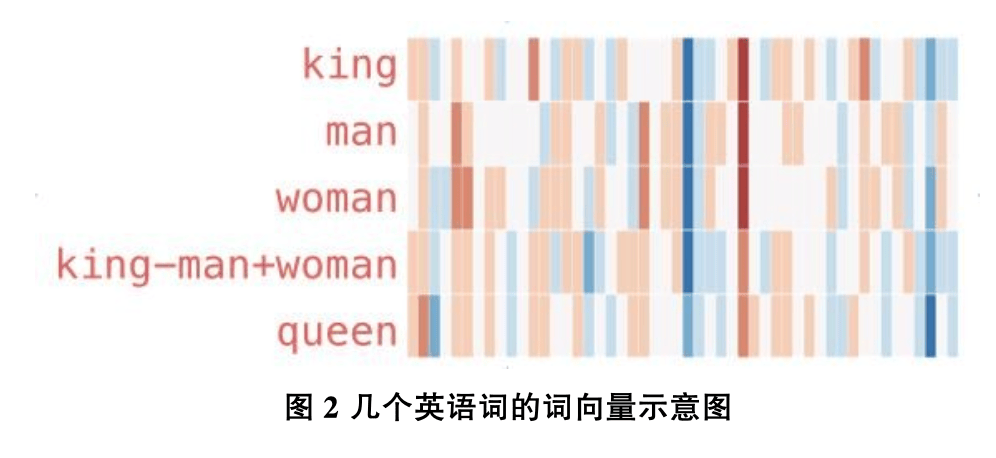
几个英语词的词向量示意图(引自:https://jalammar.github.io/illustrated-word2vec/)
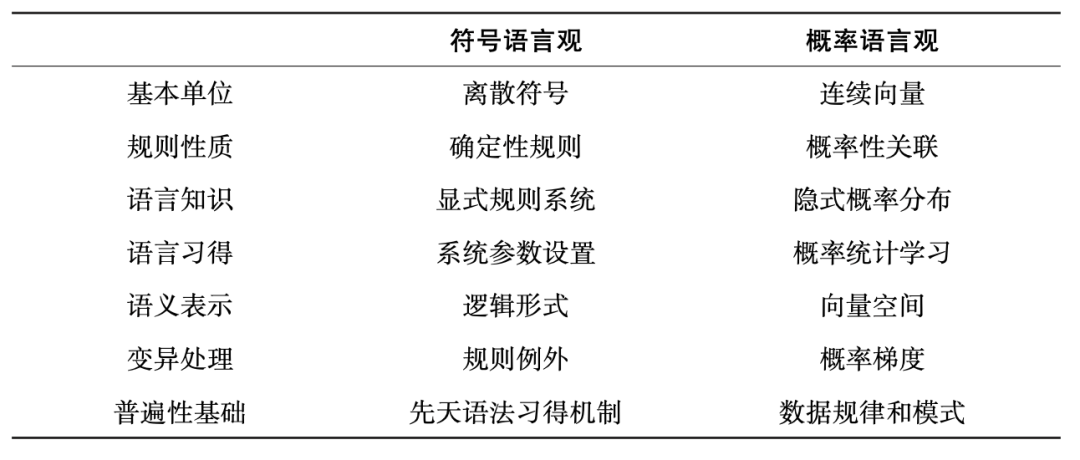
这一转变背后,是对语言本质的重新确认:语言从来就不是一个由绝对规则构成的静态系统,而是一个动态的、概率性的、高度依赖上下文的有机体。我们说一句话是否自然,不是因为它符合某条语法规则,而是因为它在人类千万次实际使用中反复出现过;我们听懂一个隐喻,不是靠拆解它的逻辑结构,而是因为“火焰”和“激情”在语言使用中长期高频关联,已在我们的认知中形成了稳定的相似性映射。索绪尔早说过,“语言是言语的平均数”,这句话在今天有了技术意义上清澈的回响——大语言模型正是以整个互联网规模的“言语”为原料,训练出了最接近人类“语感”的概率分布。它不需要先天语法模块,只需要足够多的真实语言输入;它不靠内省直觉,而靠统计归纳;它不追求“非黑即白”的正确性,而拥抱“或高或低”的可能性。语言的合法性,不在书本里的规则清单上,而在亿万普通人日复一日的说话、写作、阅读之中。
对中国语言学而言,这更是一次前所未有的历史契机。长期以来,我们在形式语法、生成理论等主流框架下,常常处于追赶与阐释的位置;但在数据驱动的新范式里,游戏规则被重写了。我们拥有全球最丰富、最多样、最活跃的中文语料资源,有深厚的计量语言学传统,有一大批既懂语言又懂技术的跨学科人才。当西方学者还在争论“递归是不是人类语言的本质”时,我们的团队已用实证表明:真正具有跨语言稳定性的,是那些隐藏在真实使用频率、搭配强度、句法偏好背后的概率模式。这种基于数据的发现,不依附于任何既有理论权威,它直接来自语言本身——来自微博、微信、古籍数据库、方言录音、课堂实录、新闻语料……来自活生生的语言实践。这意味着,我们不仅能参与这场范式革命,更有可能成为其中的关键定义者和引领者。
符号语言观与概率语言观的对比
语言学正站在一个历史转折点上。大语言模型的兴起并非宣告传统语言学的终结,而是暴露了现有理论在处理真实语言复杂性时的方法论瓶颈,旨在呼唤一场方法论与认识论的深刻转变。从“制定规则”转向“发现规律”,从“解释个体直觉”走向“建模群体行为”,语言学正迈向一个更加开放、实证与跨学科的新阶段。面对这一转变,语言学家不应退守象牙塔,也不必畏惧技术冲击,而应主动成为人机智能之间的桥梁、迎接这场方法论的转变———走向数据驱动的语言学。这一新范式不否认理论的重要性,但强调理论必须建立在对真实语言使用的观察之上。当“特征”不再是符号,语言学的未来也不再是封闭的体系建构,而是一场持续开放的探索。唯有如此,语言学才能在智能时代重获其应有的科学地位。在这条通往理解“智能”的道路上,人们或许终将明白:人类语言最深层的秩序和规律,并非语言学家头脑中的抽象规则,而是源于亿万次真实语言交流所形成的统计之流。返回搜狐,查看更多